一组输入与响应可以用来估计关系,也需要计算不确定性和检查模型。很小的 p 值只回答其中一个检验问题,无法代替其余分析。
这里使用正态抽样理论、区间估计、检验和基本向量运算。最小二乘的系数解会连接到残差自由度与精确 t 分布,由此构造平均响应和新观测的区间,完成可以复算的报告。
1. 数据产生方式与线性模型
考虑固定设计的一元线性模型
Yi=β0+β1xi+εi,i=1,…,n,
其中 xi 是已给定的设计值,至少有两个不同取值;误差独立且服从 N(0,σ2),σ2>。这里响应独立,但由于均值随 变化, 通常不同分布。应说“误差独立同分布”,而不是不加区分地说所有响应 iid。
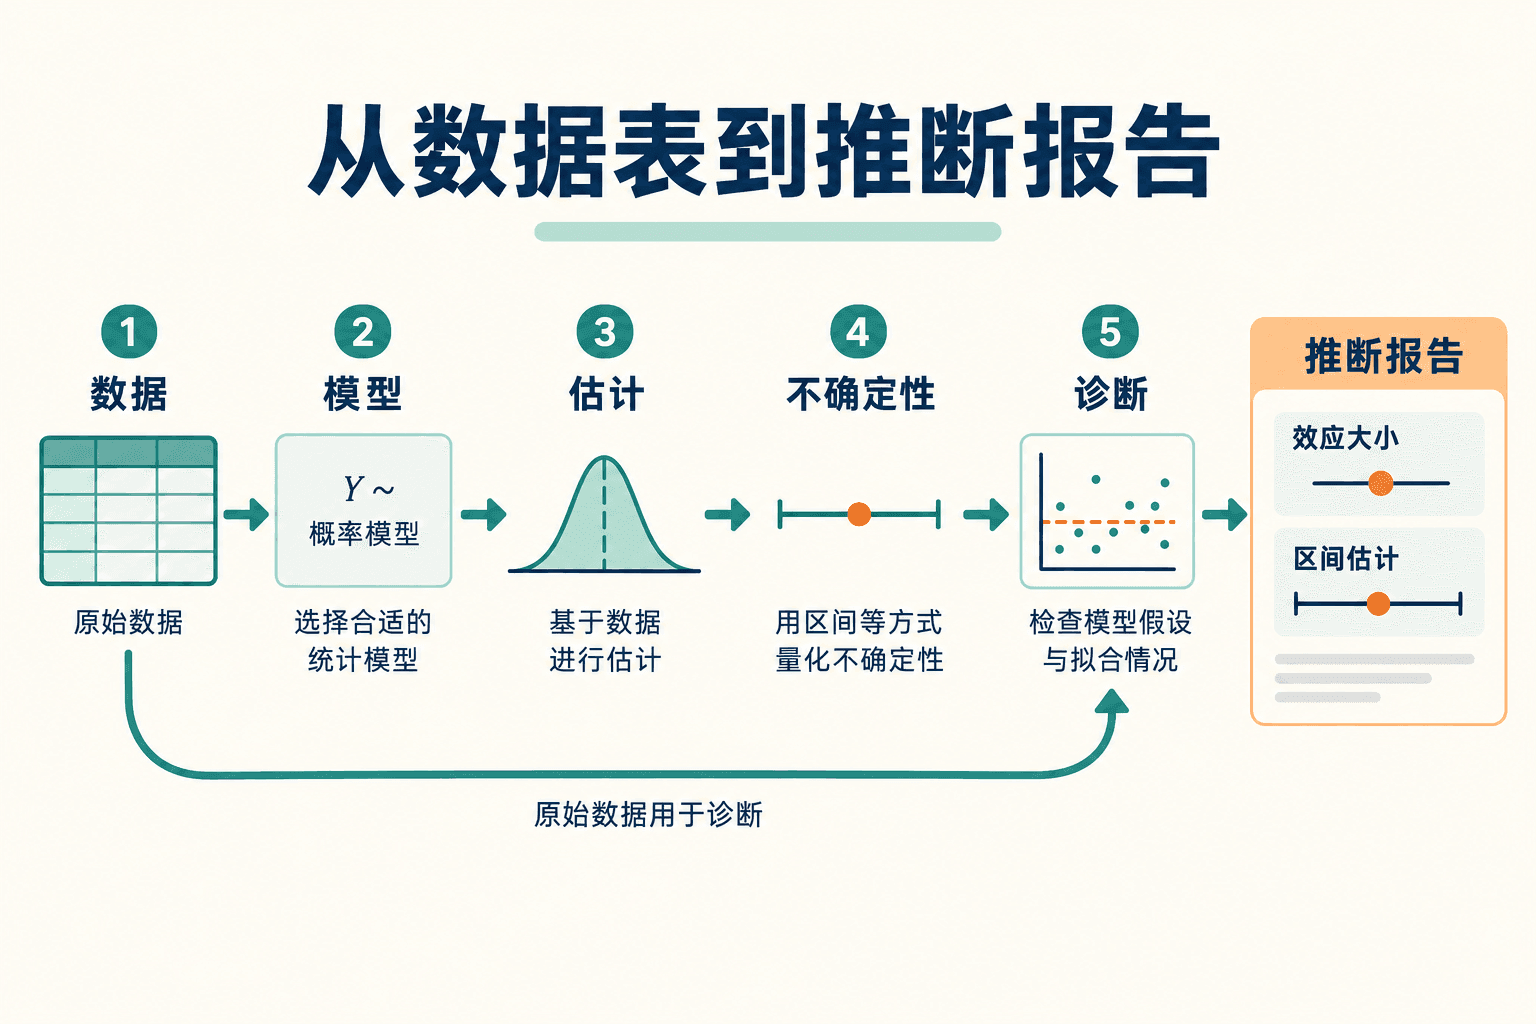 图 12-1:从数据表到推断报告
要估计的参数包括截距 β0、斜率 β1 和噪声方差 σ2。其中 表示设计值增加一单位时,模型中的平均响应改变多少。拟合出一条线,还不能说是因果关系;若要这样解释,需要实验设计或其他排除混杂的依据。
下面使用一组教学构造数据,供完整复算,不代表真实研究测量。 x 为设定输入, y 是响应读数,各自采用任意教学单位。
分析目标在看结果前确定:研究平均响应与输入的关系,并在 x0=2.5 处估计平均响应及预测一个新的独立响应。限定这些目标,可以避免反复换问法后只留下有利结果。
平均线与新响应的不同不确定性
这些数据可以用来估计平均响应随输入的变化。平均线的位置有估计误差,下一个新响应还会带上自身的波动。使用同一个模型,并不意味着两种任务共用同样的误差范围。
把所有响应加上 10,图形会整体平移;只抬高最右边的一个点,则改变了点之间的关系。可以据此判断斜率与残差各会怎样变化,稍后用计算核对。
2. 最小二乘与最大似然在这里相遇
在独立同方差正态误差假设下,对数似然中关于回归系数的部分为
−2σ21∑i=1n
所以无论给定哪个正的 σ2,最大化它都等价于最小化残差平方和。记
xˉ=n1∑xi,
Sxx=∑(xi−
对平方和求两个偏导,得到正规方程 ∑ei=0 和 ∑xiei=。解得
β^1=S
其中 ei=yi−β^ 是残差。 保证斜率可识别;若所有 相同,只能估计那个设计点的均值,无法把截距与斜率分开。
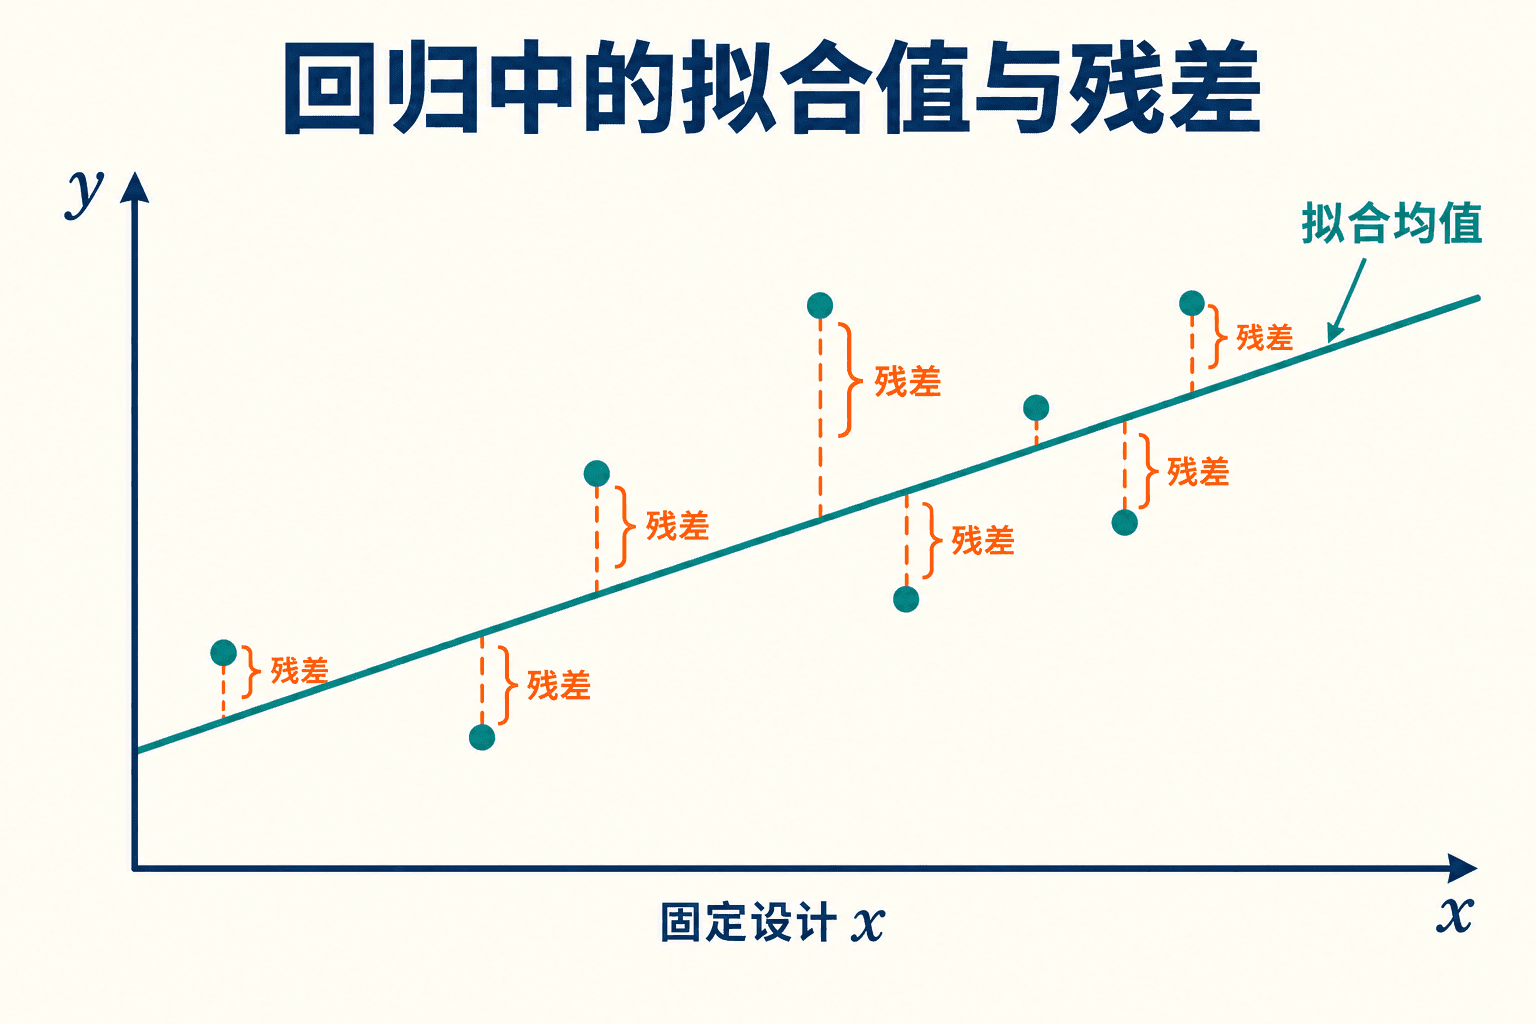 图 12-2:回归中的均值与残差
图里有两种距离,要分开读: εi 到真实均值线,通常看不见; ei 到拟合线,能直接算。残差受两个正规方程共同约束,所以误差即使独立,残差一般也相关。图中的线表示拟合均值,竖着标出的距离才是残差。
教学数据有 xˉ=2.5,yˉ=19/6,Sxx,于是
β^1≈0.942857,β^0
拟合线应经过 (xˉ,yˉ),这是一个方便的核对。截距表示 x=0 处的平均响应,若 0 远离设计范围,其解释便涉及外推。
最小二乘解的全局唯一性
任取候选直线 a+bx,记 Syy=∑(yi−。与全部候选比较,才能证明刚才求出的驻点是唯一全局最小值。
每个误差可围绕样本中心重写为 yi−a−b。前两个中心化部分各自和为零,展开平方求和后,它们与最后常数的交叉项消失。
到这里只用了平方和代数,没有要求误差正态。要把最小二乘叫作最大似然,或要精确 t/F 分布,才用到正态假设。所以公式能算,并没有自动替你证明后面的推断保证。
实验:重心约束与斜率优化
经过点群重心只满足了一个约束。结合前面的平方和分解,判断直线是否还能通过转动降低 SSE。
截距与斜率都可以调整。“对齐重心”消去中心偏移,“沿 x 方向投影”用于优化斜率。残差坐标可以显示两条约束;改变一个观测,观察它们如何随拟合一起变化。
对齐重心只让 Σr 变成零;斜率也完成投影后,Σxr 才为零,候选 SSE 这时等于 OLS SSE。
展开式给出原因:候选 SSE = 最小 SSE + n[a+bx̄−ȳ]² + Sxx(b−b̂)²。后两项都非负,同时消去才达到全局最小;对应的残差也与回归空间正交。
3. 一般设计矩阵中的最小二乘
矩阵写法 Y=Xβ+ε 中,X 为 n×q 的已知设计矩阵,每一列是一项已知输入特征;β 有 q 个未知回归系数。这里的“线性”针对系数,不要求响应对原始输入画成直线。例如取三列 ,依然是对 的线性模型。
假设列秩为 q<n。平方损失为 (Y−Xb)⊤(Y−Xb),对 b 求导给 。因为对任意非零向量 ,,矩阵 正定可逆,所以
β^=(X⊤X)−1X⊤Y.
用 e=Y−Xβ^,正规方程给 X⊤e=0。任何候选 的残差可写为 ;两部分内积为零,因此
∥Y−Xb∥2=∥e∥2+∥X(β
后项只在 b=β^ 时为零,唯一全局最小由此得到。若列不满秩,存在非零 a 使 Xa=0,那么 b 与 拟合完全相同。此时投影仍可唯一,全部系数却无法区分。软件打印了一个组合,也没让数据多出识别这些参数的信息。
投影矩阵的作用
定义 H=X(X⊤X)−1X⊤。它满足 H:投影后再投影不改变结果。拟合为 ,残差为 。 保证模型均值留在拟合空间, 保证残差中不含真实均值方向。
4. 残差空间与 n−2 个自由度
令 X 为第一列全为 1、第二列为设计值的 n×2 矩阵。满列秩时,拟合向量是 Y 向二维列空间的正交投影,残差在它的正交补中,维数为 n−2。
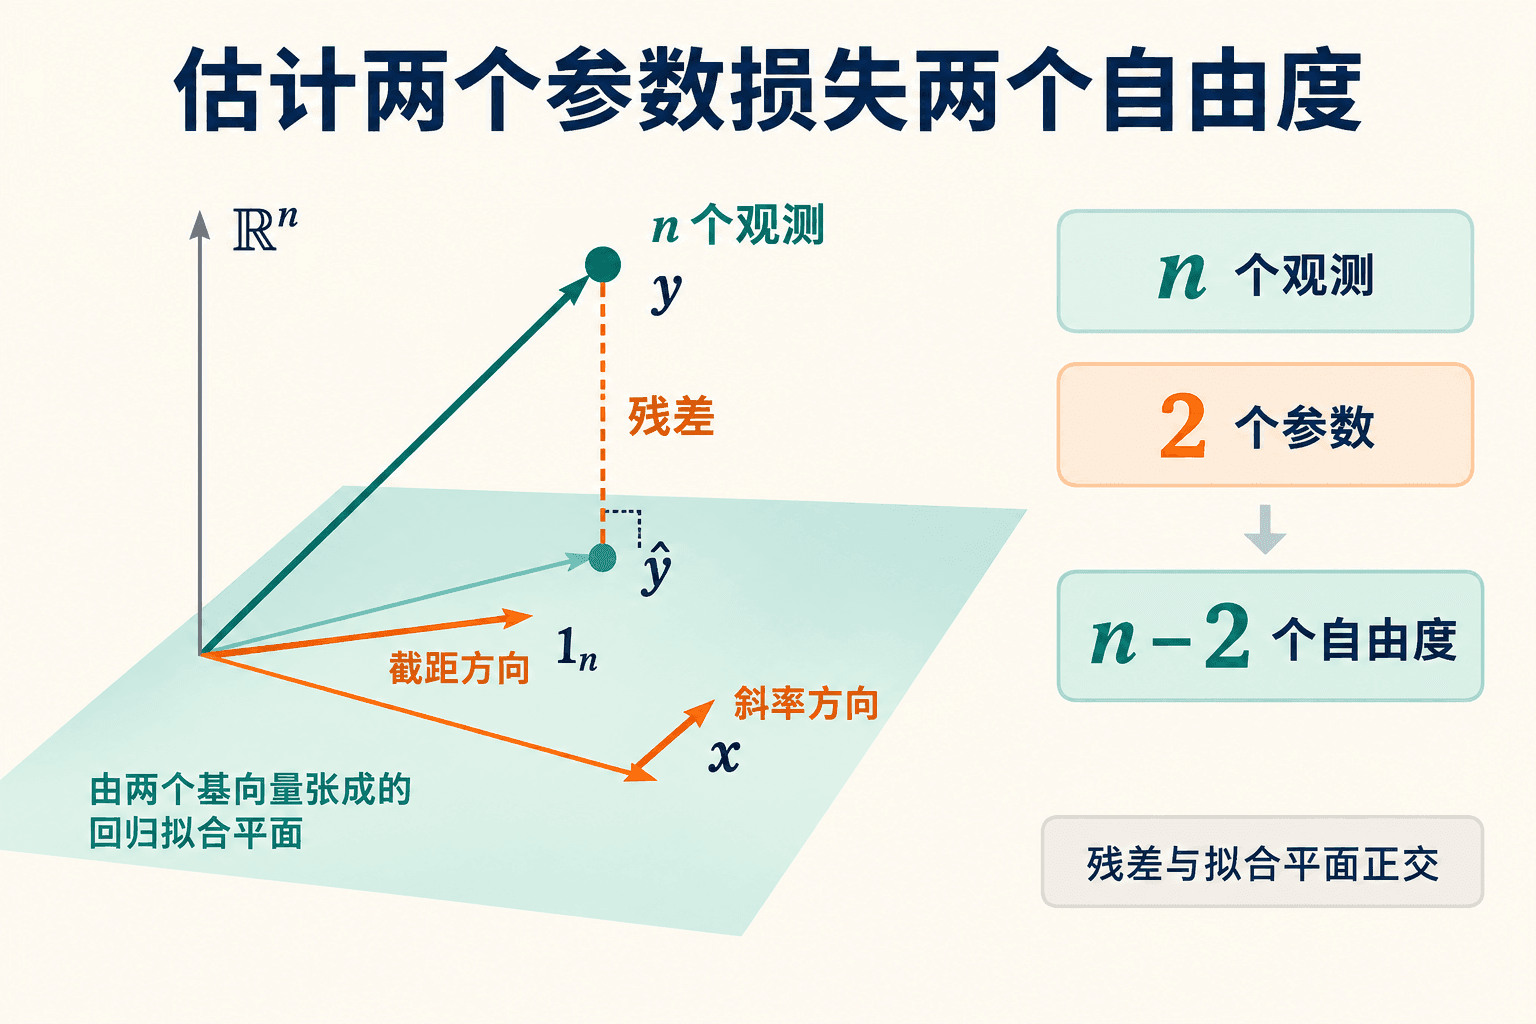 图 12-3:估计两个参数损失两个自由度
对设计的 q 个独立列作正交化:每列扣除已有方向的投影并归一化,得到标准正交基 u1,…,uq。补齐后形成 Rn 的完整正交基,标准化误差坐标记为 。第 2 章的 Jacobian 与联合密度证明保证,变换后的 仍是独立标准正态。
模型均值 Xβ 在前 q 条方向中,因此残差只保留后 n−q 个坐标,
e=σj=q+1∑nZ
系数误差为 (X⊤X)−1X⊤ε。后 n−q 个坐标都与 X 的每一列正交,所以这个表达式只用前 q 个坐标,残差则用后面一组。这样得到的是系数估计与完整残差向量独立,不只是某个协方差为零。
再令 A=(X⊤X)−1X⊤,有 AX=I。线性变换正态给
E(β^)=β,Cov(β^)
并且 β^ 有这个均值和协方差的精确多元正态分布。一元含截距直线对应 q=2,因此残差自由度为 n−2;二次均值模型通常为 q=3,依此类推。
定义 s2=SSE/(n−q)。由卡方均值得无偏性。如果误差只有零均值、同方差且不相关,利用 E(εε⊤)= 也可求得 ;正态独立性与精确分布却不再由这些弱条件保证。迹 是对角元素之和,这里等于投影保留的方向数。
残差的协方差矩阵为 σ2(In−H),第 i 个方差是 σ2(1−,两个不同残差的协方差是 。现在你能看见,为什么不能把残差当作新的一份 iid 原始样本:它们共享拟合约束,方差还随设计位置变化。
本例 SSE≈1.276190,s2≈0.319048,残差标准差 s≈0.564843。正态似然给方差的最大似然估计则是 SSE/n,与这里用于无偏估计及 推断的 SSE/ 不同。
由 β^1 是响应的线性组合,可算出
Var(β^1)=
结合正态分子、独立卡方尺度,得到
s/Sxx
5. 斜率的区间与检验
斜率的双侧 1−α 置信区间为
β^1±t1−α/2,n−2
本例自由度为 4,标准误约 0.135023,95% 临界值约 2.776445,区间为
[0.567972, 1.317742].
检验 H0:β1=0 对双侧备择,得到 t≈6.982922,双侧 。模型成立时,数据与零斜率不太相容。斜率估计本身则表示输入每增一单位,平均响应增加约 0.943 单位。证据与效应大小是不同信息,都需要报告。
若把含截距的零斜率模型与完整直线模型比较,还可写
F=SSE1/(n−2)
这里只有一个斜率约束,所以 F=t2。两种计算来自同一投影分解,不能当作两份独立证据,也不能再组合两个 p 值来增强显著性。
一般线性对比:多个系数一起决定一个目标
对事先指定的非零向量 c,目标 τ=c⊤β 的估计为 τ^=c。正态线性组合和上一节的协方差给其方差 。它又与残差尺度独立,所以
sc⊤(X⊤X)−1c
这样,单个斜率、两个系数之差、某处平均响应都能用同一个表达式处理。如果目标为 β1−β2,方差里必须有 −2Cov(β。只把两个标准误相加,会漏掉它们一起变化的关系。
多个限制的额外平方和检验
设零模型的列空间包含于完整模型,维数分别为 q0<q,记投影为 H0,H,残差平方和为 。包含关系给 ,所以 也是正交投影,保留新加的 个方向;它与 的乘积为零。
零假设下真实均值在零模型中,新方向和完整残差方向都只包含误差。旋转到这两组正交方向,分别得到独立的 χr2 与 χn−q2,从而
σ2SSE
分子量出限制损失了多少拟合,分母用余下波动估同一噪声尺度。独立性来自正态误差在两组正交方向上的分解,两个平方和非负本身还不够。零斜率与完整直线比较时, r=1,新增平方和是 β^12Sxx,除以 刚好为 ,也就证明了前面的等价关系。
6. 平均响应区间与预测区间
给定一个预先指定的 x0,平均响应为 m0=β0+β,估计为 。令
h0=n1+
为求出 h0,可将 m^0 重写成 。均值误差的权重为 ,斜率权重为 ,二者协方差 ,所以方差相加得到 。正态模型下这两部分还独立,但此处求方差仅需协方差为零。
故平均响应的区间为
m^0±t1−α/2,n−2s
如果要预测在 x0 处一个新的、与原样本独立且来自同一模型的响应 Ynew,还必须加入新误差的方差 σ2,于是预测区间变为
m^0±t1−α/2,n−2s
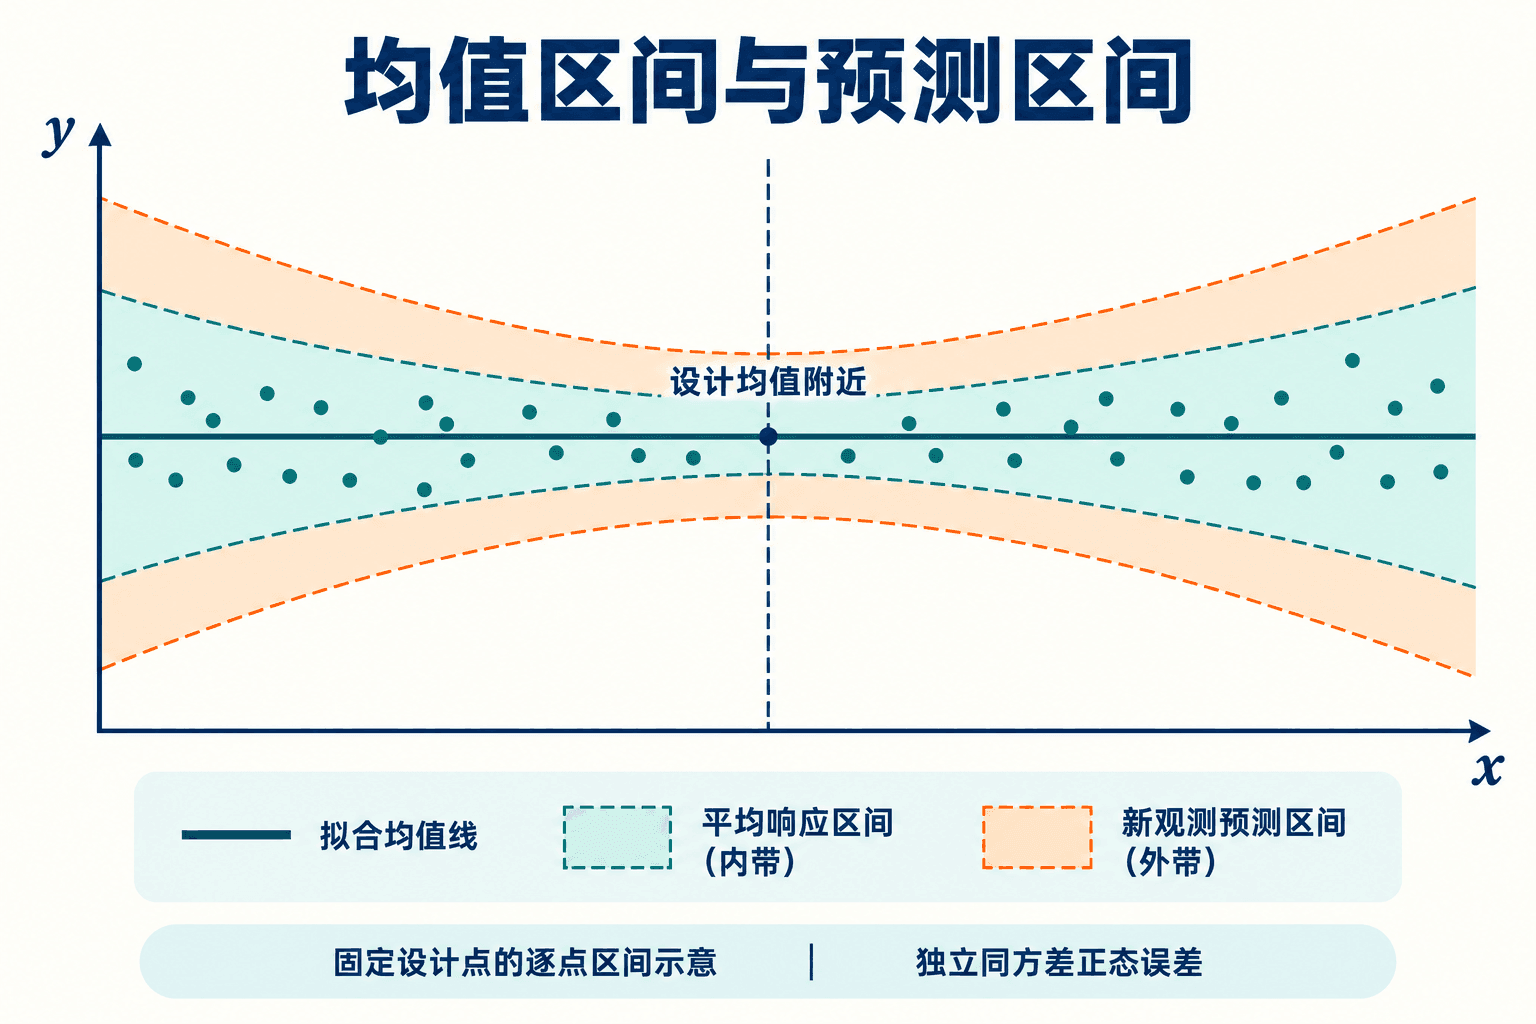 图 12-4:均值区间与预测区间
图中用一条斜率为零的拟合线说明宽度变化,并非这组教学数据的实际拟合结果。带状区域也要逐点读:每个固定输入处各有一个区间,不能直接解释成覆盖整条曲线的同时置信带。
多出来的 1 是新个体自己的噪声。哪怕平均线已经估得很准,下一个观测仍会波动。因此同一个 x0 和置信水平下,预测区间更宽;两类区间都在设计均值附近最窄,离 xˉ 越远越宽。
本例 x0=2.5 时,m^0=3.166667。95% 平均响应区间约为 ,新观测预测区间约为 。这些是:把很多点的区间画成带状,并不自动获得“整条真实曲线同时有 95% 覆盖”的保证。超出 至 5 的范围还涉及外推,单靠公式变宽不足以排除模型变化。
新观测自身的误差项
在新位置 x0,写 Ynew=m0。用 预测它,误差是
Ynew−m^0=
新观测独立于拟合数据,所以两项协方差为零。第一项方差 σ2,第二项方差 σ2h0,总共 σ。即使平均线已估得几乎完全准确,第一项还在;训练样本继续增加,也不能把单个新观测的预测区间压成零宽。
在 x0=xˉ 处, h0=1/n 最小。往两边走,距离 会放大斜率的不确定性,所以区间逐渐张开。但出了设计范围,均值可能不再线性。公式虽还能算,带子变宽也没替你验证外推。
单位变化提供了另一个核对:全部 x 乘 2, Sxx 乘 4,斜率及其标准误均减半,t 值不变。换单位不会产生新证据。增加设计范围或独立测量才可能提高斜率精度,同时需要核对扩展范围中的线性假设。
实验:均值区间与预测区间的宽度
回到样本重心,均值估计的误差最小。结合新观测仍有自身噪声这一点,判断预测区间能否与均值区间一样窄。
默认 x₀=2.5 可以对照两类区间,将位置改为 x=5 或移出设计范围,会显示斜率不确定性的影响。零残差预设用于观察代入公式的退化,恢复后可与原数据比较。
预测区间始终更宽,两带在重心最窄,但新观测还带着 σ² 的噪声。外推会增大位置项,零残差则让代入结果退化,这些变化要分别解释。
均值估计的方差是 σ²h₀,预测误差还要加上独立的新误差 ε₀,因此为 σ²(1+h₀)。界面上所有带都是固定位置的逐点区间,没有同时覆盖整条曲线的保证。
7. 残差诊断与结果报告
弯曲残差可能提示均值形式不合适。若散布呈漏斗形,应检查方差变化;沿采集顺序连续同号,则需要考虑相关性。孤立的大残差还应结合录入、测量过程和设计位置核查,不能为了缩小 p 值而删除。
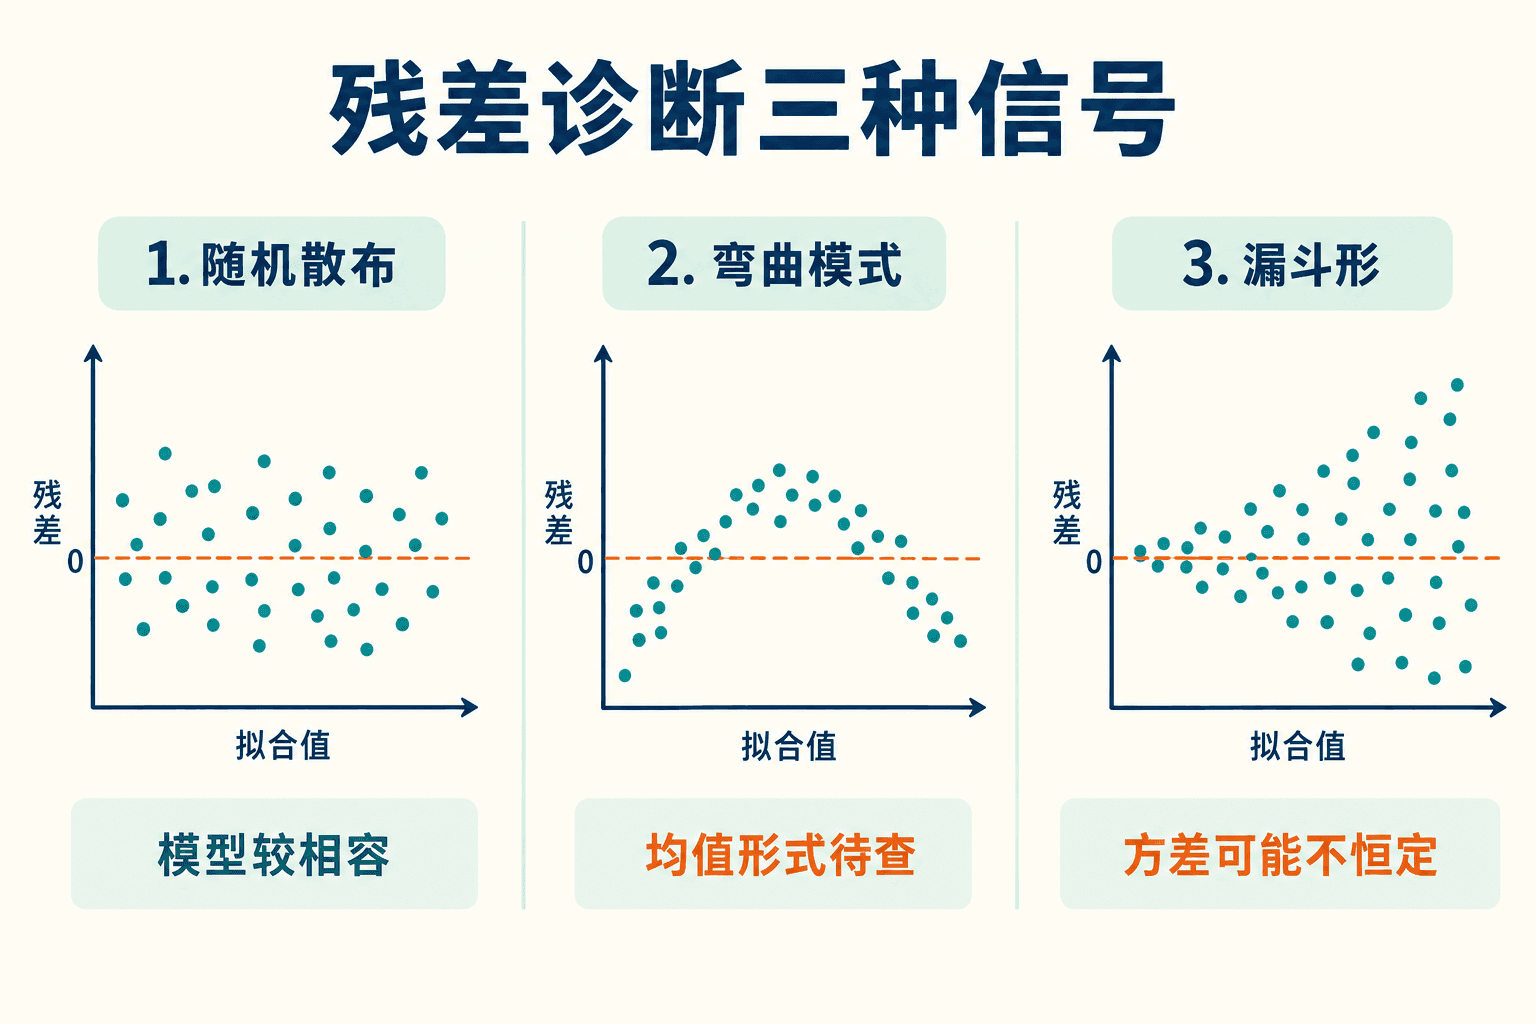 图 12-5:残差诊断三种信号
图看起来散得随机,只能说没发现某些明显冲突,还证明不了独立、正态或无混杂。这里只有六个教学点,诊断能力有限,报告要把这一点和所用的强模型假设说明。如果发现异方差或相关,标准误或模型也要随之调整,不能只改措辞。
一份可供核对的报告可以写为:
使用六组给定教学数据,在固定设计、线性均值和独立同方差正态误差假设下,拟合响应对输入的一元线性回归。斜率估计为 0.943,标准误为 0.135,95% 置信区间为 [0.568, 1.318];零斜率双侧检验的 t 值为 6.983,自由度为 4,p=0.00221。在输入 2.5 处,平均响应估计为 3.167,其 95% 区间为 [2.526, 3.807],一个新独立响应的 95% 预测区间为 [1.473, 4.861]。数据用于演示计算,样本很小,残差诊断不足以确认全部假设,也不据此提出因果结论。
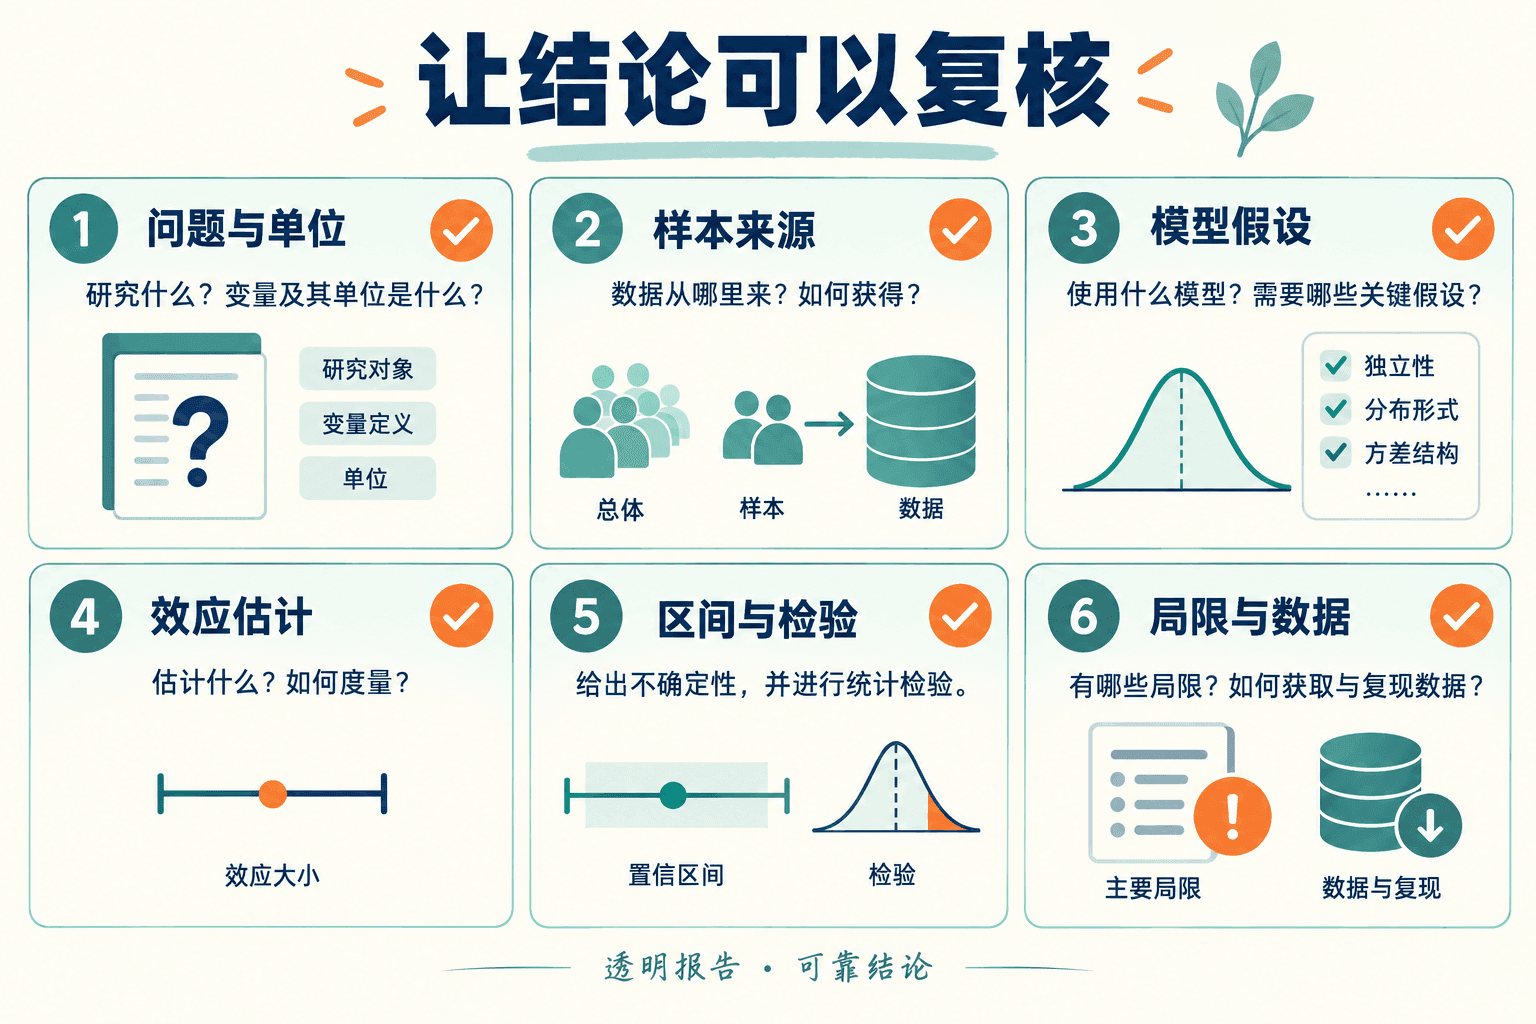 图 12-6:让结论可以复核
案例:弯曲残差与二次模型
这次用十条新的构造记录,在五个输入位置各测两次。表里成对放置只是为了好读,不代表实际采集的时间顺序。
含截距直线的拟合给出 xˉ=0,yˉ=2.6,Sxx,由此得到 ,SSE 为 18.32。各位置的成对平均残差是 ,两端为正、中间为负。这种可复算的弯曲模式提示均值结构可能有问题,全部归为更大噪声会遗漏这部分信息。
候选均值改为 β0+β1x+β2x 后,模型对系数仍然线性,可以沿用最小二乘;误差独立和共同方差的假设仍待核验。使用中心化第三列 ,三列 彼此正交,平方长度为 ,与 Y 的内积为 ,系数因而是 。
换回原始表示,拟合为
y^=2.6+2x+0.8(x2−2)=
各位置两条残差变为 −0.2,+0.2,SSE 降到 0.4。现在拟合了三个方向,残差自由度为 7, s2=0.4/7≈0.05714。分母不能继续用直线模型的 8,残差弯曲消失也不表示噪声方差为零。
若这两个候选模型在收集数据前就已指定,检验零曲率的额外平方和 F 为 (18.32−0.4)/(0.4/7)=313.6,参考分布 F1,7;二次系数标准误为 ,给定二次模型的 95% 区间约为 。这也满足单约束 ,可作交叉检查。
这个案例却是在看过残差后选择二次模型。常规 F 和区间只能作为预先给定模型时的参考计算,并未证明选择后仍有 95% 覆盖。发现应标为探索结果,在新的独立数据上按锁定模型核验,或采用专门处理选择过程的方法。SSE 下降本身不足以把探索转为确认。
解释也得跟着模型改。原始输入 x 处的局部变化率现在是 2+1.6x;从 0 到 1,拟合平均增加 2.8,从 1 到 2 则增加 4.4。报告若仍写“输入每增加一单位都增加 2”,就没有描述眼前这条曲线。
这次可以这样报告:十条教学记录的直线残差两端为正、中间为负;增加二次项后拟合为 1+2x+0.8x2,SSE 从 18.32 降到 0.4,残差自由度从 8 变为 7。这个弯曲关系值得进一步检验,但模型来自同一批残差,常规区间和检验只作条件参考,尚没有模型选择后的校准保证。下一轮采集先固定二次项和输入范围,再核对关系与误差假设。
若问题出在方差,计算也要调整
若误差独立但方差组成对角矩阵 Ω,普通最小二乘在 Eε=0 时仍无偏,其协方差却是
(X⊤X)−1X⊤ΩX(X⊤X)
上述协方差直接来自 β^−β=Aε 的 AΩA⊤。若 Ω= 且正定 V 已知,用 同时变换数据和设计,在原有正态误差条件下得到同尺度独立正态误差。对变换后的模型作最小二乘,给出加权估计 。V 未知时,估计方差结构或使用渐近稳健标准误都需额外条件,不能给十个点添上“稳健”二字就继续声称精确 t 保证。
可复算的报告需附数据表与模型,单位、检验方向、置信水平和自由度也应明确。缺失及异常的处理会影响结果,相关规则需要保留。使用随机模拟时还需记录种子和重复次数,本例没有这一步。
从计算结果回到研究对象
2小 p 值本身不能证明关系具有因果性,也不能证明模型假设成立。
310 个观测拟合一个满秩模型,模型含截距及另外 3 个系数。残差自由度是多少?
8. 综合练习:自己完成一次分析
练习 1|可逆性与识别。 三列设计为 1,x,2x,x 至少有两个值。解释参数为何不唯一、实际秩多少、拟合值是否仍能唯一。给出一对产生相同均值的不同系数组合。
后两列线性相关,实际秩为 2。(β0,β1,β2) 与 给相同均值。系数不能全部识别,但向二维列空间的正交投影唯一,故拟合值唯一。残差自由度按秩为 ,不能因表格列出三个系数就减 3。
练习 2|重建独立性。 一般满列秩设计有 q 列。用前 q 条基向量张成设计空间、后 n−q 条张成正交补,证明系数估计和 SSE 独立,并说明去掉正态假设后哪一步不能继续。
系数误差为 Aε,后组方向都被 X⊤ 消去,所以只依赖前组坐标;残差只含后组。正态误差经正交变换后的密度分解给坐标相互独立,两组函数因而独立。一般分布的旋转未必保持独立,即使协方差对角,也不足以得到 t/F 所需的独立材料。
练习 3|协方差不能遗漏。 两个系数的估计协方差矩阵为 (0.090.040.040.16)。估计值为 1.2、0.7,求差值及标准误,写自由度 12 的双侧 95% 区间。
差为 0.5,方差为 0.09+0.16−2⋅0.04=0.17,标准误 0.17。相应正态线性模型中的区间为 。把两个标准误相加,或忽略协方差,都没有计算差值的实际方差。
练习 4|同时加两个方向。 20 个观测,零模型有 2 个独立系数、完整模型有 4 个,SSE 分别为 50、30。求额外平方和 F 及两个自由度,并列出精确参考分布的条件。
F=[(50−30)/2]/[30/16]=16/3≈5.3333,零假设下为 F。条件是固定满秩设计、列空间嵌套、真实均值属于零模型、独立同方差正态误差,并且比较方案预先指定。分子方向数是新增的 2,分母是完整模型剩余的 16。
练习 5|预测的是两次未来响应的平均。 在一个固定输入点,h0=0.2,s2=4。若预测两个相互独立、也独立于训练数据的新响应的平均,预测误差标准误是多少?为何额外项不再是 1?
两个新误差的平均方差为 σ2/2,估计均值误差方差为 σ2h0,且两者独立。因此标准误为 s。额外项由单个新观测的 1 变成两个独立新观测平均的 1/2,训练均值的不确定性仍要加上。
练习 6|诊断后真的重新拟合。 保持正文第二案例的五个输入各重复两次,把十个响应全部减去 0.3x2。不用从头求逆,给出新的二次拟合、SSE、二次系数标准误,以及输入 0 到 1 的拟合平均变化。
减去的项本来就在设计空间内,因此二次系数从 0.8 变为 0.5,其他原始系数仍为 1、2,拟合为 1+2x+0.5x2。拟合和响应同步扣去这一项,残差不变,SSE 仍为 0.4,标准误仍为 (0.4/7)/28。0 到 1 的变化为 ,不是斜率系数 2 单独决定。
练习 7|已知不同精度的两条读数。 两个独立正态读数都估计同一均值,方差分别为 1、9。求逆方差加权估计、其方差,并与简单平均比较。说明需要知道的额外信息。
权重按 1:1/9 归一化为 0.9:0.1,估计 0.9Y1+0.1Y,方差 。简单平均方差 。加权优势依据正确的方差比与独立性;若权重来自同一数据的不稳定估计,需重新分析其随机性。
练习 8|改单位不该改变证据。 第一案例把每个输入都乘 100、响应不变。截距、斜率、斜率标准误、t 值、在原输入 2.5 对应位置的预测区间怎样变化?
截距不变,斜率和其标准误都除以 100,t 值不变。预测位置应同步改为 250,此处拟合响应及 h0 不变,预测区间不变。若只改输入单位却仍在数值 2.5 处预测,就已经换了实际位置。
练习 9|模型选择后的报告。 同一数据试过直线、二次、三次曲线,选 SSE 最小者,再把普通系数区间称为“选择后精确 95%”。指出缺口并给出一个可执行的下一步。
常规区间的证明以设计列和模型预先指定为条件,试过若干模型才选择,会让报告规则依赖数据。增加方向本就不会增大 SSE,不能仅凭下降确认模型。可将这一轮标为探索,锁定目标、均值形式和采集方案,用新的独立数据按预定模型核验;有依据的选择后推断也是一条路径。现有结果可以报告,但必须交代选择过程。
综合任务 10|写一份别人能复算的分析。 新教学数据为 x=0,1,2,3、 y=1,3,2,5,事先采用独立同方差正态误差的直线模型。求系数、SSE、斜率标准误和 95% 区间,比较 x 的均值区间和单个新响应预测区间。报告中再说明,只有四个点,诊断能查到什么、查不到什么。
xˉ=1.5,yˉ=2.75,Sxx,得斜率 1.1、截距 1.1。拟合值为 ,残差为 ,SSE 为 2.70,自由度为 2,。斜率标准误 ;用 ,95% 区间约为 。
报告能否被复算,取决于目标、模型和每一步计算是否交代清楚。区间与检验的条件需要能在数据设计中找到依据,残差暴露的问题也应留在解释里。换用更复杂的统计模型时,这些要求仍然适用。