均值、残差和随机尺度怎样组合,决定了统计量的抽样分布。正态样本提供了一条可以从联合密度完整推导的路线。
1. 抽样分布与重复抽样
同一组数据,偏离假设值都是 2 个标准误,报出的右尾概率却可能约为 2.3%,也可能约为 4.0%。差别出在尺度:事先已知的标准差,与这批样本估出的标准差,参与的是不同的计算规则。标准正态和 t 分布因此给出不同答案。理解这一步,需要从正态观测的均值和残差开始。
换一批样本,用同一规则重新计算,统计量的结果通常会变化。它在重复抽样中的概率规律叫作抽样分布。原始观测的分布是另一个对象,手中这一批数据的经验分布也不能代替它。
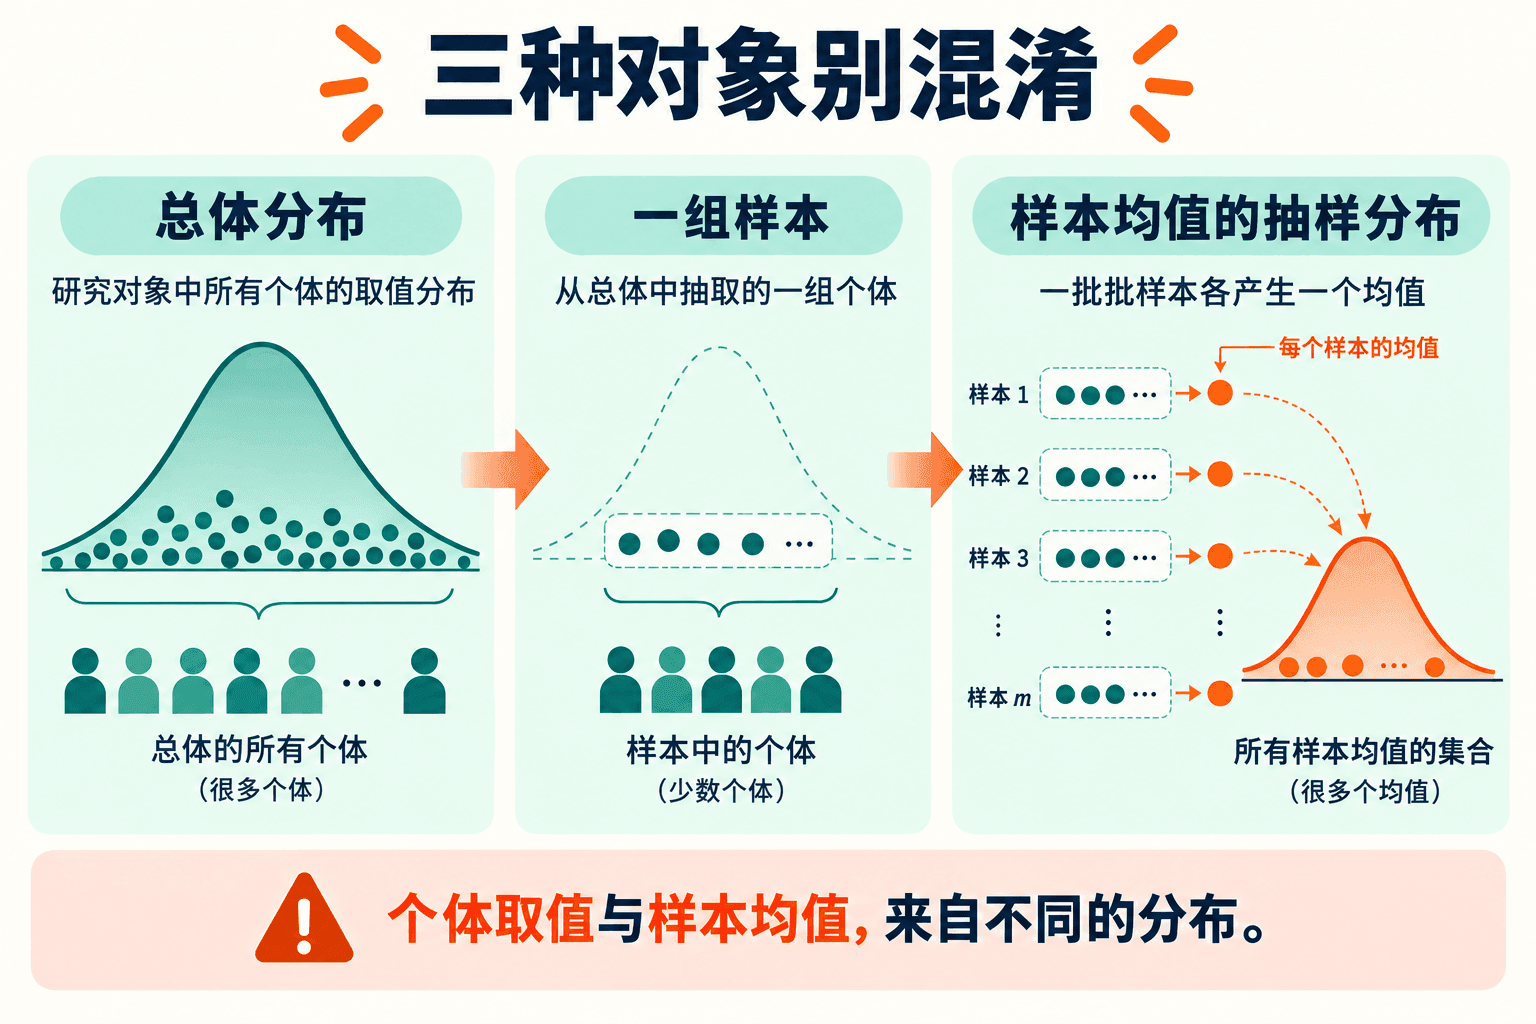 图 2-1:三种分布别混淆
如果 Xi 独立且来自 N(μ,σ2),正态变量线性组合仍为正态,因此
Xˉ∼N(μ,nσ2),Z=σn(Xˉ−μ)∼N(0,1).
这里得到的是有限样本精确结论,并没有要求 n 很大。若总体不服从正态,就得另查极限定理的条件和总体的分布特征,才能判断均值是否近似正态、近似够不够用。
例如设备测量误差独立正态,σ=6,重复 9 次的平均误差标准差为 2;重复 36 次则为 1。提高均值精度依赖平方根规律,不能把“增加 4 倍次数”说成“精度自动提高 4 倍”。
从随机误差算出一个概率
已知某仪器误差独立且服从 N(0,62)。团队希望平均误差落在 [−2,2] 内,重复 9 次和 36 次分别有多大把握?
这里需要的是平均误差 Xˉ 的分布,直接拿原始误差查表会用错尺度。9 次平均的标准差为 6/9=2;增加到 36 次时,这个值降为 6/36=1。
把同一个容许误差 2 换成标准差单位。9 次时是 1 个标准差,故概率为 P(∣Z∣≤1)≈0.6827;36 次时是 2 个标准差,概率为 P(∣Z∣≤2)≈0.9545。
对照一下就知道把握为什么提高了:容许误差区间没变,仪器本身的噪声也没变,是均值的抽样分布更集中了。这里用到了重复测量独立。如果 36 次测量共享一个偏移,刚才两个概率就不能照搬。
分布结论来自正态模型的封闭性,因而是精确的。四位小数只是概率的数值近似。分布是否精确,与小数保留多少位,是两回事。
2. 残差约束与 n−1 个自由度
定义残差 ei=Xi−Xˉ,则
i=1∑nei=0.
你可以试着固定前 n−1 个残差:最后一个已经被残差和为零的条件决定了。纸上虽然写着 n 个坐标,它们只能在 n−1 维空间里变化。这就是这里的自由度。
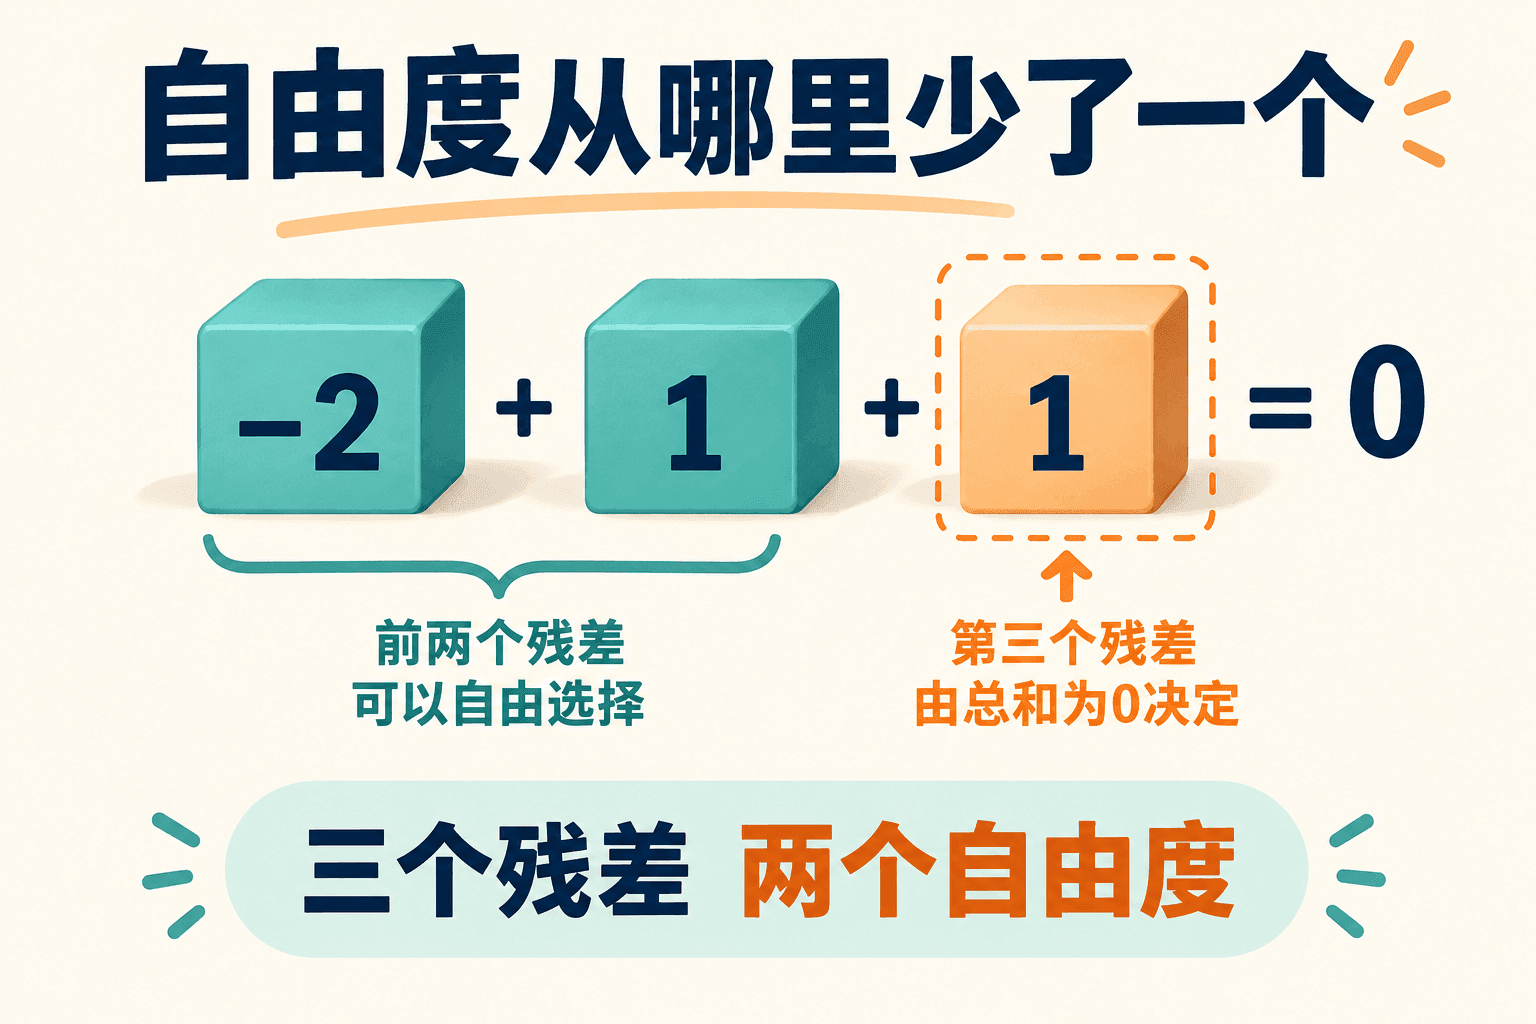 图 2-2:自由度从哪里少了一个
三个残差 −2,1,1 相加为零。若把第一个改为 −3 且第二个仍为 1,第三个必须改为 2。自由度数的是可以独立变化的方向,不是“数据里非零数字的个数”。
平方和的展开能显示拟合均值所消去的部分:
i=1∑n(Xi−μ)2=i=1∑n(Xi−Xˉ)2+n(Xˉ−μ)2.
展开 Xi−μ=(Xi−Xˉ)+(Xˉ−μ),交叉项因残差和为零而消失。围绕样本均值的平方和不会超过围绕真实均值的平方和;样本均值是针对当前数据选出的最佳常数拟合值。
用三个点亲手看见一个约束
取观测 2,4,6,样本均值为 4,残差为 −2,0,2。现在把第一个观测改成 5,得到 5,4,6,均值也随之改成 5,残差变为 0,−1,1。不能只改一个残差而让其他所有东西都不动:拟合出的中心会跟着数据移动。
如果总体均值事先已知为 μ=4,第二组数据相对真实中心的偏离是 1,0,2,平方和为 5;相对拟合中心的残差平方和只有 2。差出的 3 恰好是 n(xˉ−μ)2=3(5−4)2。这 3 是当前数据被移动中心“解释掉”的长度。
“估了一个参数,所以减一”是一种记法,原因仍在约束拿走了一个独立方向。第 12 章同时拟合截距和斜率时,会出现两个这样的约束,自由度变为 n−2。
实验:观测改变时残差的联动
一个观测移动后,拟合均值也会跟着变化。试着据此判断其他残差的变化,以及围绕拟合均值的平方和与围绕已知真实均值的平方和之间的大小关系。
圆点可以直接拖动,带标签的数值框和滑块也能修改观测。各个残差的联动值得一起看,尤其是最后一个怎样受前面的约束。“全部观测加1”用于观察整体平移;将观测设成同一个值,则能检查 RSS 为零的情形。
整体平移时,残差和 RSS 没动,围绕固定 mu 的平方和却会变化。即使你把 RSS 调到 0,残差空间仍是 n−1 维:一次样本落在零点,不代表可变化的方向消失了。
原因仍在残差总和恒为 0:最后一个由前 n−1 个决定,而总平方和=RSS+n(x̄−mu)²。除以 n−1 后的无偏性说的是重复抽样的期望。若还想得到卡方分布以及均值与样本方差独立,就要再加上正态模型。
3. 正态坐标的正交变换与独立性
把标准化观测写成向量 Z=((X1−μ)/σ,…,(Xn−μ)/σ)。取第一条单位方向 u1=(1,…,1)/n,再补成一组标准正交基。沿第一条方向的坐标是
Y1=u1⊤Z=σn(Xˉ−μ).
其余方向都与全 1 向量垂直,用来描述残差。将基向量依次放入矩阵 A 的行,得到 AA⊤=In、Y=AZ。垂直的几何关系还不足以证明独立,下面需要做一次密度变换。
原密度是 fZ(z)=(2π)−n/2exp(−z⊤z/2)。反变换为 z=A⊤y,由正交性得到 z⊤z=y⊤y;又由 det(A)2=1 得 Jacobian 绝对值为 1。因此
fY(y)=(2π)−n/2e−∑jyj2/2=j=1∏n2π1e−yj2/2.
现在密度在整个 Rn 上分成了边缘标准正态密度的乘积,独立性才算证明完。如果只算到协方差为零,在一般分布中还走不到这一步。
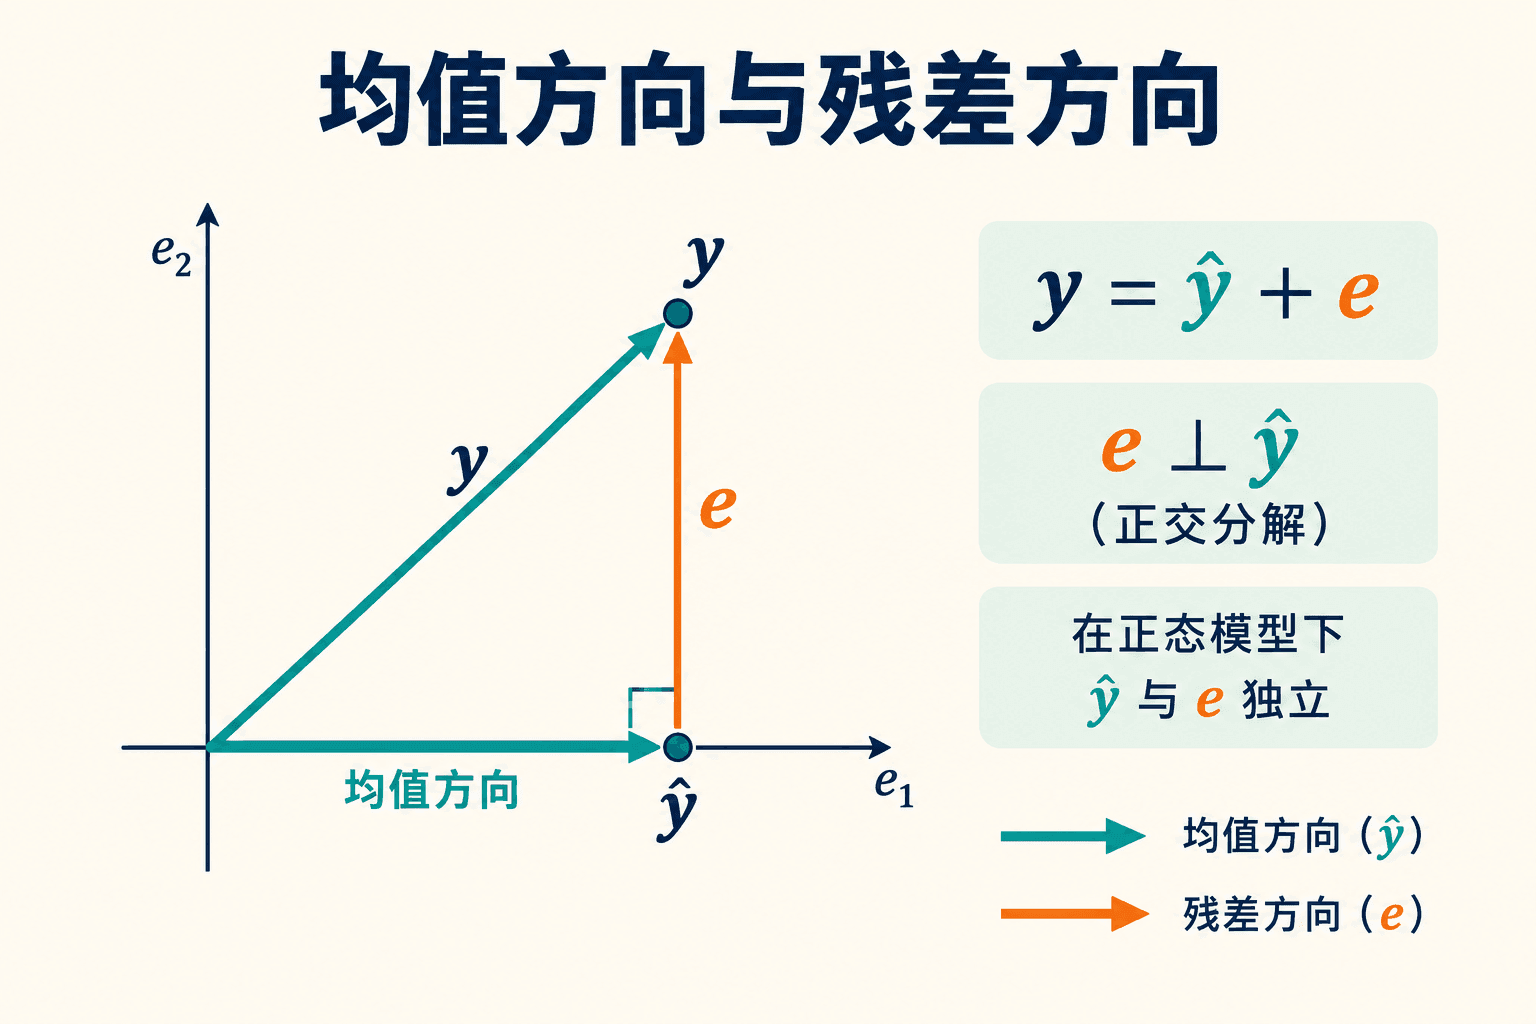 图 2-3:均值方向与残差方向
图里已经换成旋转后的坐标系,水平方向表示均值方向,并非某一条原始观测轴。这里能从正交坐标得到独立,依赖联合正态。对于已标准化为单位协方差的其他分布,这样的正交变换可保持坐标不相关,却未必独立。
令 S2=∑(Xi−Xˉ)2/(n−1)。由正交分解,残差平方长度为
σ2(n−1)S2=Y22+⋯+Yn2.
留意右边只用到了其余坐标,它们都与 Y1 独立。因此 Xˉ 与 S2 独立。接下来构造 t 统计量时,恰好要用这个关系。
三次观测,实际算一遍旋转
对 n=3,可取三条单位方向
u1=3(1,1,1),u2=2(1,−1,0),u3=6(1,1,−2).
各自长度为 1,两两内积为零。所以 Y2=(X1−X2)/(σ2),Y3=(X1+X2−2X3)/(σ6);它们的均值项因系数和为零而消失。展开可检查
2σ2(X1−X2)2+6σ2(X1+X2−2X3)2=σ2∑i=13(Xi−Xˉ)2.
取 x=(1,2,6)、σ=2,均值为 3,残差平方和为 14;上式左边为 1/8+81/24=3.5,等于右边 14/4。这次样本的两个残差坐标都有明确值,而它们在重复抽样中是独立标准正态。一般 n 的证明只是把这两条残差方向扩展为 n−1 条。
一个非正态反例:同样的几何,不同的独立性
设两个 iid 观测各以一半概率为 −1 或 1。同号时,Xˉ=±1、S2=0;异号时,Xˉ=0、S2=2。一旦知道均值为零,样本方差就确定为 2;知道均值非零,它就确定为零。因此均值与方差不独立,尽管残差和仍为零、平方和分解也完全成立。
残差和为零,平方和分解也成立,但独立性已经失效。正态密度的旋转不变性正是证明中需要的额外性质。精确的 t、卡方或 F 推断,不能漏掉这个条件。
4. 卡方分布是一组独立标准正态的平方和
若 Z1,…,Zν 独立标准正态,则
U=j=1∑νZj2∼χν2.
ν 为自由度,U 非负且几乎必然为正。由 E(Z2)=1、E(Z4)=3 可得 E(U)=ν、Var(U)=2ν。因此正态样本满足
σ2(n−1)S2∼χn−12.
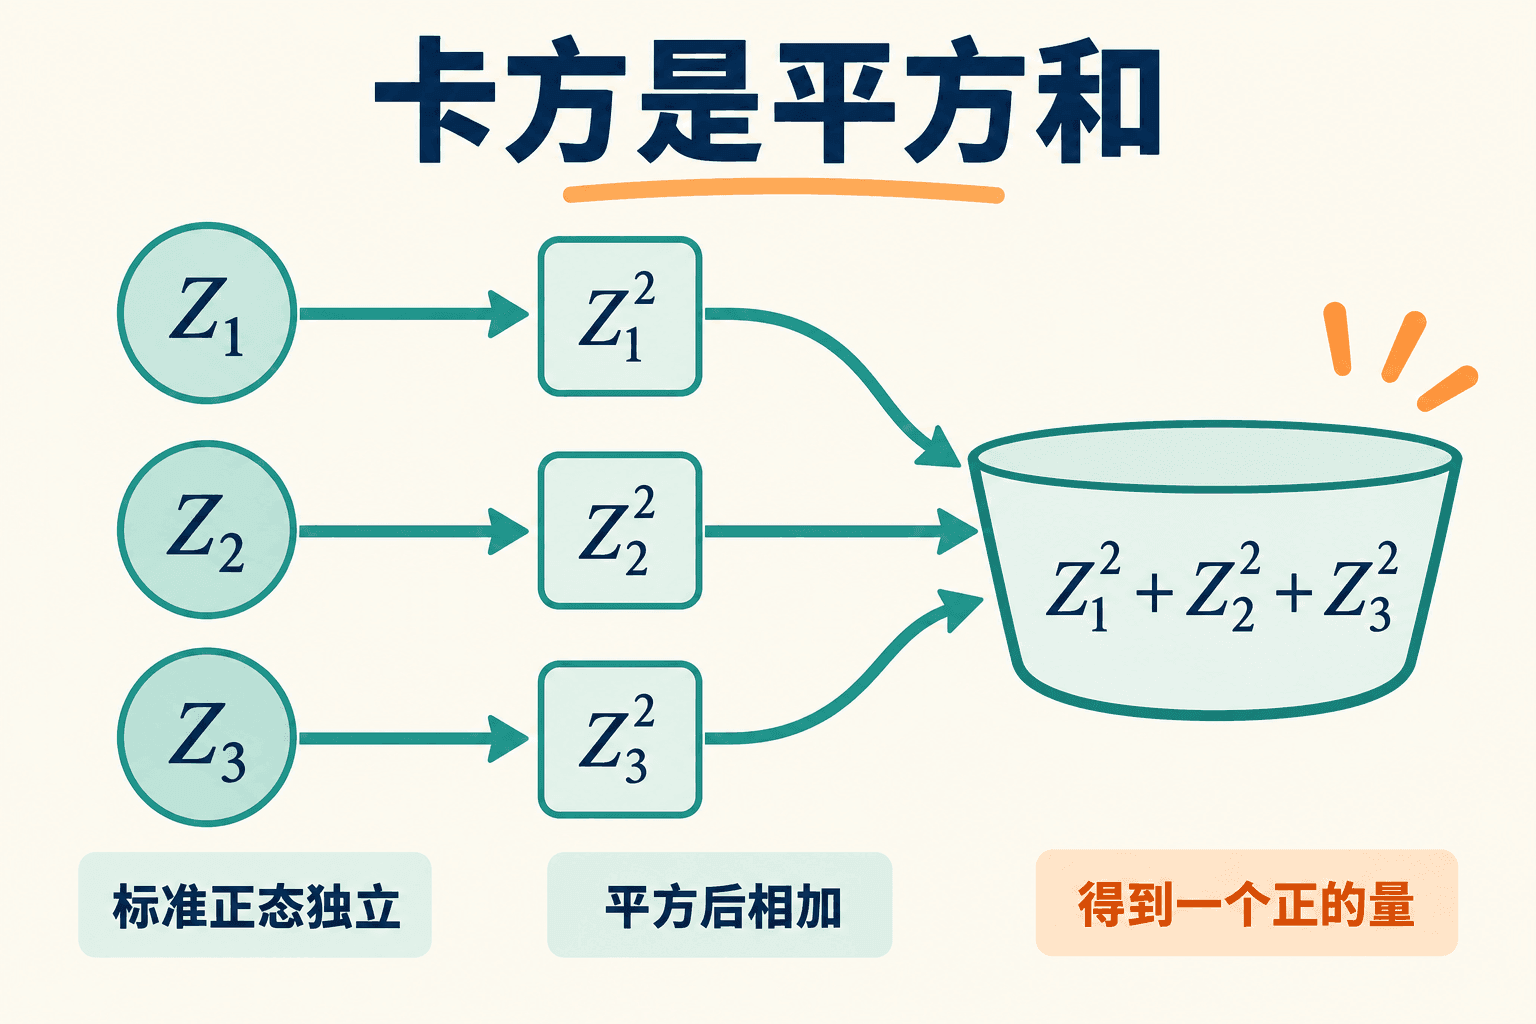 图 2-4:卡方是平方和
平方和是否服从这里的卡方分布,取决于坐标是否独立标准正态。漏掉标准化,或保留了非零均值,都会改变结论。此处构造的是中心卡方;非零均值会涉及非中心分布,后续分析功效时还会遇到。
从密度或矩母函数认出平方和
令 W=Z2,Z∼N(0,1)。对 w>0,平方映射有 ±w 两个原像,每支导数绝对值为 1/(2w),所以
fW(w)=2πw−1/2e−w/2.
若用 Gamma 函数 Γ(a)=∫0∞ua−1e−udu,这就是形状 1/2、尺度 2 的 Gamma 密度。平方和的矩母函数也能直接算:对 t<1/2,
E(etZ2)=2π1∫−∞∞e−(1−2t)z2/2dz=(1−2t)−1/2.
独立使乘积的期望分解,ν 项之和的矩母函数为 (1−2t)−ν/2,于是得到密度
fU(u)=2ν/2Γ(ν/2)uν/2−1e−u/2,u>0.
在零附近存在的矩母函数唯一决定分布。相同推理还证明相互独立的 χa2 与 χb2 相加为 χa+b2。如果二者不独立,就不能乘矩母函数;例如把同一个 χ12 变量加两遍得到的是 2U,其方差为 8,和 χ22 的方差 4 不同。
计算例。 n=9 的正态样本若真实方差为 4,则 2S2∼χ82。因此 E(S2)=4,Var(S2)=2×42/8=4。这里方差参数为 4,其平方为 16,不能把 σ4 误读为标准差的平方。
5. 用随机尺度标准化,得到 t 分布
定义:Z∼N(0,1),U∼χν2,且二者独立,则
T=U/νZ∼tν.
在正态样本中代入 Z=n(Xˉ−μ)/σ 和 U=(n−1)S2/σ2,未知的 σ 消去:
T=S/nXˉ−μ∼tn−1.
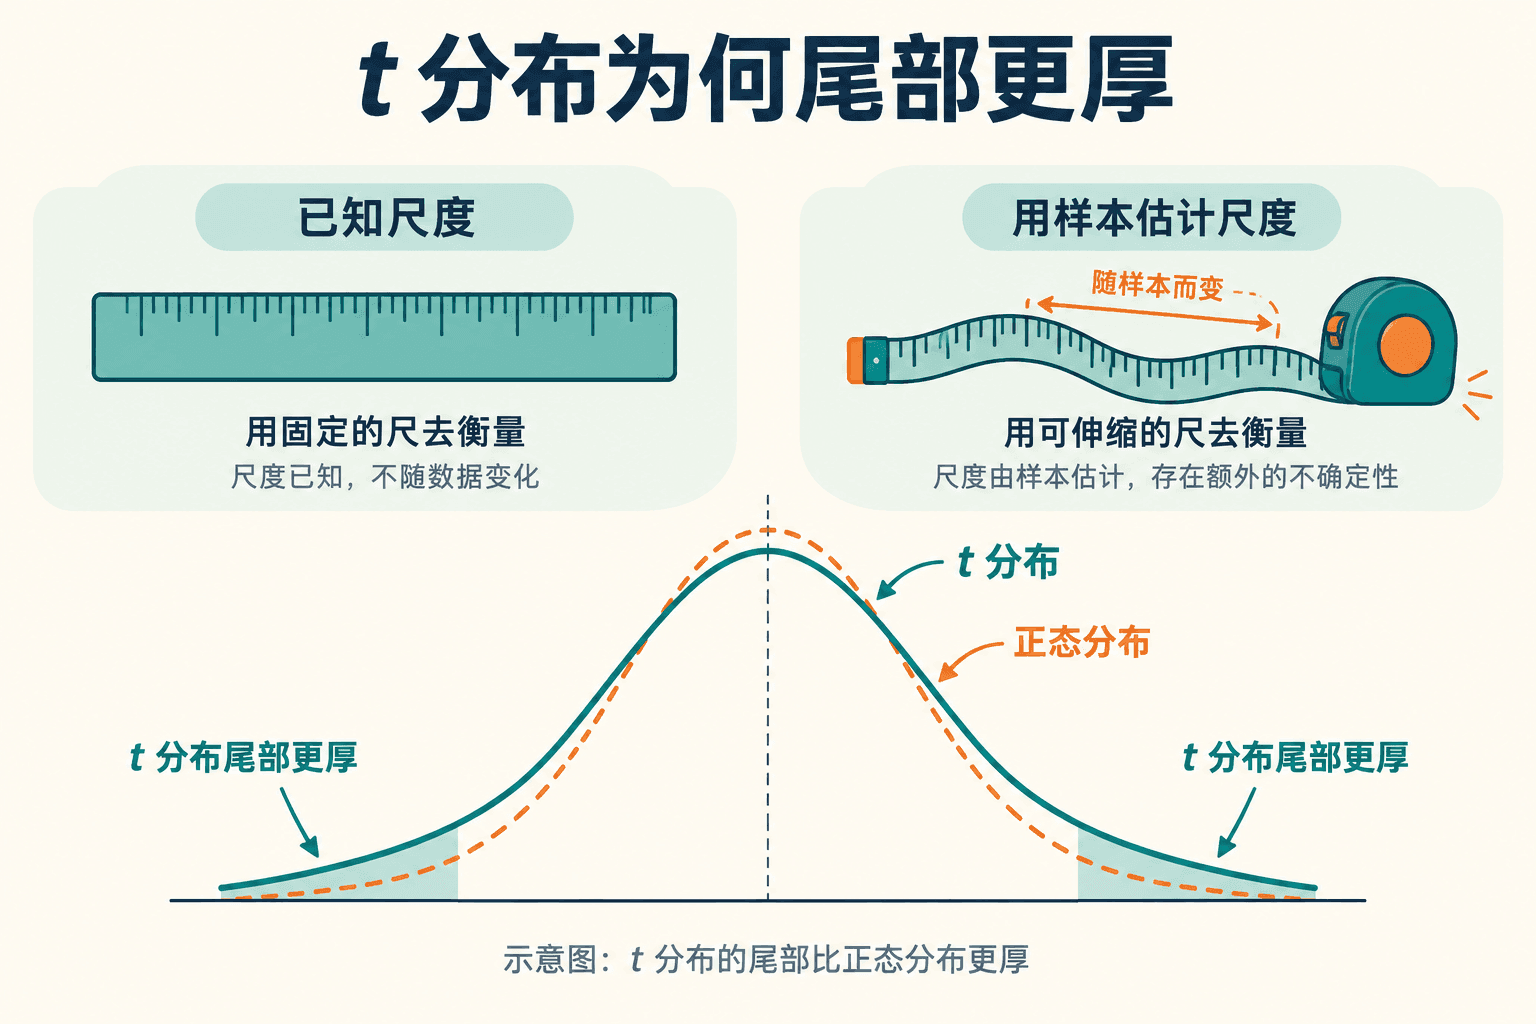 图 2-5:t 分布为何尾部更厚
随机分母有时会估得偏小,同一个分子除过去,绝对值就被放大了,厚尾由此产生。自由度增加后,U/ν 越来越集中在 1 附近。分母接近固定尺度,t 分布也逐渐靠近标准正态。
别把厚尾理解成“t 总比正态大”:这里比较的是两种分布,不是两个数。t 的密度在中心通常更低,在足够远的尾部才更高。自由度为 1 时,它连有限期望都没有;自由度大于 2,才有方差 ν/(ν−2)。
对随机分母积分得到 t 密度
由独立性,(Z,U) 的密度是两个边缘的乘积。改用坐标 (T,U),反变换 z=tu/ν,Jacobian 绝对值为 u/ν。把 u 积掉:
fT(t)=∫0∞fZ(tu/ν)fU(u)u/νdu=νπΓ(ν/2)Γ((ν+1)/2)(1+νt2)−(ν+1)/2.
中间的积分合并成 u(ν+1)/2−1exp[−u(1+t2/ν)/2],使用 Gamma 积分换元即可求出。远离中心时,t 密度按 ∣t∣−(ν+1) 衰减;标准正态的衰减则是指数平方形式。厚尾的差别在密度中也能直接看见。
还可不靠密度直接求二阶矩:独立性给 E(T2)=E(Z2)νE(1/U)。由卡方密度积分,在 ν>2 时 E(1/U)=1/(ν−2),得方差 ν/(ν−2)。ν≤2 时零附近的倒数积分发散,解释了“为什么这时方差不存在”。大自由度下,E(U/ν)=1、Var(U/ν)=2/ν→0,分母趋近固定尺度,厚尾逐渐消退。
固定尺度与估计尺度下的尾部概率
设 n=9,本次样本均值比假设值高 2。若真实标准差已知为 3,标准化值为 2/(3/9)=2。若标准差未知而本次样本标准差恰好也是 3,计算出的数仍是 2,但参考分布变为 t8:右尾概率约 0.0403,标准正态右尾则约 0.0228。
两套计算在这一次给出相同数值,重复抽样时却有不同表现。已知 σ 时,每次都除以固定的 1;未知 σ 时,分母来自当批数据,偶尔出现的小标准误会把结果放大。即使这次 s 恰好等于 σ,尺度估计这一步的随机性仍然存在。
选分布时,只问样本大小还不够。精确 t 需要独立正态样本、正确的样本方差,以及均值与方差独立。非正态样本即使很大,也要沿另一条极限定理路线说明近似为什么成立。
6. 两份独立尺度信息,得到 F 分布
若 U∼χa2、V∼χb2 相互独立,则
F=V/bU/a∼Fa,b.
对两个相互独立的正态样本,样本内观测也独立,有
S22/σ22S12/σ12∼Fn1−1,n2−1.
只有在比较方差相等的零假设 σ12=σ22 下,这个表达式才简化为 S12/S22。分子、分母的自由度有顺序;若 F∼Fa,b,则 1/F∼Fb,a。
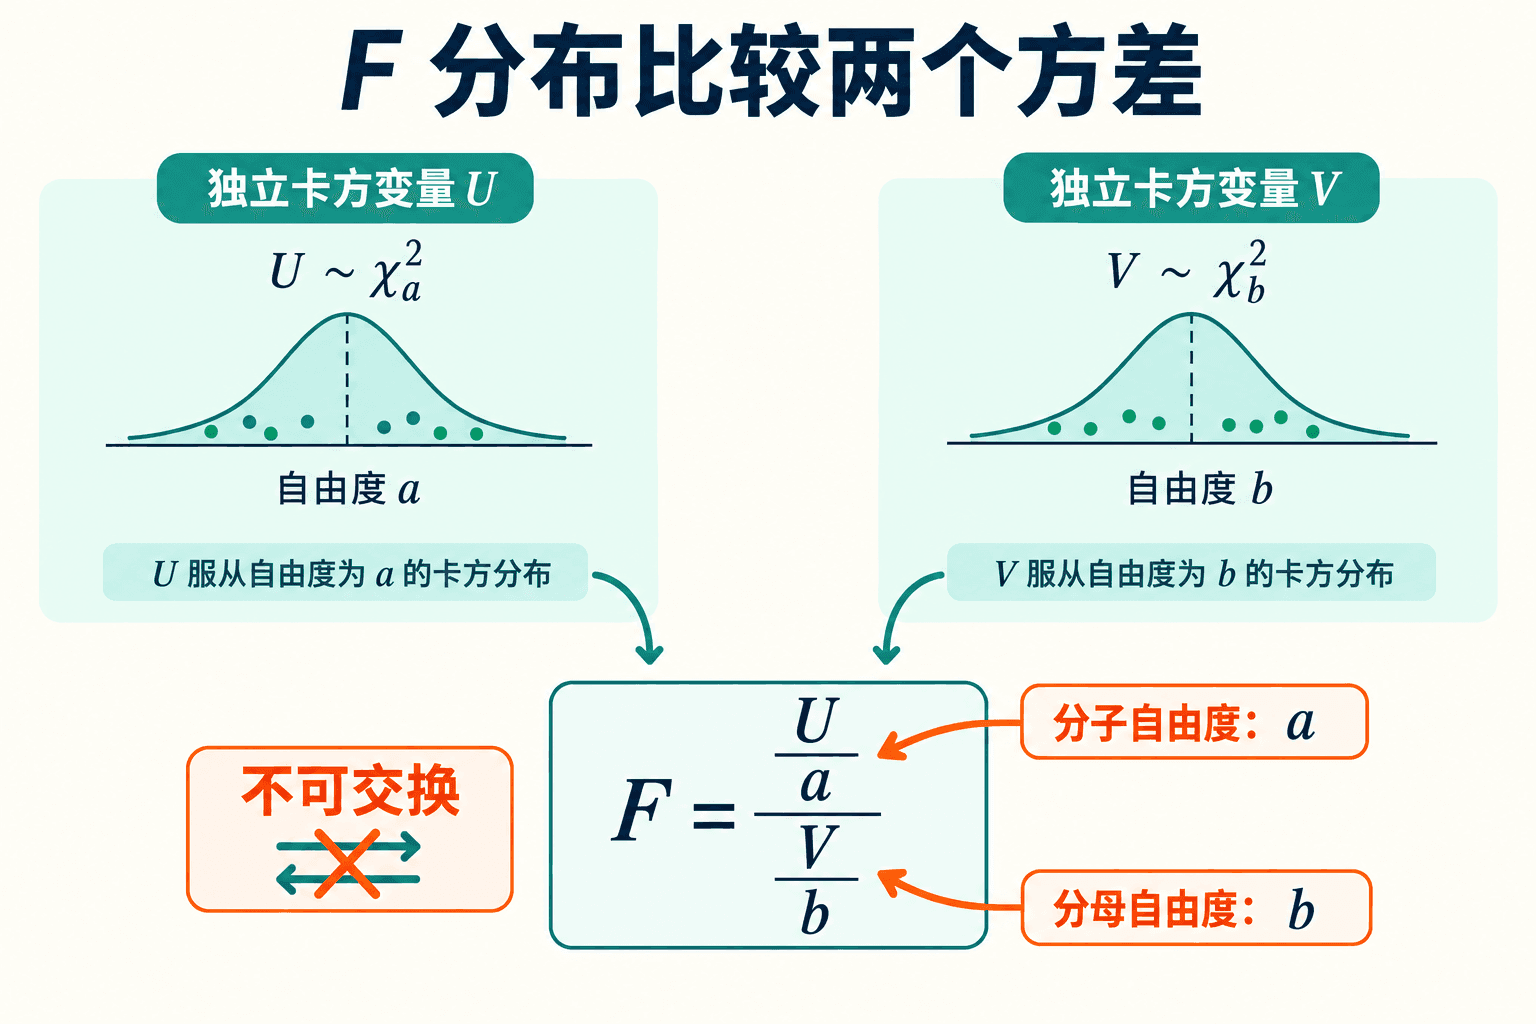 图 2-6:F 分布比较两个方差
这张图画的是构造关系,具体曲线还要看自由度。查表时把分子的自由度放在前面,并确认两份卡方量独立。
另一个连接是 T2∼F1,ν,其中 T∼tν。因为 Z2∼χ12,t 的平方正好成为两份校正卡方量之比。这个关系将在回归的斜率检验中再次出现。
合并两份残差时,自由度也要合并
两个独立正态样本具有共同方差 σ2,大小为 n1,n2。各自扣除一个样本均值后,残差卡方量独立,相加得到自由度 n1+n2−2。因此定义合并方差
Sp2=n1+n2−2(n1−1)S12+(n2−1)S22,
就有 (n1+n2−2)Sp2/σ2∼χn1+n2−22。两组均值之差为正态、方差 σ2(1/n1+1/n2),又独立于两组残差,从而
Sp1/n1+1/n2Xˉ1−Xˉ2−(μ1−μ2)∼tn1+n2−2.
正态性保证了精确分布,以及组内均值与残差独立。两份卡方量可以相加,还依赖组间独立;共同方差则让同一个 σ2 能从总平方和中提出。若两组方差不同,这个比值通常不再服从精确 t 分布,第 9 章会说明相应的近似方法。
实验:从独立正态构造 χ²、t 与 F
U/a 偶然小于 1 时,Z/√(U/a) 的绝对值会被放大。用这个关系判断厚尾的来源,在模拟中观察随机分母偏小时的结果。
界面的“1·生成独立正态”展示原始材料,后续阶段显示平方和与随机比值。重抽几组,留意同一批材料在变换中的对应关系。右尾概率可以在 a=8、c=2 时读出,改变 a 后便有了比较。
原始正态数有正有负,平方后相加只能非负。t 的绝对值可能被随机分母放大。F 的构造用到两份独立平方和,每份除以各自的自由度后取比值。界面里的中间结果可以逐项核对这些关系。
这里,Z 与 U 独立给出 t_a,U 与 V 独立给出 F_(a,b)。t² 对应 F_(1,a),要和界面中由 U_a/V_b 构造的 F_(a,b) 分开看。图只画了有限窗口,右尾概率用的却是完整分布,不能只数可见曲线下的面积。
用构造条件选分布
1把 8 个相互独立的标准正态变量平方后相加,得到什么分布?
2残差之和为零只约束它们的总和,不要求每个残差都为零。
3两个独立正态样本的样本量为 7 和 10。方差比统计量的分母自由度是多少?
7. 练习:抽样分布的构造与迁移
练习 1|从三个方向迁移到两个配对组。 独立标准正态 Z1,…,Z4,令 A=(Z1+Z2+Z3+Z4)/2、B=(Z1+Z2−Z3−Z4)/2、C=(Z1−Z2)/2、D=(Z3−Z4)/2。证明它们相互独立,求 B2+C2+D2 的分布,并解释它为什么与 A 独立。
四行系数各有平方长度 1。A 与 B 的内积为 (1+1−1−1)/4=0,A 与 C、D 的非零项分别一正一负相消;B 与 C、D 同样相消;C 和 D 作用在互不重叠的两组坐标上,内积为零。因此系数矩阵正交。沿正文的密度变换,平方长度保持、Jacobian 为 1,联合密度分解为四个标准正态密度,给相互独立。后三项平方和为 χ32,又是与 A 独立的三个坐标的函数,所以与 A 独立。B 比较两组平均,C、D 比较各组内部;总体平均方向没有混入这三个差异方向。
练习 2|已知中心和估计中心。 正态样本 n=8、方差为 σ2。分别写出围绕真实均值的标准化平方和、围绕样本均值的标准化平方和的分布,解释它们差值的分布及独立分解。
前者为 χ82,后者为 χ72,差值是 8(Xˉ−μ)2/σ2=Y12∼χ12。残差坐标与均值坐标独立,因此两个部分是独立卡方,总自由度相加为 8。差值不表示丢了一条观测,而是使用了一个拟合方向。
练习 3|两条边缘不够。 令 U∼χ62,再令 V=U。它们各自都服从 χ62。求 (U/6)/(V/6) 的分布,指出套 F 构造时漏了什么。
因为分子分母是同一个量,比值几乎必然等于 1。它是退化分布,当然不是 F6,6。漏掉的是两份卡方量独立这一条件:只知道各自的边缘分布,还不知道它们怎样一起变化。
练习 4|随机分母的矩。 T∼t5,用独立比值构造求 E(T2)。若自由度改成 2,哪一个积分失效?
T=Z/U/5,所以 E(T2)=5E(Z2)E(1/U)=5/3。自由度为 2 时卡方密度在零附近近似正常数,乘 1/u 后不可积,二阶矩无限。不能因为分母几乎必然大于零就声称其倒数期望有限。
练习 5|拼接新的材料。 独立 Z,U,V 分别服从 N(0,1),χ42,χ92。给出 Z/(U+V)/13、(V/9)/(U/4) 和前一比值平方的分布。
U+V∼χ132 并独立于 Z,第一项为 t13;第二项为 F9,4,自由度顺序不可倒置;第一项平方为 F1,13。三次变换分别用了卡方可加性、独立比值构造及标准正态平方为一自由度卡方。
练习 6|合并方差的权重。 两个独立同方差正态样本量分别为 5、9,本次方差分别为 4、9。求合并方差与均值差的标准误,给出其标准化误差分布。
合并方差为 Sp2=(4⋅4+8⋅9)/12=22/3,由它算出的均值差标准误是 (22/3)(1/5+1/9)=308/135≈1.5105。将均值差减去真实均值差,除以这个随机标准误,得到 t12。这里的权重来自残差平方和的合并,不能直接平均两份方差。
练习 7|逆比值和分位数。 记 qp(a,b) 为 Fa,b 的下侧累积概率为 p 的分位数。用倒数关系证明 qp(a,b)=1/q1−p(b,a)。
若 F∼Fa,b,则 1/F∼Fb,a。对 x>0,P(F≤x)=P(1/F≥1/x)。分布连续,右侧等于 1−P(1/F≤1/x)。令左侧为 p,便知 1/x 是交换自由度后的 1−p 分位数。倒数同时改变尾部和自由度顺序。
练习 8|检验条件清单。 两批读数来自同一设备相邻时刻,分布明显右偏。某人直接用样本方差比查精确 F。分别指出组内正态、组内独立、组间独立在构造链中的位置,并说明增加每批条数是否自动修复。
组内 iid 正态保证了标准化残差平方和服从卡方,组间独立则是构造 F 比值的条件。右偏已经挑战了前一部分,时间依赖还可能同时破坏组内与组间独立。增加记录不会自动得到精确卡方分布,也不会消除相关性;采集方式或推断方法需要相应调整。