似然由实际观察机制决定。完整等待、删失与截断记录的贡献不同,优化时还可能遇到边界或不存在最大点的样本。
1. 固定的是数据,变化的是参数
10 次操作成功 6 次,最大似然会把成功概率估为 0.6。这个选择来自候选参数对同一份记录的比较,可以在伯努利模型中完整推导。不过,优化之前必须看懂记录:四行等待时间里若有两行表示“事件还没发生”,似然就需要使用生存概率,不能把它们当成完整等待时间。
固定实际观测 x,把联合概率质量或密度看成候选参数的函数,得到似然 L(θ;x)。最大似然估计在允许的参数空间中寻找使它最大的参数。
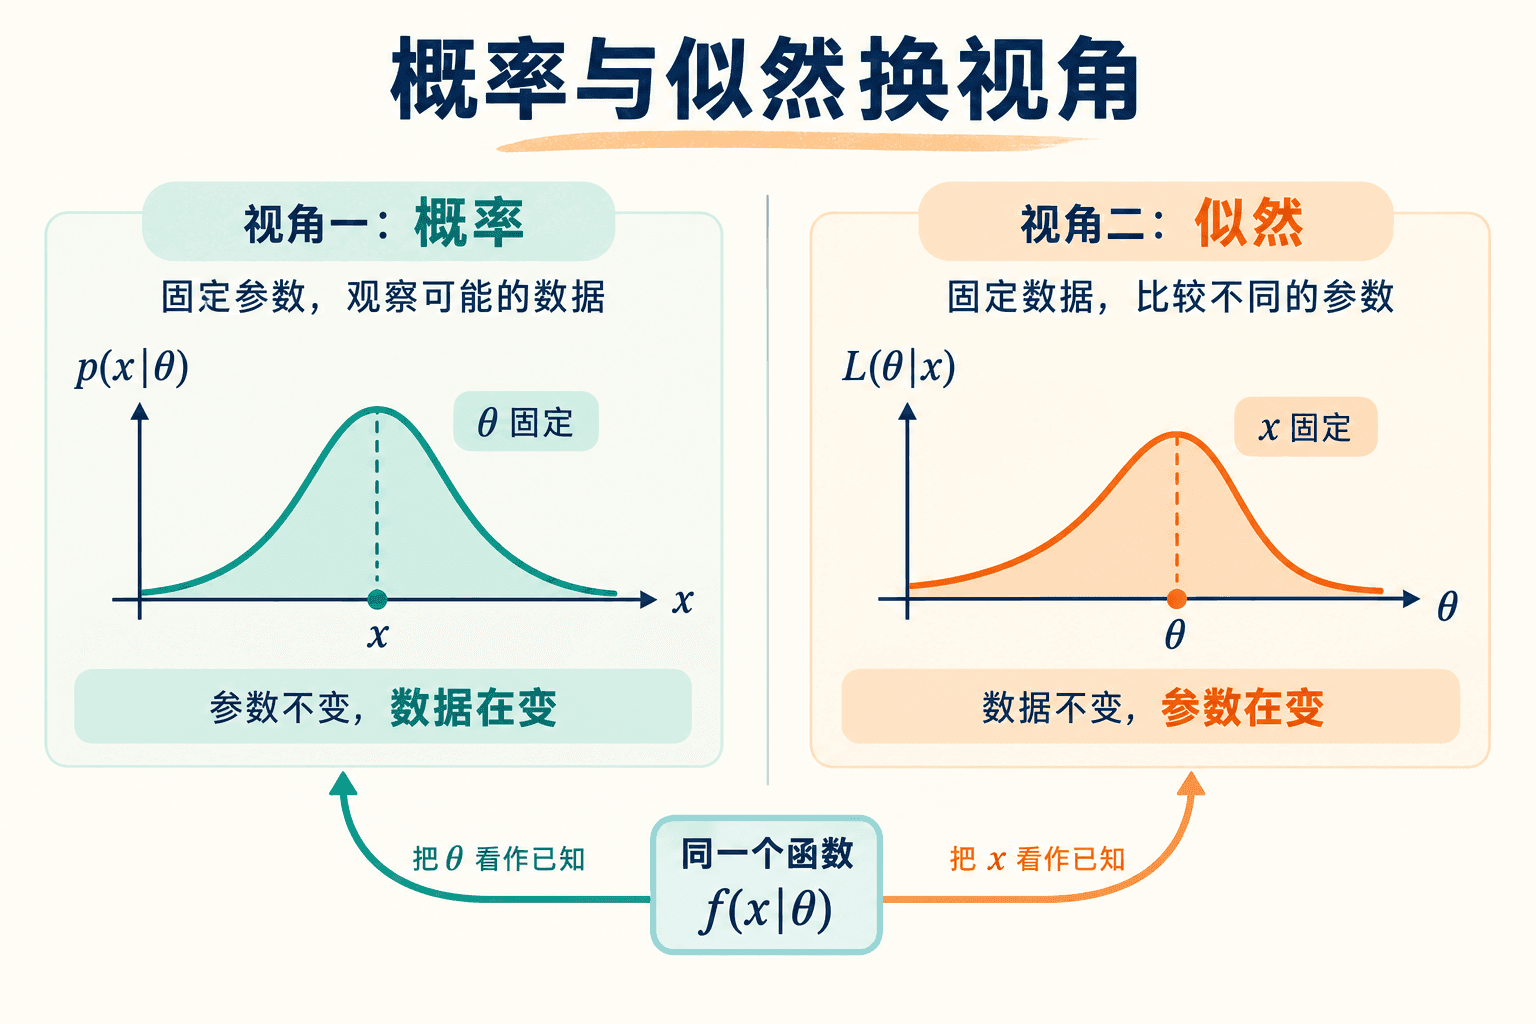 图 5-1:概率与似然换视角
计算概率时通常固定参数,研究数据可能怎样出现。似然使用同一个质量或密度表达式,却固定眼前的数据,改变参数。它不要求对参数积分为 1;没有引入先验并归一化,也不能称为“参数的概率”。
连续模型中精确单点的概率为零,因此使用的是联合密度。比较密度并不等于宣称某个单点具有正概率;它可以理解为比较相同微小观测邻域的相对概率。
若样本 iid,则
L(θ;x)=i=1∏nfθ(xi),
这里特意用了集合符号。暂时别假定一定有唯一峰值:最优点可能不止一个,也可能一个都没有。
观测机制决定联合似然
各项能够相乘,依赖观测独立,并非最大似然的定义。相关观测需要联合密度或条件密度分解。观察窗口不同时,曝光时长也属于单次分布的一部分。
例如三个独立计数分别观察了 t1,t2,t3 小时,共同事件率是 λ 每小时,则 。忽略不含 的因子后,,于是 。它是总事件数除以总观察时长,不是三个计数的普通平均,也不是三个样本事件率不加权的平均。
代入观察时长 1,2,5 和计数 3,4,8,总共 15 次事件、8 小时,估计为 λ^=15/8=1.875。如果先算三个事件率 再等权平均,会得到 2.2,短窗口中的波动被看得太重了。这里的权重在写观测模型时就已决定,并不是求导后再凭感觉选的。
2. 伯努利例:完整推导内点与端点
令 s=∑xi。伯努利样本的似然是
L(p;x)=ps(1−p)n−s,0≤p≤
如果仅记录总成功次数,二项概率还带组合系数 (sn),但该系数不含 p,不改变最优点。
当 0<s<n 时,取对数:
ℓ(p)=slogp+(n−s)log(1−p),
令导数为零得 p^=s/n。二阶导数 −s/p2−(n−,所以对数似然严格凹,这个内点是唯一最大值。
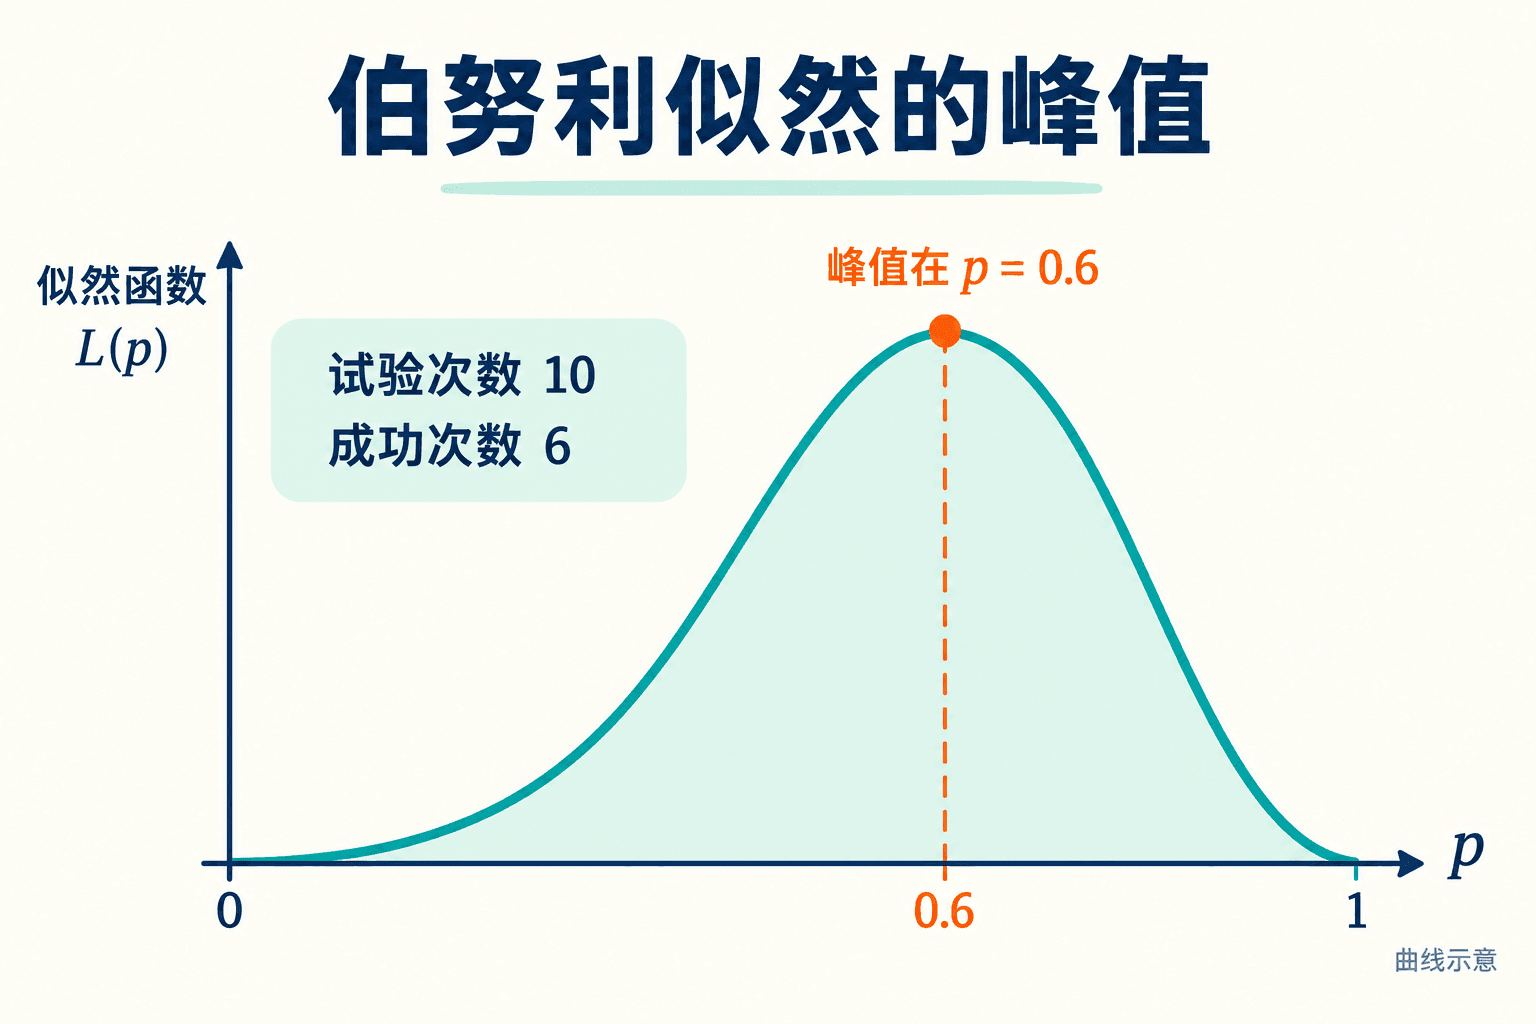 图 5-2:伯努利似然的峰值
若 s=0,似然 (1−p)n 单调递减,闭参数空间中最大值在 p=0;若 s=,最大值在 。不能只使用内点求导法而漏掉这些样本。如果参数空间改成开区间 ,全失败或全成功时只有上确界,没有达到上确界的最大点。
实验:内点峰值与边界最大值
n=10、s=6 时,p 从 0.5 移至 0.6,相对似然的变化可以由前面的导数判断。全部失败则提供了一种边界情形,一阶条件是否适用需要重新考虑。
p 滑块显示候选参数处的似然,“移到最高点”可以核对判断。切到“全部失败”后,观察最高点的位置以及得分符号。重置会恢复原来的样本。
内点最高处是 p̂=s/n,左边得分为正,右边为负。但 s=0 时,似然一路下降,最高点直接落在 p=0。你这次看到的最大点就在边界上。
两种情况下都是固定数据、改变参数。程序用 loglik 的差计算相对似然,避免小数连乘下溢;但找最大点的条件得分开处理,内点的一阶必要条件不能照搬到边界。
相同点估计下的不同似然曲线
10 次成功 6 次和 100 次成功 60 次,峰都在 p^=0.6。但后者的对数似然是前者的 10 倍,参数偏离 0.6 时,相对似然会降得更快。只报峰的位置,这个差别就被藏起来了。第 7 章会用信息量进一步描述附近的变化速度。
对第一份数据,L(0.5)/L(0.6)≈0.8176;对第二份,相同比值约为 0.817610≈0.1335。同一个点估计可以伴随很不同的不确定性,因此不应把“MLE 都是 0.6”写成“证据完全一样”。
也不能把相对似然 0.8176 读成“p=0.5 的概率为 81.76%”。目前只是在比较两个候选对同一份数据的解释程度,还没有给参数定义概率分布,更没有分配总和为 1 的权重。
3. 对数似然与计算
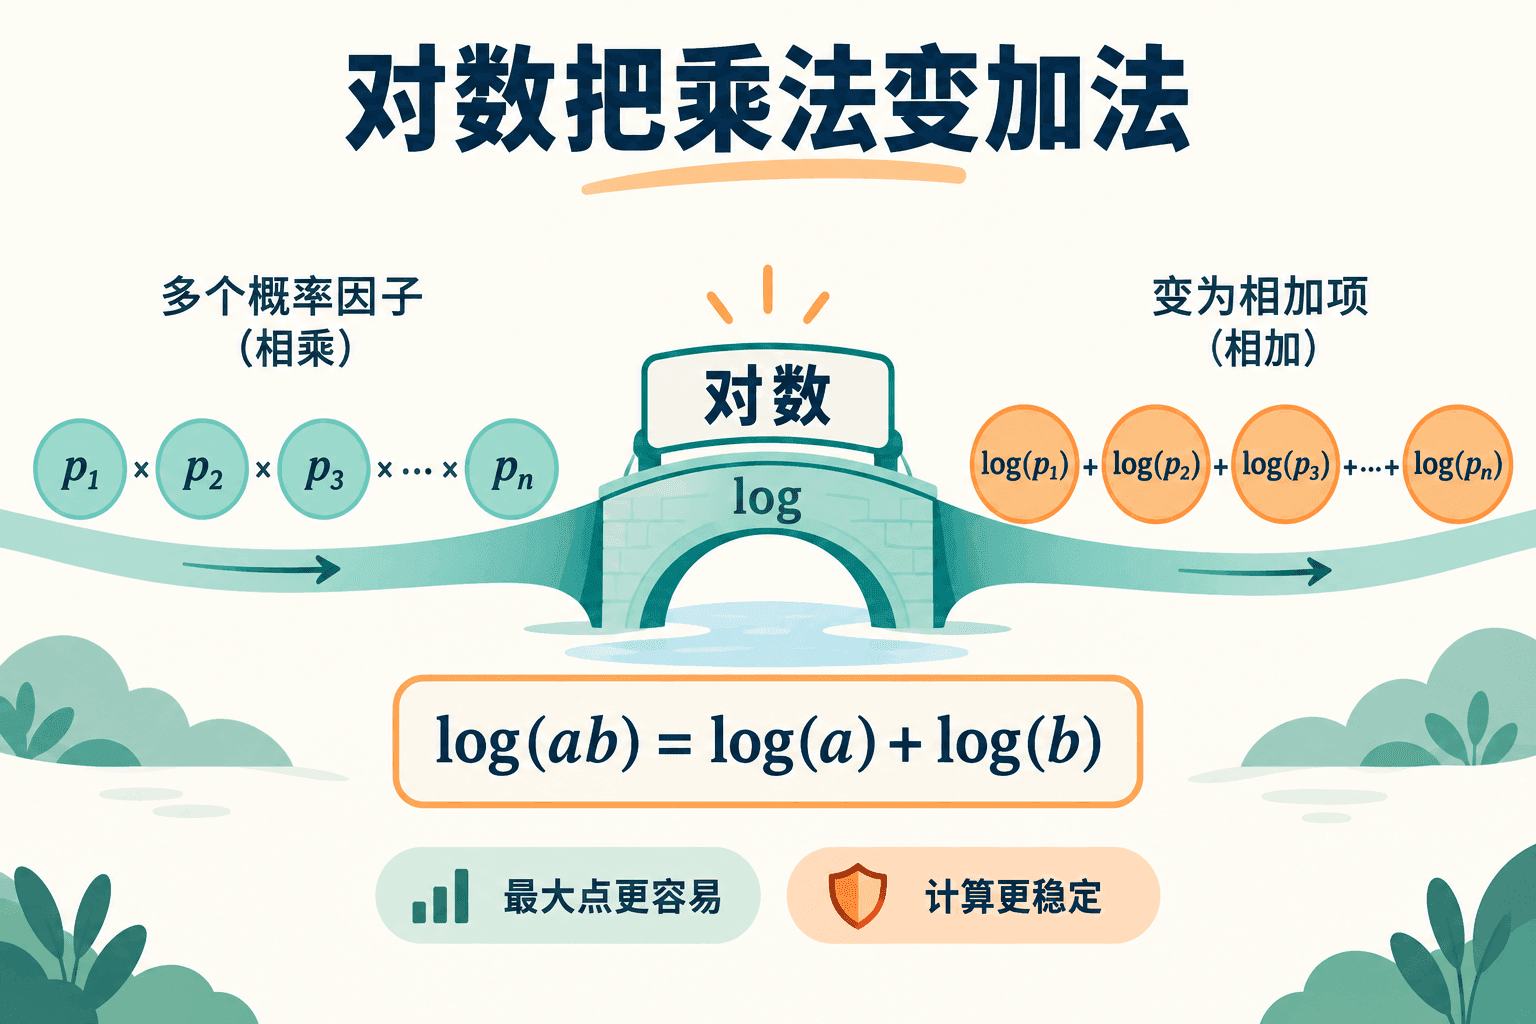 图 5-3:对数把乘法变加法
对数在正数上严格递增,因而取对数保留了峰值位置,同时把连乘改为求和,减少下溢问题。可删去的常数必须确实不含待估参数。归一化因子或支持指示函数依赖参数时,都要留下。
指数速率例。 对严格正观测,设 W=∑xi,则
ℓ(λ)=nlogλ−λW,ℓ′(λ)=n/λ−W
若 W>0,唯一最大值为 λ^=n/W=1/xˉ,与矩估计一致。对 ,得到 每秒。
指数模型中的矩估计与最大似然恰好相同。矩估计匹配所选特征,似然则包含联合密度的形状和支持信息,因此其他模型未必给出相同规则。删失、截断或选择性记录尤其需要按实际观察机制重写似然。
记录“至少等了 5 秒”,不能当成“恰好等了 5 秒”
四台设备同时开始观察,真实等待时间独立服从指数速率模型。两台在 2 秒、3 秒发生事件,另外两台到 5 秒仍未发生,观察便结束了。后两条记录只说明等待时间大于 5,这叫右删失。它们贡献的应是生存概率。
发生事件的两台贡献密度 λe−2λ、λe−3λ。对到 5 秒仍无事件的设备,记录对应的是生存概率 。
这里的截止时间事先固定,没有根据设备潜在等待时间决定何时停。截止机制若还含有参数信息,也要纳入模型。似然中的每一项,都应能对应实际看到的事件。
4. 正态模型的位置与尺度优化
若 Xi∼iidN(μ,σ2),其中 ,则
ℓ(μ,σ2)=−2nlog
展开平方和,可以把位置偏移的贡献分离出来:
i∑(xi−μ)2
交叉项为 2(xˉ−μ)∑i(xi−。因此无论方差取哪个正值,位置偏离 只会增大负的残差惩罚。所有候选中的最佳位置都是 ,这是对整个位置参数空间的比较,而不只是检查一个驻点。
把这个最佳位置代回,得到关于 v=σ2 的剖面对数似然:对每个 v,把其余参数优化后留下的函数。
ℓprof(v)=C−
在 Q>0 时,导数于 v<Q/n 为正、于 v>Q/n 为负,所以全局唯一最大值是 v。这个符号变化已经把两侧所有候选排除了,无须只盯着驻点本身。
剖面化并未把均值当成已知量。对每个方差候选,均值仍在其允许范围内自由优化。第 11 章的受约束检验也要在相应假设范围内重新处理干扰参数。
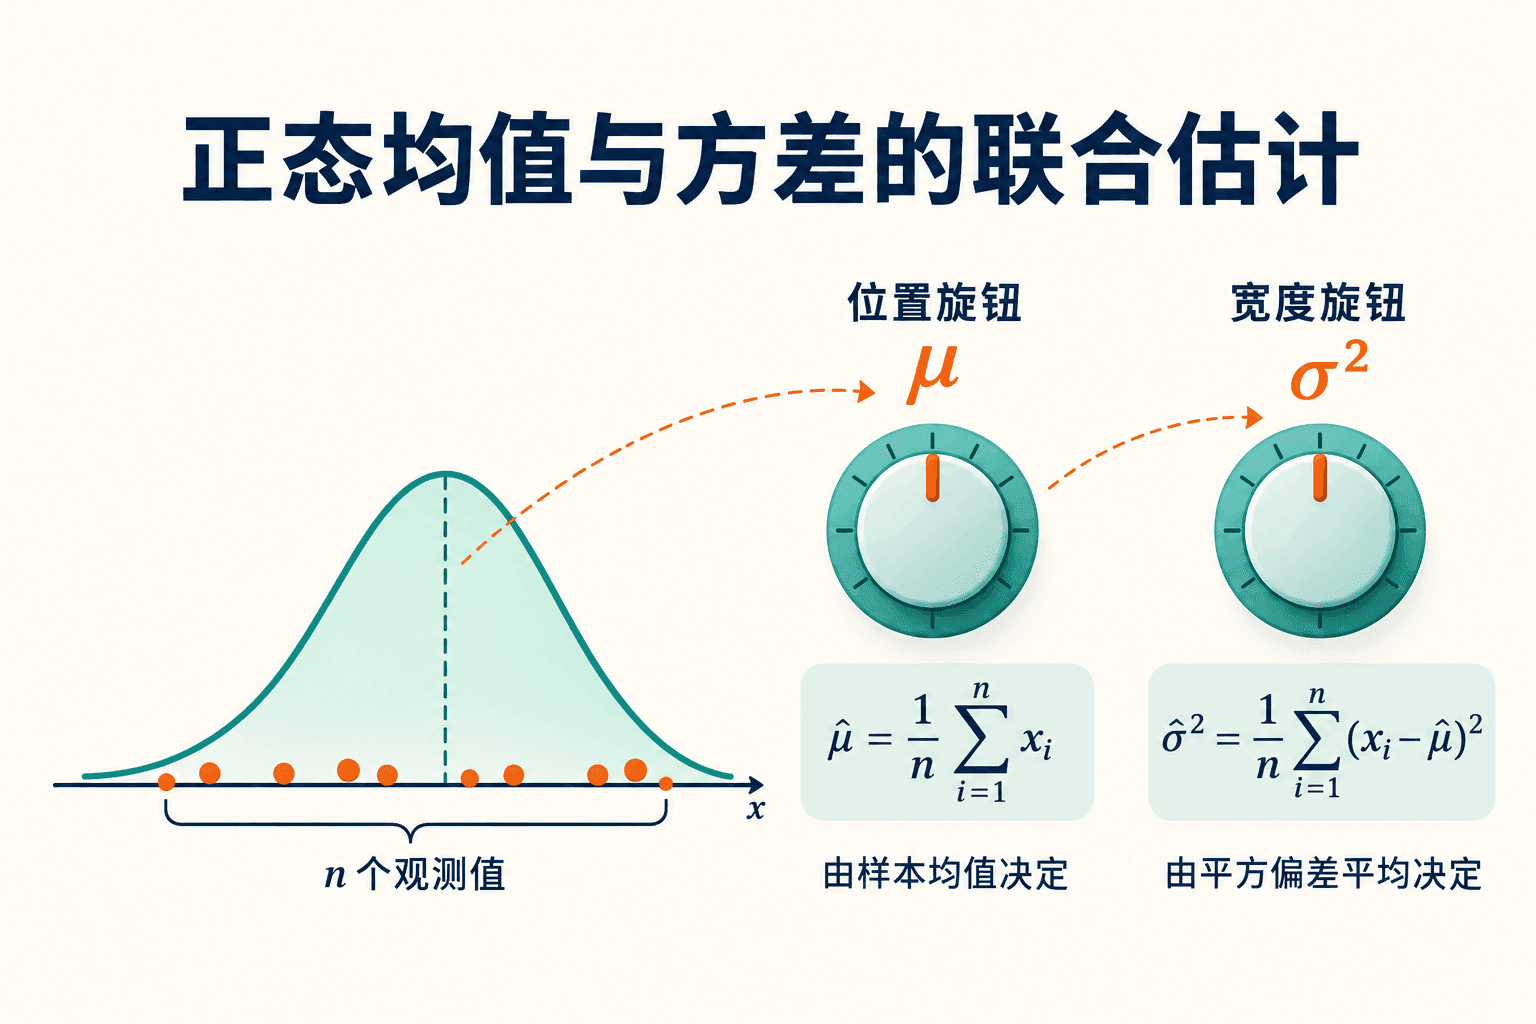 图 5-4:正态均值与方差的联合估计
样本 2,3,5,6 给出 μ^=4、Q=10、;无偏样本方差则为 。前者符合最大似然目标,后者满足无偏约束。
如果全部观测相同,Q=0,令 μ 等于这个值、σ2↓0 会让似然无界增大。在要求 σ2> 的模型中,不能把 当作一个合法的常规最大点。实际数据若由于取整而完全相同,还要考虑记录分辨率是否适合连续正态模型。
最大似然有一个实用性质:对一一参数变换 η=g(θ),对应估计为 g(θ^),因为只是重新命名同一组候选分布。这个性质不意味着无偏性也在非线性变换下保持。
实验:分母 n 对应的似然峰值
样本为 2、3、5、6,均值固定在 4。σ²=2.5 和 10/3 分别对应最大似然与无偏规则,结合剖面似然判断两点的函数值高低。
“移到无偏估计”和“移到似然最高点”可以标出两个候选位置。移动 μ 时,留意新增的残差项。常数样本提供了另一种情形:按“试常数样本”后减小方差,观察函数值的变化。
最高点在 (4,2.5),无偏方差点 (4,10/3) 在它上方,相对似然略小。方差固定时,均值离开 4 会增加 n(μ−x̄)²。换成常数样本后,找不到可用来归一化的有限最高点。
计算时先消去均值偏移带来的平方项,再平衡密度扩散和残差惩罚,得到 SSE/n。除以 n−1 则是在修正偏差,两种规则回答的是不同的要求。
5. 参数相关的支持与可行区
设 Xi∼Uniform[0,θ],采用包含端点的密度版本,记 m=maxxi。非负样本的似然为
L(θ;x)=θ−n1{θ≥m},θ>0.
当 m>0,θ<m 时似然零,θ≥m 时随 θ 递减,因此 。
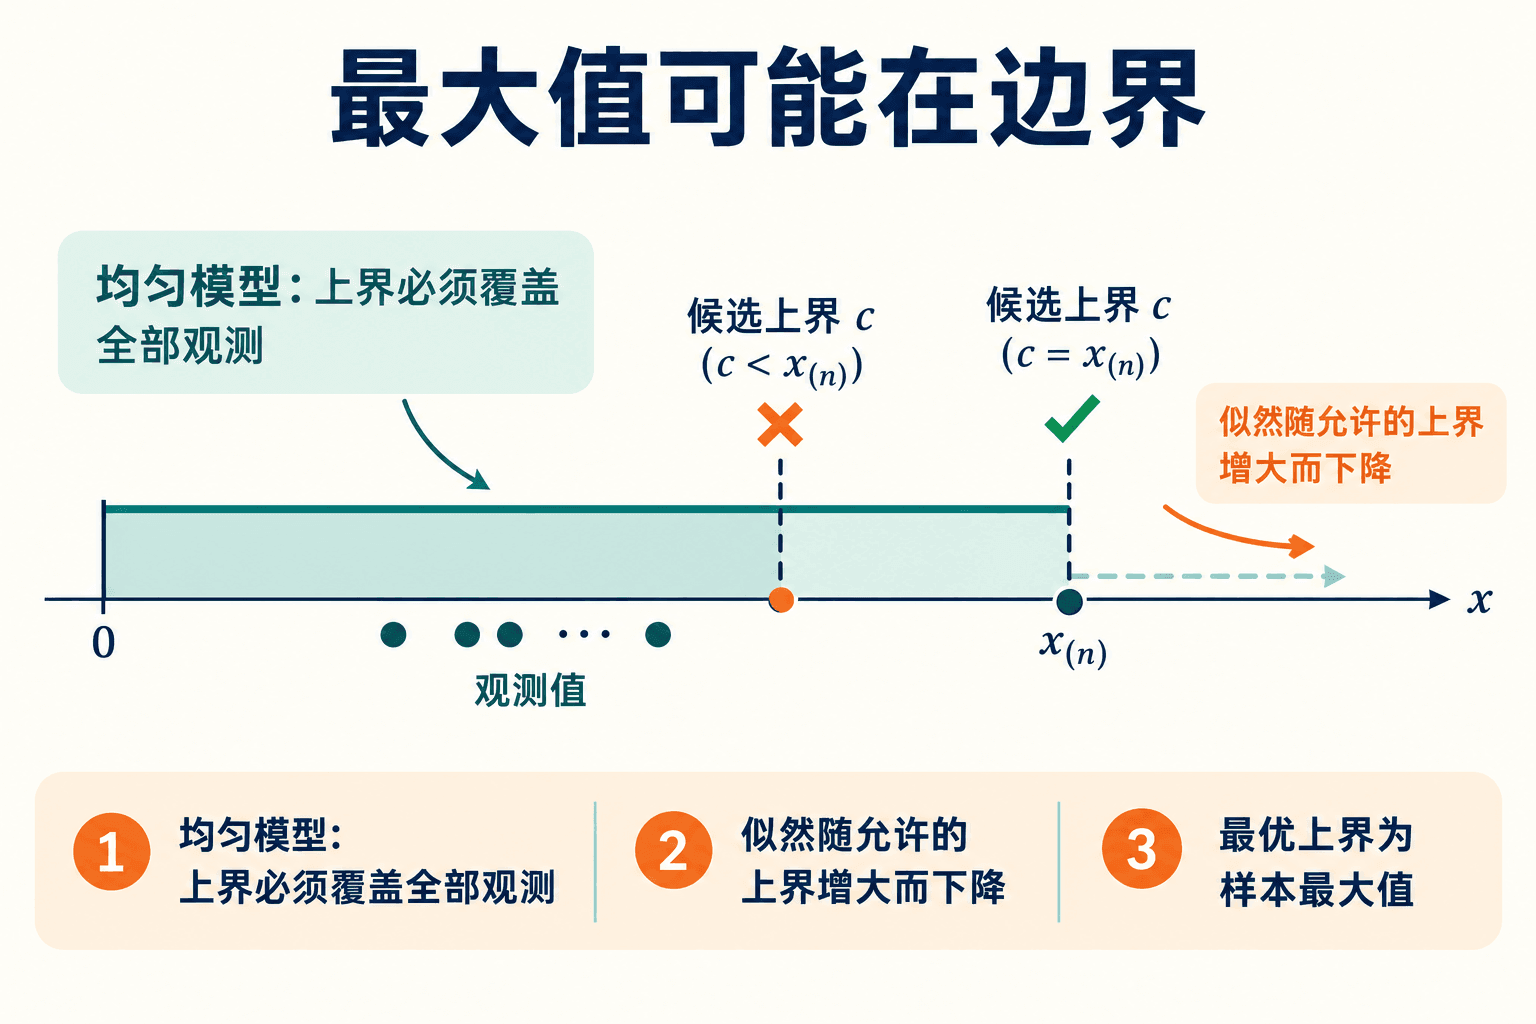 图 5-5:最大值可能在边界
连续均匀模型的端点概率为零,但密度在端点怎样写,会影响“最大值有没有达到”的表述。这里采用闭支持版本来定义常用的上界 MLE。你检查答案时也要带上支持指示函数,不能删掉后求导,再说没有解。
这个估计通常偏低,因为 E(M)=nθ/(n+1)。其偏差为 −θ/(n+1);无偏校正可取 (n。最大似然估计的一致性则可直接证明:对 ,
Pθ(∣M−θ∣>ε)=Pθ
估计偏低,并不妨碍它一致。不过,这个模型的支持随参数改变,后面常用的正则条件并不成立。即使都叫 MLE,也不能把正则模型的标准正态近似直接搬过来。
尺度缩小时的两种相反作用
在正态模型中,把所有观测的拟合误差平方和记为 Q,消去均值后有
ℓ(v)=C−2nlogv−
第一项随尺度缩小而提高密度峰值;第二项则惩罚“尺度太小却仍有观测离中心很远”。当 Q>0,两种作用平衡在 v=Q/n。若漏掉归一化中的 logv,便不再是同一个模型的似然;若 Q=0,第二种惩罚消失,常规正参数空间里的有限最大点也就消失。
这个竞争也说明为什么矩估计和最大似然有时相同、有时不同。对正态位置尺度模型,它们碰巧给出相同公式;在均匀上界模型中,似然中的支持限制要求候选上界覆盖最大观测,单独匹配均值却没有这个约束。方法差异来自它们具体使用的信息,而不是名字的优劣。
到这里找到了 MLE,还没得到无偏性、精确区间或正态误差。这些保证得各自证明。边界、删失、退化和不可识别的问题,也都应在写模型和计算时处理。
6. 截断记录的条件密度
删失至少留下了一条记录,告诉你“这个对象被观察过,事件还没发生”。现在换一种系统:它只保存等待时间小于 4 秒的对象,慢的连条目都没留下。假如手里只有筛选后的 n 个对象,也不知道筛掉多少个,每个保留值就要用下面的条件密度:
fλ(x∣X<4)=1−e
分母是进入记录的概率,依赖待估速率,删掉它就改了模型。这里也不能为每个被排除对象补一项生存概率,因为连对象数都不知道。若原始总数已知,就能把入选数量的信息一起用上;那已超出本节单纯的条件抽样模型。
设保留下来的五个等待时间为 0.2,0.6,1.1,1.3,2.1 秒,总和 W=5.3、平均 1.06。对数似然与平均得分为
ℓ(λ)=5logλ−λW−5log(1−e−4λ),
F(λ)=ℓ′(λ)/5=λ1−
如果忽略筛选机制,会得到 1/1.06≈0.9434。但保留下来的对象被刻意限制为较快对象,其平均时间本来就偏短;直接取倒数会把速率估得偏高。本节求解的是保留机制已经明确后的参数估计。
用二分法定位得分方程的根
二分法只需要连续得分 F 和异号的区间端点。这里 F(0.5)>0、F(1)<0,所以根位于 (0.5,1) 内。计算中点后,得分为正就将左端移至中点,为负则移动右端;每次保留的区间仍夹住根,无需特殊函数。
继续二分得到 λ^≈0.82373 每秒,低于忽略筛选得到的 0.9434。把它代回 F,平均得分接近零,再比较两侧值可以确认正负号转变。初始宽度 0.5,做 k 次对半后宽度为 0.5/2k。若以最终区间中点报告速率,绝对求根误差最多为最终宽度的一半;这是数值误差,不是统计标准误。二者来源不同,不能把算法算得更精确说成样本提供了更多信息。
还需要证明找到的是最大点。记 A(λ)=∫04e−λxdx,则条件密度也可写为 。对数归一化因子求两次导数,得到
dλ2d2logA(λ)
积分区间有限,参数邻域内导数有界,所以这里可以交换求导和积分。于是 ℓ′′(λ)=−nVarλ(X∣X<4)<,对数似然严格凹,刚才夹住的唯一根就是全局最大值。到这一步,数值解才有了最大点的依据。
Newton 法很快,仍然需要保护约束
若导数计算可靠,可用
λk+1=λk−F
它把当前点附近的得分曲线近似成直线,再去找直线零点。接近根时可能更快,但某一步也可能跳到负速率、跨过有效区间或降低似然。保留二分法的夹根区间,Newton 候选越界时改取中点,就能兼顾速度与可检查性。停止时同时检查参数有效、残差接近零、区间足够窄,并利用已证明的凹性判断全局性质。
7. 参数变换保留最大值,不保留所有统计性质
目标改为 η=g(θ) 时,一一变换只是给同一组候选分布重新标记,因此 η^=g(θ^)。此处没有把数据密度转换为参数概率密度,不需要额外乘参数 Jacobian。数据变量的密度变换是另一件事。
非一一变换同样可以通过剖面解释:Lη(η)=supθ:g(θ)=ηL(θ)。如果原最大点确实存在,它映射到的 会使剖面似然最大。例如 、方差已知,目标为 ,对每个 比较 与 ,可知目标 MLE 为 。
但 E(Xˉ2)=μ2+σ2/n,所以这个估计并不无偏。若取 消除偏差,结果又可能为负,超出目标值的非负范围。MLE、不偏性、参数空间和平方误差最优各自提出不同要求,不能用一个名字把它们全部包办。
8. 优化结果的检查与统计评价
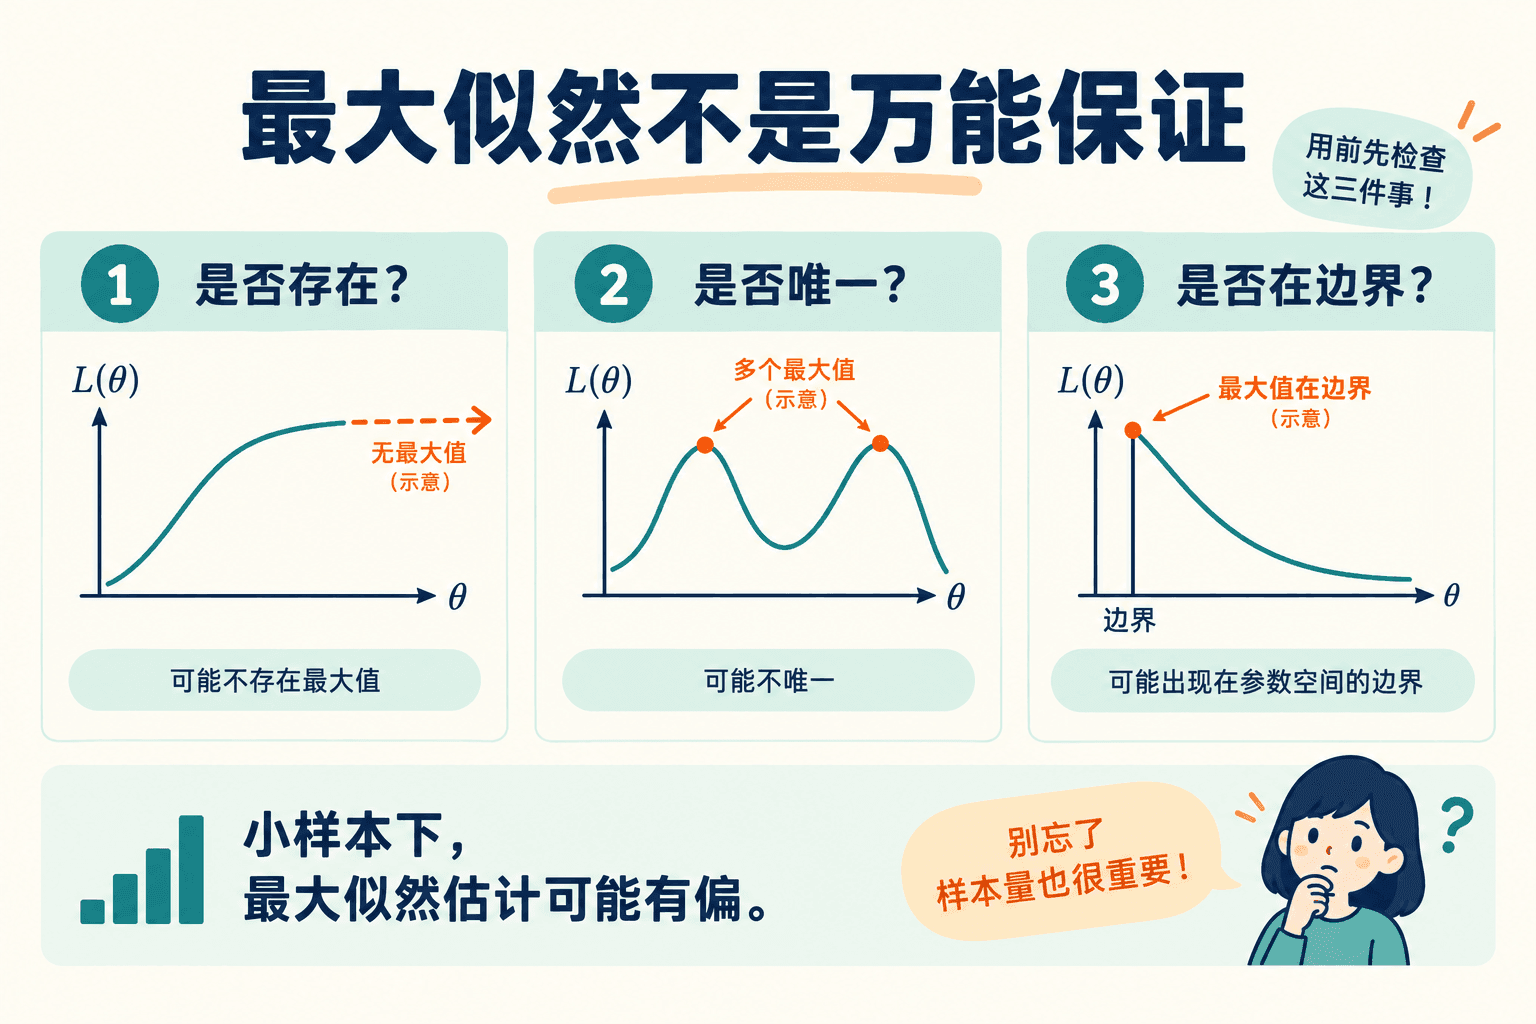 图 5-6:最大似然不是万能保证
最优点的存在性、唯一性和边界位置,决定了算法结果的含义。模型与记录机制也需要核对,偏差、方差及区间则属于后续统计评价。数值算法停止时,梯度和约束未必都已满足;结合其他候选及函数形状检查,有凹性时还能证明全局唯一最大。
手算和数值求根都以实际模型为起点,极值只能在合法候选中比较。下一章研究似然中的数据依赖:在某些模型里,参数信息只通过少数统计量进入。
似然比较的对象
2伯努利样本全部成功,且参数空间为开区间 (0,1),MLE 一定等于 1。
3正态样本量为 4,围绕样本均值的平方偏差和为 10。方差 MLE 是多少?
9. 练习:极值的依据与约束
练习 1|约束改变答案。 20 次伯努利试验成功 17 次,但模型要求 0.2≤p≤0.7。求 MLE,并说明它为什么不满足内点得分方程。
无约束峰值为 0.85。整个允许区间都在峰值左侧,得分为正,所以似然递增,受限最大点为 0.7。它位于边界,没有向右移动的可行方向,不需要一阶导数等于零。
练习 2|不同曝光时长。 三个独立窗口分别为 2、3、7 小时,事件数为 5、3、16。共同泊松事件率的 MLE 是多少?写联合模型和导数,而非只报一个平均。
Xi∼Poisson(λti),对数似然为 24logλ−。导数 在 2 处为零,二阶导数严格负,因此 每小时。曝光时长不同决定了分母为总小时数。
练习 3|剖面化与已知均值不同。 正态样本为 1,2,4,5。分别求均值未知、均值已知为 0 时的方差 MLE,并解释差异。
未知均值时 xˉ=3、Q=10,方差 MLE 为 10/4=2.5。均值固定为 0 时不能再拟合中心,平方和为 1+,方差 MLE 为 。均值限制产生了额外的 ,尺度估计会把这份偏离也计入。
练习 4|删失与截断。 六台设备统一观察到 8 秒,四台在 1、2、3、4 秒发生事件,其余未发生。求指数速率 MLE。若你只拿到前四个成功记录,且知道数据库只保留 8 秒内发生的对象,但不知道原始对象总数,似然应如何改写?
完整删失记录的累计暴露为 1+2+3+4+8+8=26,事件数 4,故 L∝λ,MLE 为 。只有截断样本时,每个密度须除以 ,故 。两份记录的信息不同,不能沿用同一个分母公式。
练习 5|数值误差的保证。 第 6 节从区间 [0.5,1] 开始二分,希望最终中点与根之差不超过 10−4,至少需要几次对半?为什么这个保证没有说明参数估计误差小于 10−4?
中点误差上界是 0.25/2k,要满足 2k≥2500,至少对半 12 次。这个界只控制同一份数据下近似根与精确 MLE 的差。估计离未知真参数有多远仍由抽样决定,多做迭代不会增加数据里的信息。
练习 6|边界与不存在。 五台设备都观察了 10 秒且无事件,在严格正指数速率参数空间中是否有 MLE?同样地,若只有一个正态观测且均值方差都未知,会发生什么?
前者 L=e−50λ,在 λ↓0 逼近上确界,但 0 不在严格正参数空间,所以无最大点。后者取均值等于唯一观测,令方差趋零,密度无界增大,同样没有合法的有限最大点。两者都不能把参数空间之外的退化值当作常规解。
练习 7|非一一变换。 已知正态总体方差为 9、样本量为 25。目标为 μ2,求目标 MLE 的偏差,以及一个无偏修正。说明为什么无偏修正不能自动叫作 MLE。
目标 MLE 为 Xˉ2,偏差为 9/25=0.36。Xˉ 无偏,但它不一定使关于 的剖面似然最大,而且可能为负。改变优化目标后得到的是另一条规则。
练习 8|支持能否被“常数化”。 对 Xi∼Uniform[a,a+2],已知宽度、未知位置。若样本最小值为 3、最大值为 4,求全部 MLE。若最小值为 3、最大值为 6,又怎样解释?
似然为 2−n1{xmax−2≤a≤x。第一种记录允许 ,整段区间的似然一样大,MLE 因此不唯一。第二种记录却要同时满足 、,没有任何候选支持这份数据。宽度假设、单位或录入可能出了问题,恒为零的似然无法支持有解释力的参数比较。