零假设施加约束后,最佳拟合会损失一部分似然,这是似然比检验的出发点。Wald 检验关注估计值与假设值的距离,得分检验则在零假设处检查局部变化。三种方法使用同一似然,却从不同位置计算。
最大似然、Fisher 信息与渐近正态构成这一章的基础。下面会在具体模型中比较三种统计量,解释信息的计算位置如何影响有限样本结果,以及卡方近似需要哪些条件。
1. 把三种证据放回同一个似然
先考虑一个标量参数 θ,检验 H0:θ=θ0。记全样本对数似然为 ℓn(θ),最大似然估计为 θ^,得分为 Un(θ)=ℓn′(θ),期望信息量为 In(θ)。
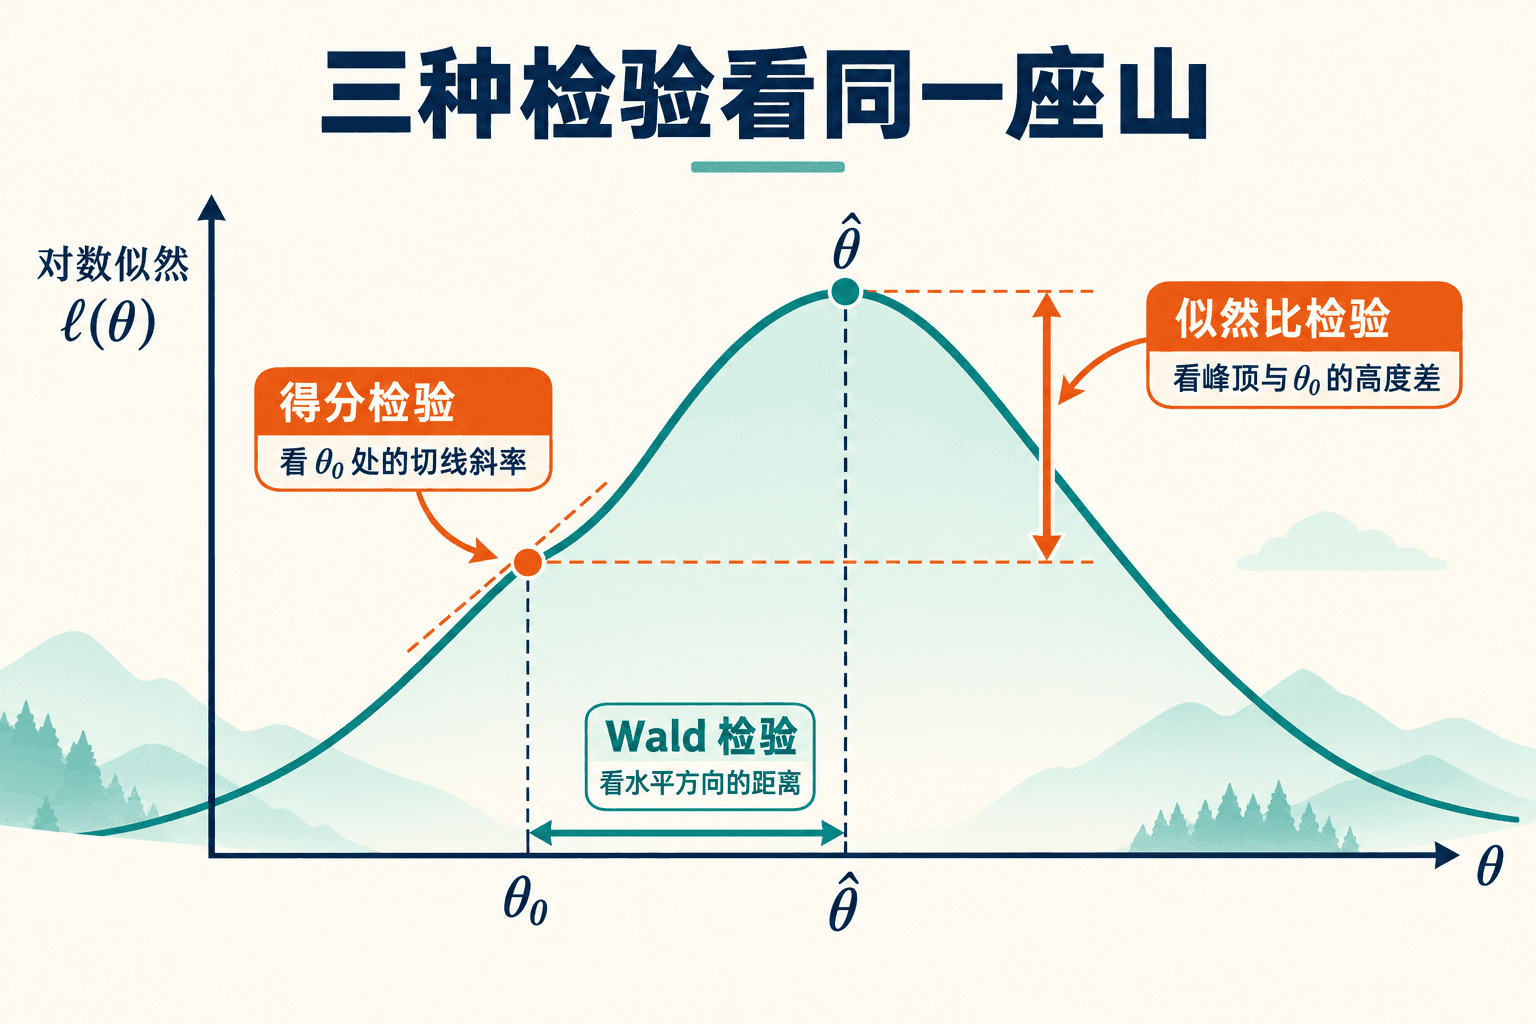 图 11-1:三种检验看同一座山
图里的高度差、距离和斜率提供了几何解释,数值比较仍需校准尺度。参数换单位会改变裸距离与斜率。似然比采用两倍对数似然差,Wald 用估计标准误衡量距离;得分的斜率则由零假设处的信息量标准化。
方差未知的均值检验会把这些位置差异显示出来。全模型与零假设约束下各有一次拟合,方差需要分别估计,不能视为已知常数。
决定不一致时需要核对校准
本章的一组数据在 5% 阈值处会让 Wald 拒绝,而似然比与得分不拒绝。这需要核对三者的近似及预定校准方法。算完才挑最小的 p 值,实施的已是多方法筛选规则,单次预定检验的解释不再适用。
高度、距离、斜率都来自同一个似然,但只有局部形状足够稳定时,三者才紧密对应。先算一个完全一致的特例,再看这种一致从哪里开始松动。
2. 似然比:约束造成的拟合损失
令全参数空间为 Θ,零假设子空间为 Θ0⊆Θ。定义
Λ=supθ∈ΘLn
受限模型的最优似然不会超过全模型,因此 Λ 不超过 1。比值越小,约束造成的拟合损失越明显。把它变为下面的统计量,数值就随证据增强而增大:
D=−2logΛ=2{ℓn(θ^)−ℓ
其中 θ~ 是受限最大似然估计。若最大值不达到,应按上确界定义,不能随意报告一个不存在的最优点。
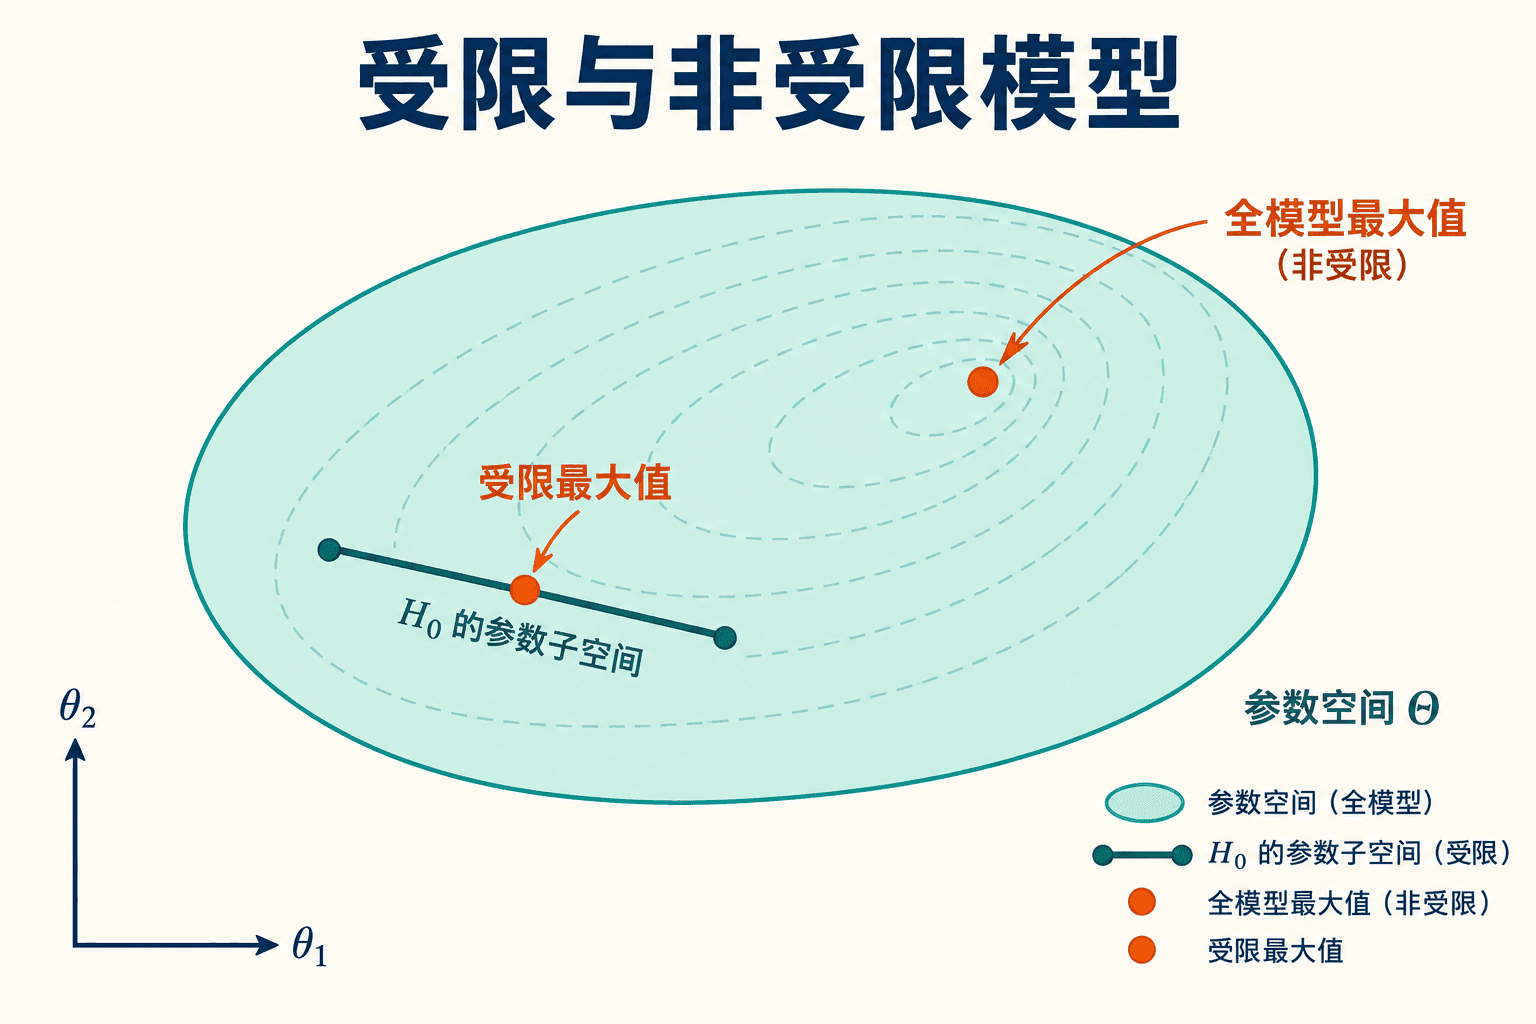 图 11-2:受限与非受限模型
在真实参数位于内点、模型可识别、似然足够光滑、信息矩阵非奇异、样本量增加而参数维数固定等正则条件下,零假设成立时有 Wilks 结论
Ddχr2.
r 数的是独立约束,也就是两个模型参数维数之差。二维参数受一个独立等式约束时,通常 r=1。别把它算成样本量减一,也别直接填全部参数个数。
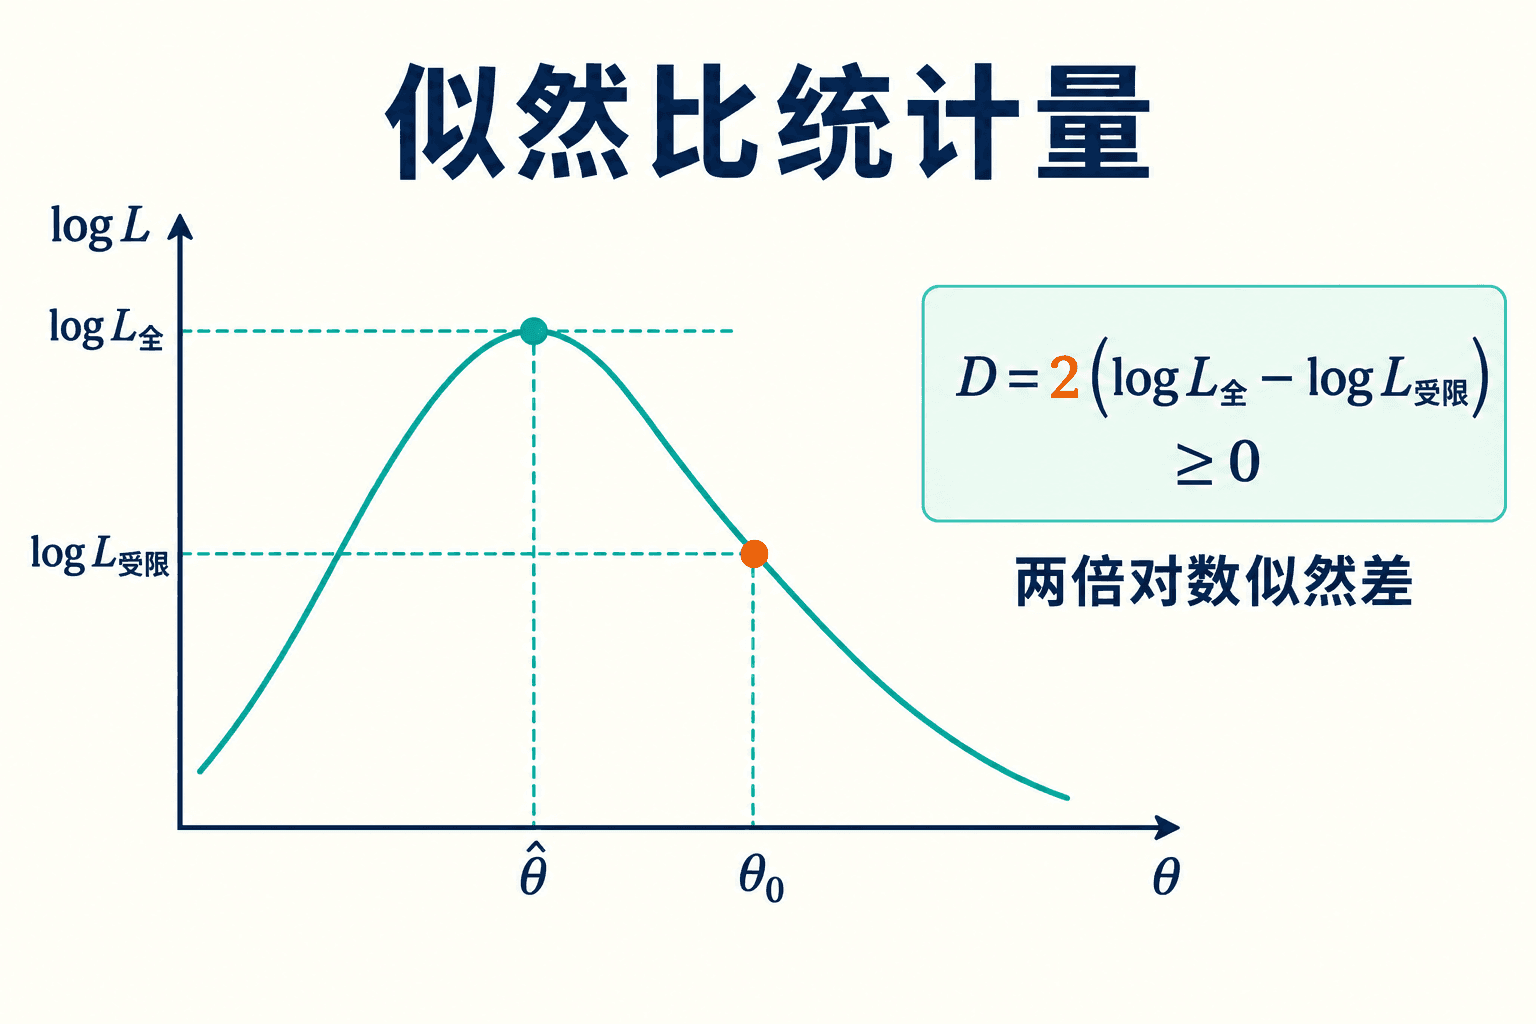 图 11-3:似然比统计量
大样本校准适用时, D>χ1−α,r2 就拒绝,近似 p 值取卡方右尾。统计量算对了,还得另查参考分布能否用,这两步缺一不可。
3. Wald:用标准误衡量距离
若正则条件下
SE(θ^)
平方后得到本章采用的 Wald 统计量
W=SE(θ^)
在常规标量最大似然模型中,可用 SE2=1/In(θ^);也可能使用一致的观测信息估计。关键是写明使用了什么方差估计。这里的 是信息;若写的是单个观测的信息 ,就需要乘 。
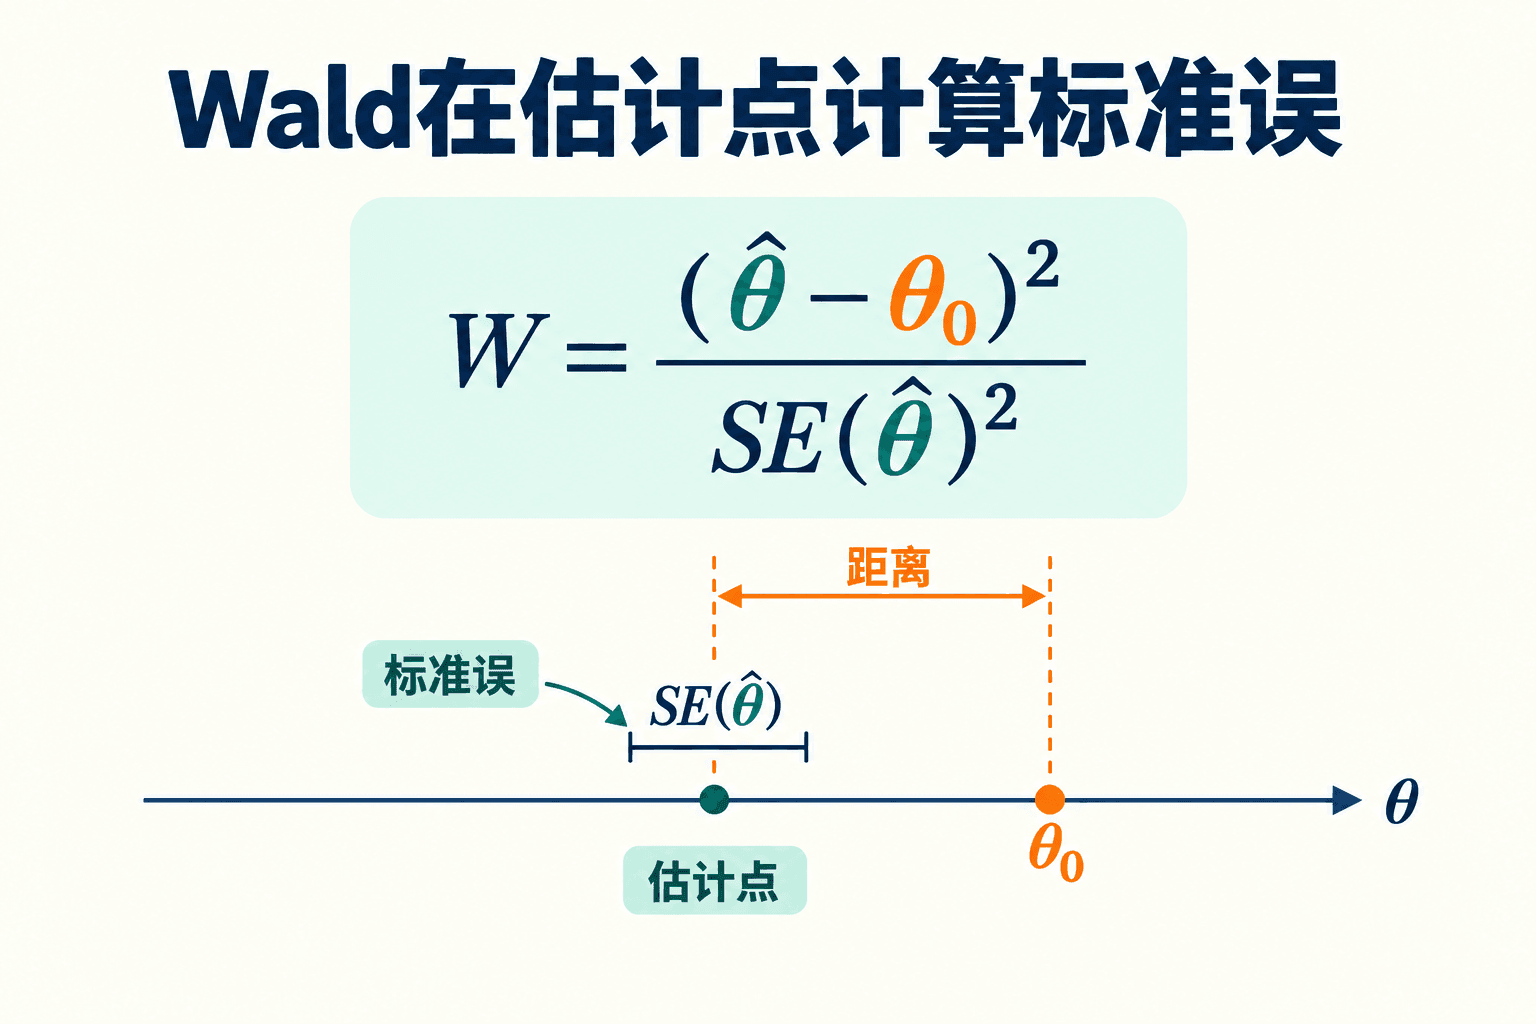 图 11-4:Wald 要选择估计点标准误
Wald 的方便在于,已有估计和标准误就能计算。但参数化、边界、方差估计都会影响它。伯努利全成功时, p^=1,代入方差 p^(1−p^,并不表示证据无限可靠;常规 Wald 标准化在这里已经失效了。
对向量参数及约束 g(θ)=0,Wald 用约束估计 g(θ^) 和它的协方差矩阵构造二次型,协方差可用 Delta 方法得到。具体地,设 g 有 r 个分量,导数矩阵为 ,估计协方差为 ,则
Wg=g(θ^)⊤[
这是第 8 章多元 Delta 的直接应用,需要 G 在真值处秩为 r、括号内可逆。若约束写成 g1(θ)=θ1−、,两行导数成比例,只有一个独立约束,不能套二自由度卡方或强行对奇异矩阵求逆。
4. 得分检验与零假设处的局部变化
把得分检验统计量记为 Rs,与样本标准差 S 区分。在标量简单零假设下,正则模型中得分满足零均值、方差 In(θ0)。由此构造
Rs=In(θ
这里两项都在零假设点计算,只需要做受限拟合。如果全模型很难求峰值,而零假设模型较容易,得分这条路径就可能省下不少计算。
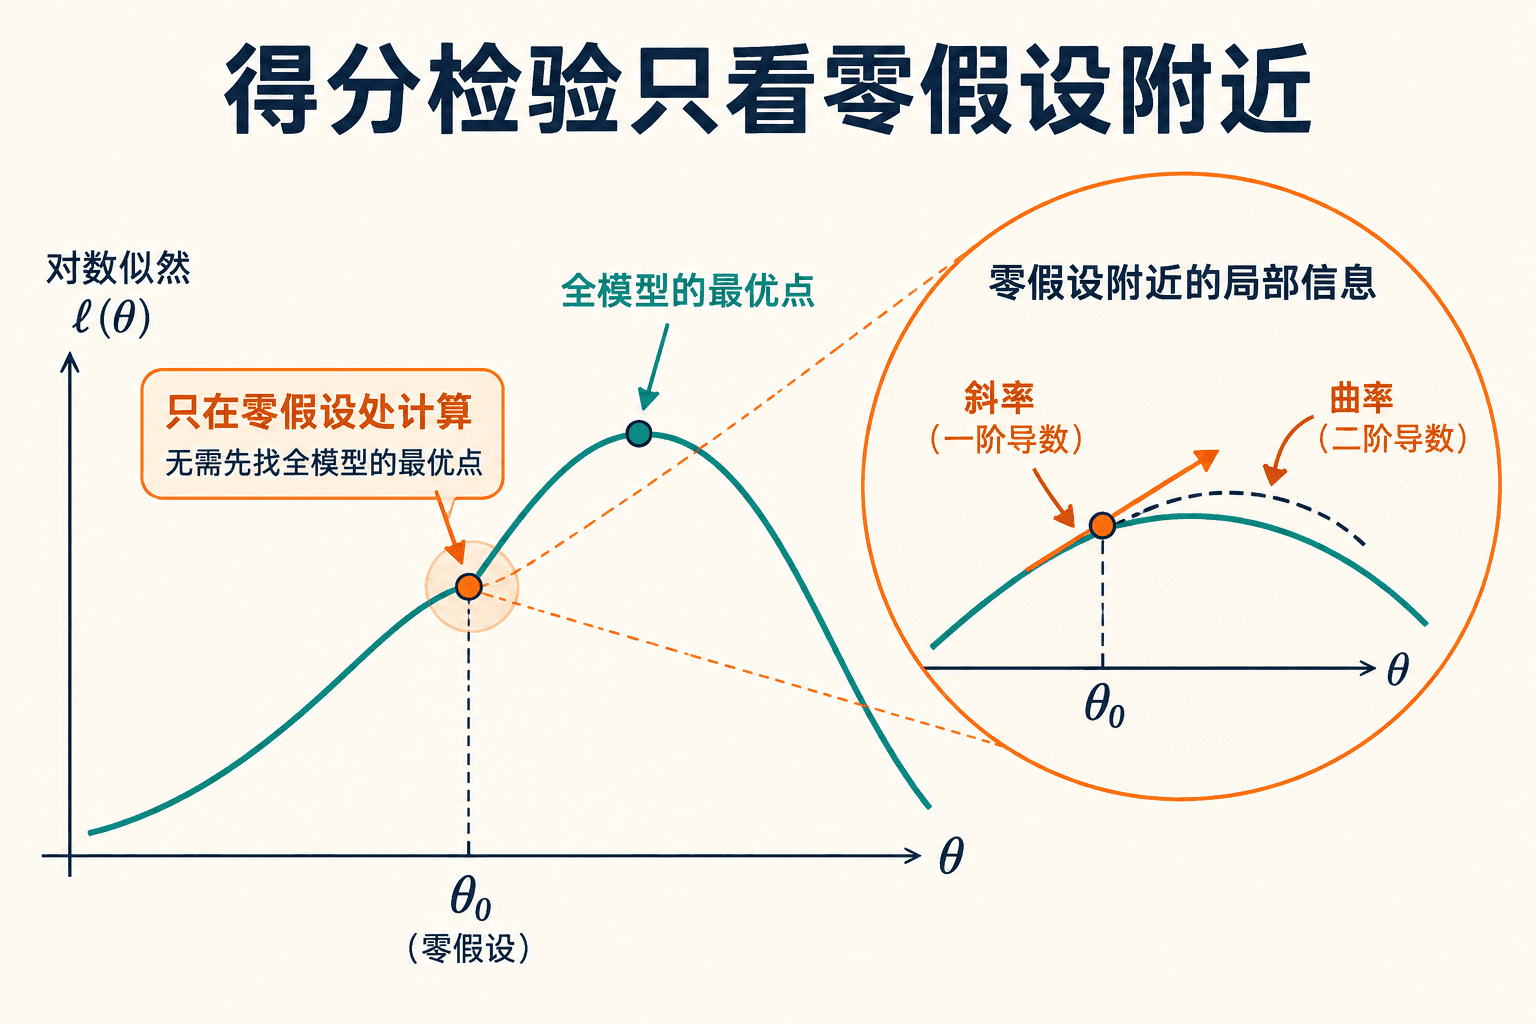 图 11-5:得分检验只看零假设附近
若还有干扰参数,不能照搬一个标量分母:应在受限估计处使用经过干扰参数调整的有效信息或对应矩阵形式。图中的局部斜率和曲率说明几何直觉,公式中的期望信息仍由概率模型定义,不一定恰好等于本次样本的负二阶导数。
Wald 的距离在估计点标准化,得分所需斜率则在零假设处计算。两式虽然都使用信息量,取值位置未必相同。
已知正态方差时三种统计量相同
设 Xi∼iidN(μ,σ2), 已知,检验 。三种构造都将得到 ,可以直接计算验证。
完成平方后,对数似然关于 μ 的变化为 C−n(μ−Xˉ)。最佳拟合与零假设的高度差乘以二,得到 。
原因就在对数似然的形状:它恰好是二次函数,曲率也不随参数位置变。伯努利对数似然就没有这种全局性质,峰顶和零假设处测出的尺度可能不同。
5. 方差未知,要分别拟合两次
设 Xi∼N(μ,v) iid,v>0 未知,检验 μ=μ。为免混淆,用 作方差参数,记
Q=∑(Xi−Xˉ)2,
第 5 章的完整似然优化给全模型估计 μ^=Xˉ,v^=Q/n。零假设固定均值后,平方和变为 ,所以受限估计为 。被限制的均值不能再吸收样本均值偏移,这部分偏离转入受限方差估计。一般 。
似然比:两个峰值分别代入
对固定的均值及其对应残差平方和 R>0,对数似然为 −nlog(2πv)/2−R/(2v),在 v=R 达到 。将 与 相减得
D=nlogQQ0=nlog
如果分子也直接用 v^,没有重新优化,就没算到受限最大似然。这里要求 Q>0;连续正态且 n≥2 时,它几乎必然成立。
Wald 与得分:方差估计的位置不同
单个观测的得分为 uμ=(X−μ)/v、uv。正态中心奇数矩为零、四阶矩为 ,因此全样本期望信息为
In(μ,v)=(n/v0
两个参数在期望信息意义下正交,不表示它们的所有有限样本估计性质完全相同。Wald 用全模型估计协方差的均值项 v^/n,得 W=nd2/v^=n。得分在受限点计算 、,这里交叉信息为零,无额外扣除,故
Rs=IμμU
同一 t 统计量的三个单调函数
令 t=nd/S,S2=。直接替换得到
D=nlog(1+n−1t
三者都随 t2≥0 严格递增。如果按 t2∼F1,n−1 作精确校准,把临界值也用同一函数变换,拒绝域和 p 值就一样。但若一律用渐近 阈值,有限样本的决定可能不同。
例如 n=10 且本次 t2=4,三个值约为 3.6772,4.4444,3.0769。直接与 χ 比较,只有 Wald 拒绝;精确 的 95% 阈值约 5.1174,则三种正确变换后的精确规则都不拒绝。这里区别来自校准,不是三套数据讲了互相矛盾的事实。
如果把 v^=Q/n 换成无偏的 S2,会得到数值为 t2 的另一种 Wald 型统计量。你可以选有依据的方差估计,但要交代选择;同一条推导里悄悄改分母,会让读者分不清是哪种规则。
6. 一批伯努利数据,三种答案
设 Xi∼Bernoulli(p) 独立,成功总数 k,样本量 n,。检验 对双侧备择,假定 。忽略不含 的常数,
ℓn(p)=klogp+(n−k)log(1−p).
三种统计量分别为
D=2[klogp0
W=p^(1−p
似然比公式在 k=0 或 n 时使用 0log0=0 的连续延拓;Wald 分母为零时则不报告普通近似结果。得分公式来自
Un(p0)=
取 n=40,k=26,p0=0.5,用 χ12 近似校准:
在 0.05 附近,决定确实可能不同。此时应按模型、样本条件和预定方法报告,不能挑最小的 p 值;必要时采用有依据的精确校准。比例估计为 0.65,比零假设高 0.15,这部分效应信息也不应被拒绝与否代替。
实验:同一批数据,三种统计量
n=40、k=26、p₀=0.5 的计算结果接近 5% 阈值。根据上面的表格,判断三种近似检验是否会作出相同决定。
默认结果可与移动 p₀ 后的变化比较。零成功预设显示边界退化,扩大十倍样本则用于检查样本量的影响。
默认数据下,Wald 拒绝,LR 和 Score 不拒绝;p̂ 到边界时,Wald 连标准化都无法照常完成。
Wald 的方差尺度取自估计值,Score 取自零假设,LR 则计算实际似然损失。渐近时相近,并没有保证手中这批有限样本下三者相同。
7. 渐近等价的推导与失效条件
几何上的局部二次近似可以写成带余项的计算。考虑单参数点零假设,沿用第 8 章条件:MLE 一致且 n(θ^−θ0,两点之间的随机位置满足 。后者依赖局部一致控制,固定真值处的大数定律还不够。
在峰顶向 θ0 作 Taylor 展开,因为 ℓn′(θ^)=0,存在两点间的 使
D=−ℓn′′(θ∗)(
余项为 oP(1) 的依据是:曲率误差除以 n 后趋零,而相乘的 n(θ^−θ 在概率上有界。第 8 章的乘积规则保证其贡献消失。
得分的一阶展开为 0=Un(θ^)=U,因此 。平方后除以 ,可知 与同一二次量相差 。
Wald 中有 I1(θ^)P,所以也与该二次量只差 。零假设下,MLE 的正态极限经平方映射得到 。这里证明了 、 ,比仅有相同极限分布更强;后者不足以推出同一批统计量之差趋零。
 图 11-6:卡方近似的适用边界
真参数处于边界、零假设下参数不可识别或信息矩阵奇异,都可能使校准失效。支持移动与有效事件数过少也需要检查。比如混合模型的零混合权重,不能仅凭少了一个参数就套普通卡方。
这时可以找模型允许的精确分布,或在零假设下设计并验证模拟校准。采用模拟要写清生成机制、干扰参数怎么处理、种子和模拟误差。下面这些交互采用确定性数值计算,未做的模拟不能算作已有验证。
从目标得分中扣除干扰方向
把参数分为目标 ψ 与干扰向量 η,信息分块为 Iψψ,Iψη, 等。在已指定参数处,得分的均值为零、协方差为信息矩阵。考虑把目标得分中的线性可解释部分去掉:
Ueff=Uψ−Iψ
计算它与 Uη 的协方差,得到 Iψη−I。展开自身方差便得
Ieff=Iψψ−I
这就是有效信息,由信息矩阵分块消元得到。受限拟合通常令 Uη=0,分母却仍要调整,不能因分子那项为零就删掉交叉信息。举例,全样本信息为 (124,受限目标得分 5,有效信息为 ,统计量应是 ,不能写成 。
从似然的局部二次形式也能看出同一结果:固定目标方向位移后,让干扰位移取使二次损失最小的值,解线性方程给 hη=−Iηη−1Iηψ;代回剩下的目标曲率正是 。全参数 Wilks 结论中的约束维数,是这些无法由干扰方向消去的独立方向数。本章完整证明标量联系,并用这个分块推导解释多参数结构;更一般的光滑约束定理需要对应的局部展开条件。
边界参数下的混合参考分布
设 Xi∼N(μ,σ2)、σ 已知,但参数限定 μ≥0,检验 。全模型 MLE 为 。若 ,受限与全模型拟合相同,;若 ,。零假设下 标准正态,所以
D=(max(0,Z))2.
分布有一半概率恰好在零点,另一半来自正态正半轴的平方,即 21δ0+21,其中 是零点质量。普通卡方没有这块原子质量,所以不能直接替代。对 ,有 ,5% 阈值约为 。若还用 3.8415,实际只消耗约 2.5% 的误拒概率。边界拿掉了一个可移动方向,参考分布也随之改变。
把得分检验反过来解,得到 Wilson 区间
第 9 章的 Wilson 公式,可以直接从“保留得分检验不拒绝的 p0”算出来。先写接受条件:
p0(1−p0)n(p
在 0<p0<1 时乘以正分母、展开并把项移到同一边,得到
(n+z2)p02−(2np
二次项系数为正,保留值位于两根之间。求根公式整理后即得第 9 章的 Wilson 上下限。这是将候选 p0 留在检验条件中反演的结果,并非对 Wald 凭经验添加修正数。
Wald 则把方差中的未知量先替换成 p^,再解对称的距离条件;两种顺序不同,得到的区间当然不必相同。似然比反演保留对数似然损失不超过阈值的参数,通常需要数值求根。下面把三种集合同时画出来,观察接近边界时的差异。
三个区间都标 95%,并不表示都有精确的有限样本 95% 覆盖。反演会继承原检验的校准,来自渐近卡方或正态检验的区间,通常也只有渐近保证。
实验:把没被拒绝的候选连起来
本模型的得分接受条件是一个二次不等式。由开口方向与两根的位置,判断保留的候选参数会形成怎样的集合。
移动 p₀,观察“保留/排除”状态与竖线穿过区间的关系。“8 次 1 成功”和零成功预设适合比较接近边界时的差异。
Score 不等式的两个根给出 Wilson 区间,端点与检验判断对应。Wald 则可能越出 [0,1],或退化为一个点。
这些留下来的参数值构成置信集合。LR 的端点要解“对数似然损失等于临界值”,因此用到求根。三种方法都用了近似校准,不能只因区间画出来了,就声称有限样本覆盖精确。
认清构造点与约束数
1本章伯努利得分统计量使用的信息量,应在哪个参数点计算?
2同一数据的三种检验给出不同结论时,挑出最小的 p 值仍是原先那条 5% 检验。
3全模型有 5 个参数,零假设通过独立光滑约束剩下 2 个自由参数。正则 Wilks 近似的自由度是多少?
8. 练习:拟合与参考分布的选择
练习 1|受限方差要重算。 iid 正态数据 n=12,xˉ=4,S2=9,检验均值是否为 3。求全模型与受限模型的方差 MLE,再算 D,W。
Q=11⋅9=99,Q0=99+12=111,两方差估计为 与 。,,。三个式子的方差位置来自各自构造;不能把 无解释地代替两个 MLE。
练习 2|精确阈值也须变换。 正态未知方差均值检验 n=7,记 c=F0.95,1,6。写出三种统计量各自的精确 5% 阈值,并说明为何决定一致。
阈值分别为 7log(1+c/6)、7c/6、7c/(6+c)。三者都是 t 的同一对应函数在 c 处的值,且严格递增,因此拒绝事件全部等价于 。若统一改成 3.8415,就换成三种不同的渐近校准,失去有限样本同一拒绝域。
练习 3|调整干扰信息。 受限拟合处全样本信息为 (18669),目标得分为 7,干扰得分为零。求有效信息和得分统计量;解释干扰得分为零为何不取消调整。
有效信息为 18−36/9=14,统计量 49/14=3.5。干扰得分为零是本次受限优化的一阶条件;其随机波动与目标得分在重复抽样中相关,仍需通过信息矩阵扣掉可由干扰解释的方向。
练习 4|渐近等价不能只比较分布名称。 已知两个统计量都收敛到标准正态,能否推出它们的差趋于零?用 An=Z,Bn=−Z 说明;再指出正文对三种检验多证明了哪一步。
两个序列每项都标准正态,但差为 2Z,不会依概率趋零。正文把 D、W、Rs 都写成同一个样本相关二次量 nI1(θ 加 ,因此它们的差才是 。仅列出三个卡方极限不够。
练习 5|数的是约束秩。 三维参数受 θ1=θ2 和 2θ1= 约束。零假设剩多少自由参数,正则 Wilks 自由度多少?若再加 呢?
前两个等式只有一个独立约束,零假设二维,自由度 3−2=1。增加第三坐标为零后有两个独立约束,零假设一维,自由度为 2。重复书写相同限制不会增加信息或改变模型维数。
练习 6|边界混合分布。 在正文 μ≥0 的正态模型中,观察到 Z=1.8。求 D 及基于精确边界分布的右尾 p 值,并与错误地套普通 χ12 的 p 值比较。
D=3.24。精确 p 值为 P(Z≥1.8)≈0.03593,普通一自由度卡方右尾为 P(∣Z∣≥1.8)≈,多计算了不允许的负方向证据。若本次 D 恰为零,用包含等号的右尾定义得到 p=1,不能误报为 0.5。
练习 7|反演的边界。 n=16、全部成功,从得分二次不等式直接求 Wilson 区间,以 z=1.96 表示端点。它是否就是双侧精确二项区间?
代入 p^=1,两根为 n/(n+z2) 和 1,故区间约为 [0.8064。这是得分近似反演,精确等尾二项下端则为 ,两者构造和覆盖性质不同。正宽度只修复了一种退化,不能自动升级为精确保证。
练习 8|设计一个可复核的比较。 软件给同一批数据三种 p 值,只有一个小于 0.05。写出报告前要核对的拟合、信息尺度和校准问题;如何避免把比较变成事后挑选?
全模型和受限模型都需正确优化,干扰参数不能被错误固定。信息采用的样本尺度,以及协方差和参数化,也应与构造相符。参考分布若为渐近卡方,还须核对内点、识别和样本条件,不能当作精确有限样本结果。按预定主方法报告,其他结果可作为明确标注的敏感性比较,效应与区间一并给出。最小 p 值不能冒充预定单次检验。