“估得好”需要明确的评价标准。平方误差下,偏差与波动可以放在同一个式子中比较;样本不断增加时,还要研究误差概率的极限。
1. 一次估计与一条估计规则
一个估计长期平均完全正确,每次却波动很大;有些略带偏差的规则,反倒通常离目标更近。“无偏”本身无法决定该选哪个。误差的代价需要用损失函数说明,由此才能比较固定样本量下的表现。样本不断增加时的性质,则属于另一个问题。
设 T 估计 θ。偏差定义为
bθ(T)=Eθ(T)−θ.
如果对参数空间中每个 θ 都有 Eθ(T)=θ,则 T 是无偏估计量。只在一个特定参数处碰巧无偏,不足以称为对整个模型无偏。
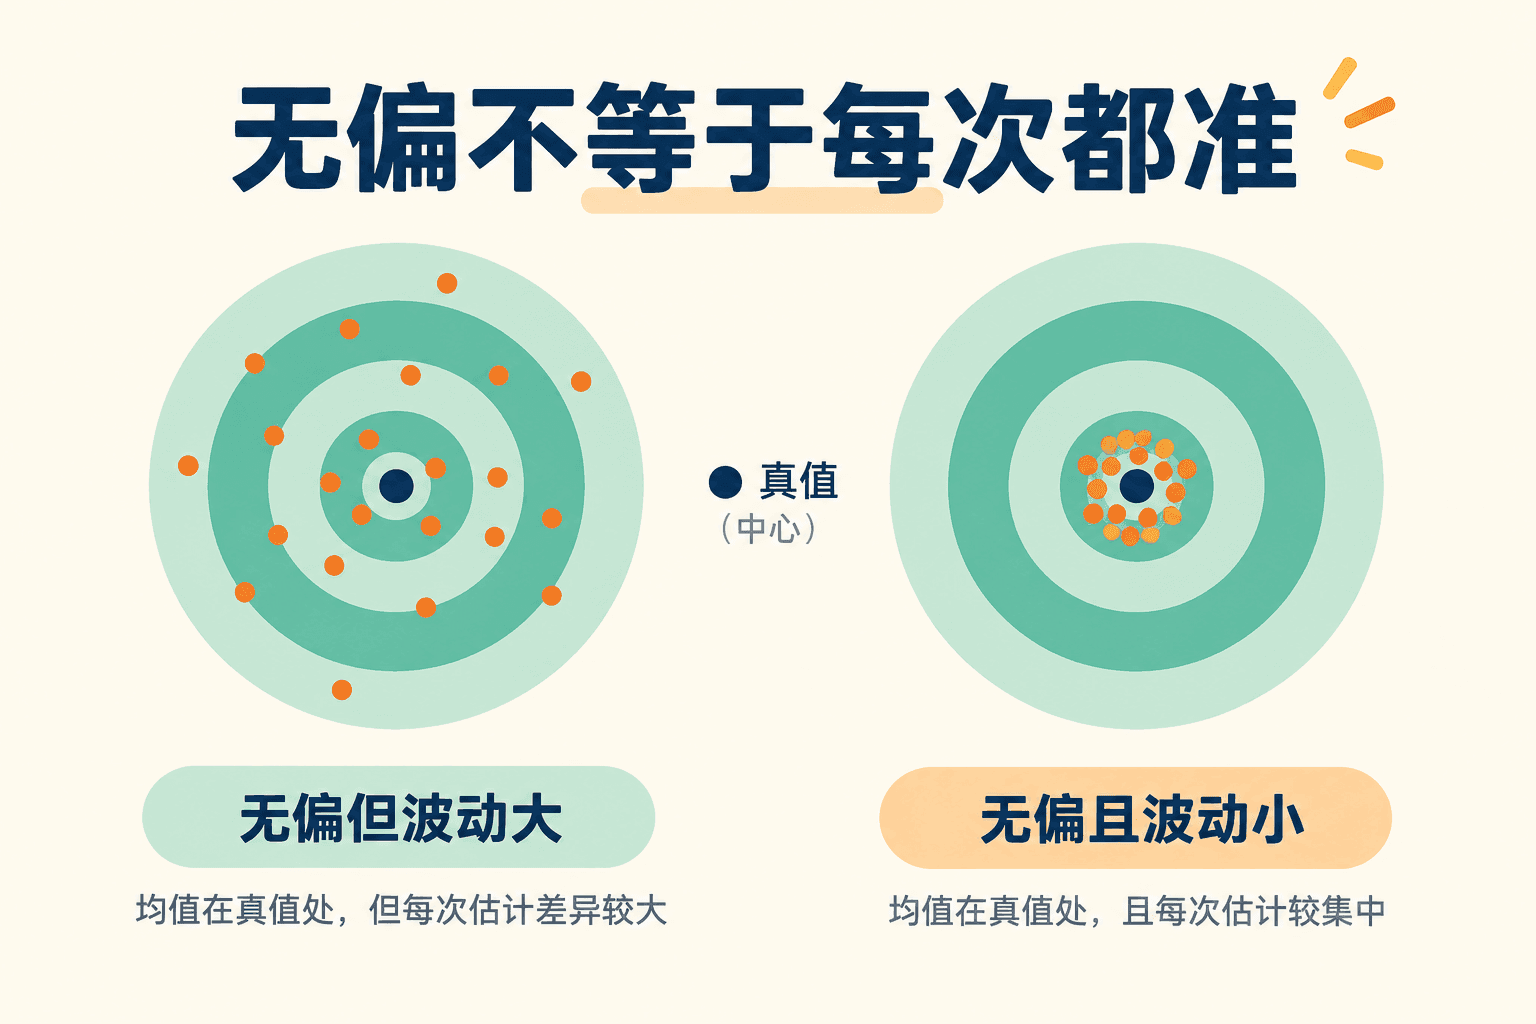 图 3-1:无偏不等于每次都准
图里的靶心代表真值,散点来自同一估计规则的重复运行。无偏只说这些结果的分布中心对准了靶心,并没有保证每次命中;方差 Varθ(T) 才描述它们围绕中心散得有多开。
在 iid 且有限方差模型中,Xˉ 是 μ 的无偏估计,方差为 σ2/n。只用 X1 也无偏,但方差是 。当 时,利用全部样本能显著降低波动。
长期平均正确,每次却都差一点
用一个构造例子可以看清差别。目标均值为 10,规则一等概率报出 8 或 12,规则二总报 10.5。前者长期平均正确,每次却错 2;后者只偏高 0.5。两种规则的平方误差分别为 4 和 0.25,无偏的那一个在这里并未占优。
这并不意味着总报 10.5 是个好办法。真值换成 20,它就会差得很远。例子只能说明无偏未必更好;可执行的规则不能偷看真值后才确定,评价也需要覆盖允许的参数范围。
2. 损失函数决定风险的比较方式
把真实参数写成 θ,实际报告值写成 a。一次报告的误差代价由损失函数 L(θ,a) 描述。对规则 T(X) 的损失取重复抽样的平均,得到风险函数 R。这里参数固定、样本随机,风险仍然是未知参数的函数。比较的是整条风险曲线,实际分析不能借助未知真值挑选某一点的赢家。
平方损失适合特别重视大误差的任务。若只按误差绝对值付出代价,就应使用 ∣a−θ∣。二者未必给出相同排序。考虑目标为 0 时的两种误差分布:A 以概率 0.99 等于 0、以概率 0.01 等于 100;B 恒等于 2。A 的平均绝对误差为 1,小于 B 的 2;但平方风险为 100,大于 B 的 4。没有先指定损失,“A 更准”就缺少含义。
如果供货不足比库存过量代价更高,还可以用 c1(θ−a)++c2(a−,其中 、。这门课主要用平方损失,是因为它便于精确分解。换一个任务,损失也可能需要跟着换。
如果对全部 θ 都有 R(θ,T1)≤R(θ,T2),并在至少一处严格小于,就说 在指定损失下支配 。两条风险曲线相交时没有这种全参数排序。只在某一段参数范围领先的收缩估计,不能据此被宣布普遍更好。
把均方误差拆成偏差和波动
平方损失衡量一次估计错了多少:(T−θ)2。对所有可能样本取平均,得到均方误差
MSEθ(T)=Eθ[(T−θ)
在二阶矩存在时,写 T−θ=(T−ET)+(ET−θ) 并展开,交叉项的期望为零,于是
MSEθ(T)=Varθ(T)+
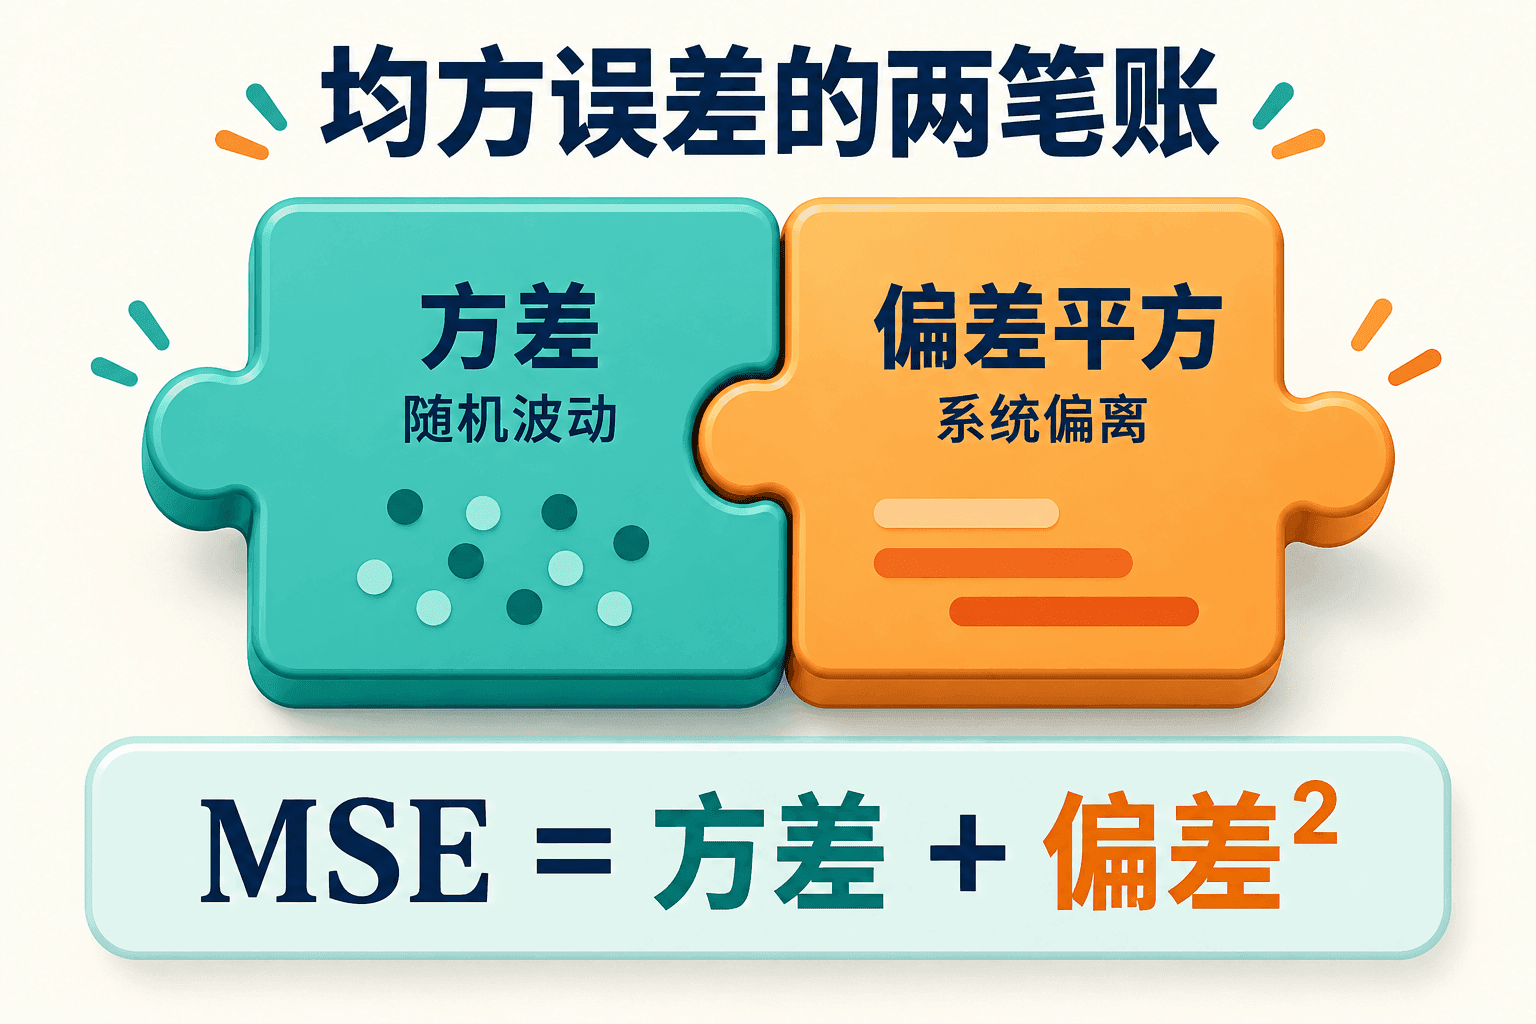 图 3-2:均方误差的两笔账
算到这里别忘了:偏差有正负,MSE 里放的是偏差平方。若偏差为 −2、方差为 3,结果应是 7,不会是 1 或 5。单位也能帮你核对:参数用秒,MSE 就用秒平方。
无偏估计之间比较 MSE,只需比较方差。允许有偏后,减少的波动有时足以抵过偏差平方带来的损失。因此,无偏是否属于任务约束,会影响候选规则的范围。
3. 样本方差的无偏校正
记 Q=∑(Xi−Xˉ)2。只要 iid 且方差有限,前章的平方和恒等式仍成立,即使总体不正态。取期望得
E(Q)=nσ2−nE[(Xˉ−μ
所以 S2=Q/(n−1) 是 σ2 的无偏估计,而 V 的期望是 ,偏差为 。
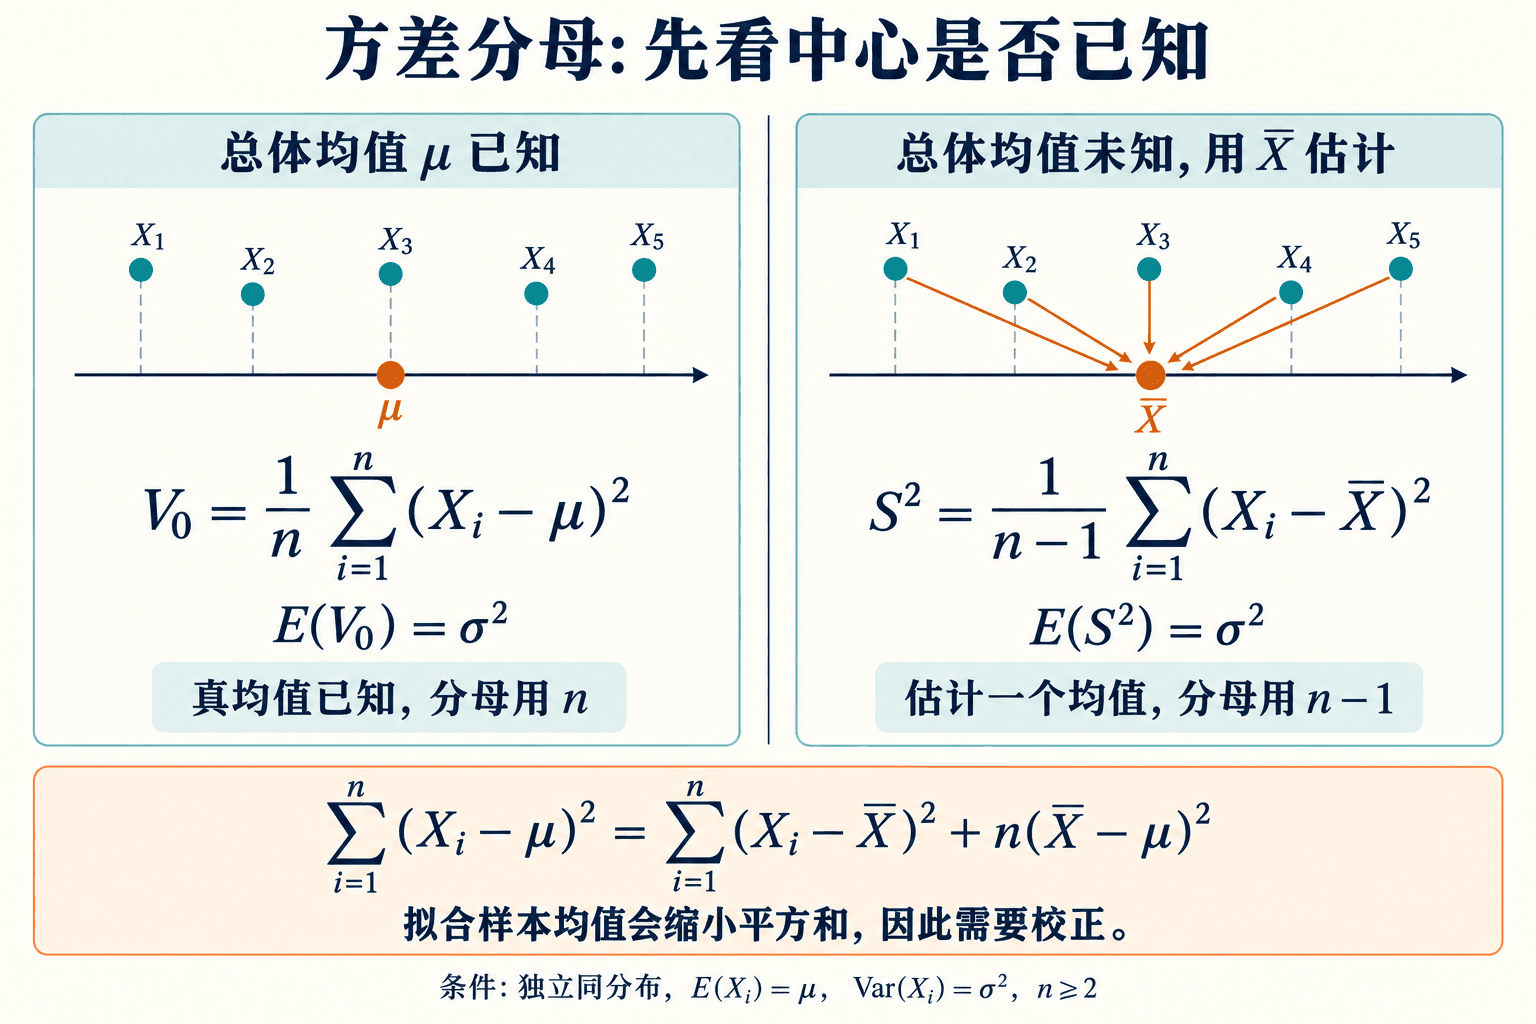 图 3-3:已知真均值与估计样本均值,需要不同的无偏校正分母
样本均值是为这批数据拟合出来的中心,围绕它的平方和被压低了。但这并不表示分母用 n 就一定算错,还得看你要满足什么评价目标。第 5 章从正态模型做最大似然时,会自然得到分母 n。
进一步在正态模型下,Q/σ2∼χn−12,因而
MSE(S2)=n−12σ
以 n=5 为例,前者为 0.5σ4,后者为 0.36σ4。有偏的 V 在这里 MSE 更低,却不能据此宣布它在所有目标下更好:如果任务明确要求无偏,它就不满足该约束。
无偏性未必能保留到开平方之后。即便 S2 无偏,S=S2 通常也不是 的无偏估计。这里发生的是非线性变换。
常数倍方差估计中的最优分母
Q/n 的平方风险已经小于 Q/(n−1),但还可以在一个明确的候选类中寻找最小值:考虑 Tc=cQ,其中 允许依赖已知样本量,不能依赖未知方差,也不能看过 后才确定。令 ,卡方矩给出
E(Q)=kσ2,E(Q2)=k(k+2)
第二个等式来自 E(Q2)=Var(Q)+(EQ)2。直接展开损失,得到
σ4R(σ2,
系数 k(k+2)>0,故这一类中最好的规则是 Q/(n+1),风险为 2σ4/。当 时,三个分母 4、5、6 对应风险系数分别是 。最后一个故意进一步偏低,以减少波动;它的偏差为 。
对每个 σ2>0,刚才的比较都成立,因为共同正因子是 σ4。所证明的最优性仅限于 cQ 类;其他形状的估计规则或其他损失函数,没有进入这次比较。
无偏校正很普遍,刚才的风险公式却依赖正态
无偏性只用了二阶矩;方差估计量的方差涉及四阶矩。为看清区别,设 n=2,每个观测等概率为 +σ 或 −σ,均值为零,方差为 σ2。两个观测同号时 Q=0,异号时 ,各占一半。因此 与无偏公式一致,但 ,并非正态情形的 。
重新计算会得到 R(cQ)/σ4=2c2−2c+1,最佳常数是 c=,并非正态模型下的 。这个反例把条件分开了:总体方差存在,并不保证样本方差服从卡方。若总体四阶矩无限, 甚至可能无偏,平方风险却无限。
开平方造成的向下偏差
x 在正数上严格凹,Jensen 不等式给 E(S)≤E(S。当 有非退化分布时不等式严格。因而无偏方差估计开根号会系统偏低。这里的解释不依赖把根号作近似展开,也说明“对无偏估计作任意函数变换仍无偏”为什么不成立。
4. 收缩:用一点偏差换波动下降
考虑 Ta=aXˉ,其中 0≤a≤1 为事先指定的常数。它把估计往参考点 0 拉近。计算可得
bμ(Ta)=(a−1)μ,Var(
MSEμ(Ta)=na
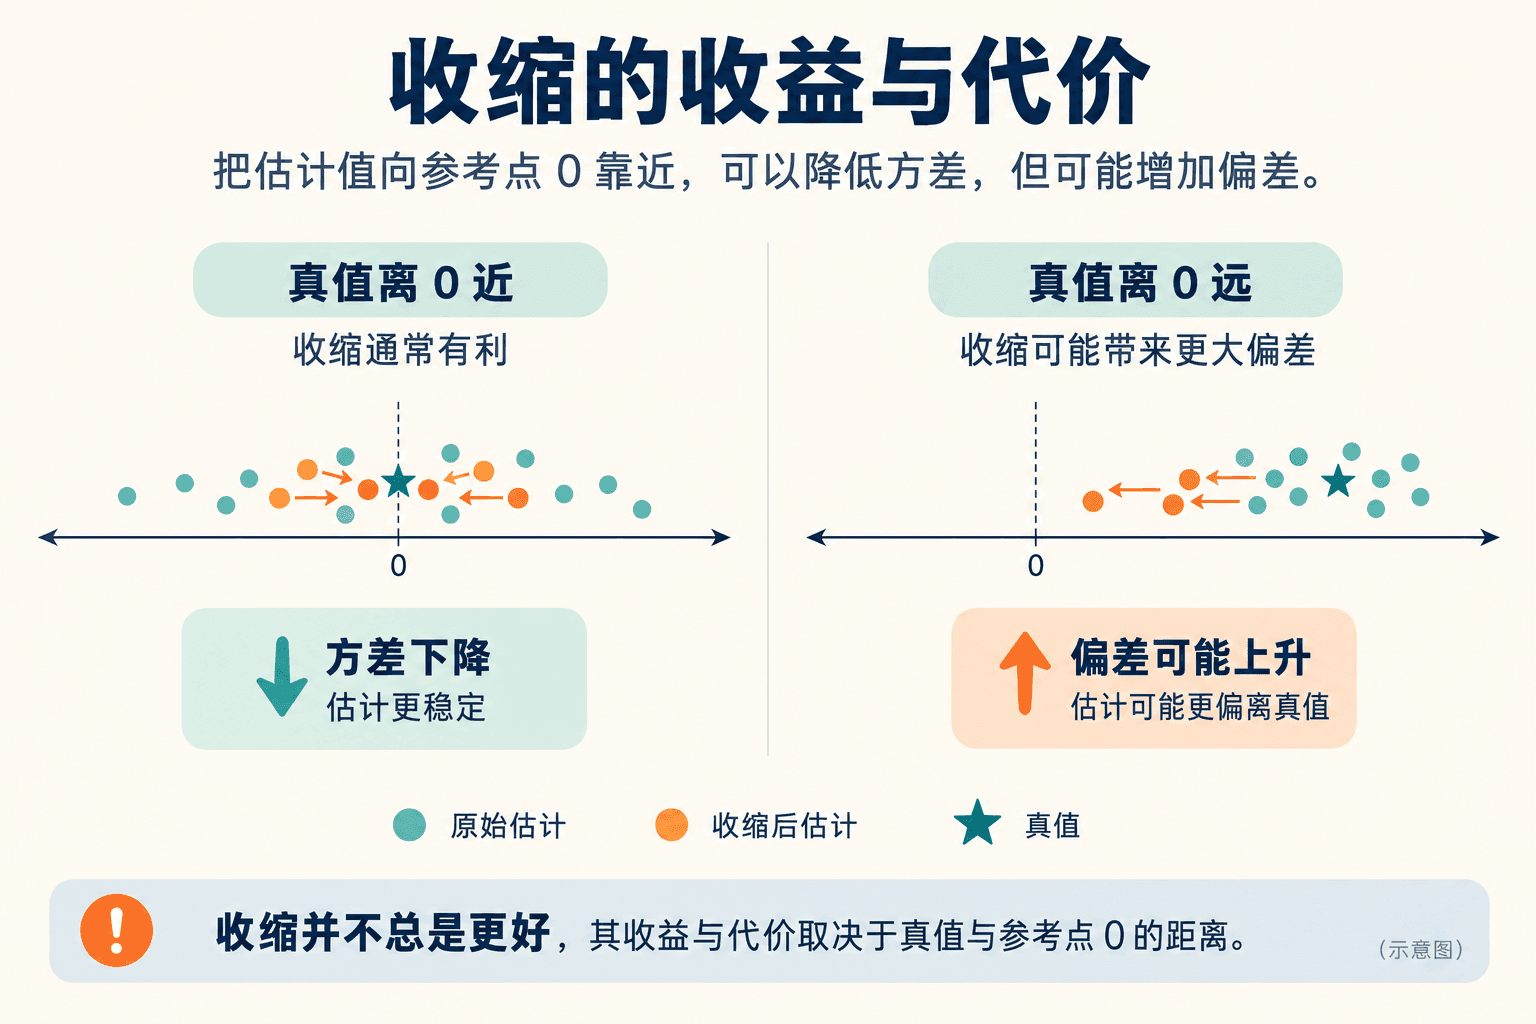 图 3-4:收缩的收益与代价
完整比较。 假设 σ=4,n=16,a=1/2。样本均值的 MSE 为 1;收缩估计的 MSE 为 1/4+μ。因此当 时收缩更好,当 时更差。在 时,MSE 从 降至 ;在 时却升到 。
收缩是否划算,原来还取决于参数在哪里。但实际选择 a 时,真值恰恰不知道,不能照着真值挑完,再把结果当作可执行算法。参考点和收缩强度都需要事先的依据,或者一套明确的数据分析规则。
实验:收缩估计的风险交叉
将样本均值减半,会降低方差,却把估计拉向 0。μ 从 1 变为 5 时,偏差的变化值得在计算前判断一下。
保持 a=0.5、σ=4、n=16,分别观察真值 1 和 5 处的风险。a 与 n 的调整可以显示优势区域怎样变化。
μ=1 时,收缩 MSE 为 0.5;到了 μ=5,这个值增至 6.5。样本均值的 MSE 始终是 1。风险曲线的交叉表示有限样本下的优劣取决于参数位置。
分解式中,方差减少量不随 μ 改变,偏差平方却随 μ² 增长。因而同一平方损失下的比较,也需要说明针对哪些参数。
5. 一致性不是每次都更接近
现在让 n 逐渐增加,对应得到一列估计量 Tn。对任意固定 ε>0,如果都有
Pθ(∣Tn−θ∣>ε)⟶0,
就称 Tn 依概率一致。固定一条有正宽度的误差带,随着样本增加,落到带外的概率最终消失。某一条实际估计轨迹仍可能暂时远离目标,一致性没有要求逐次变准。
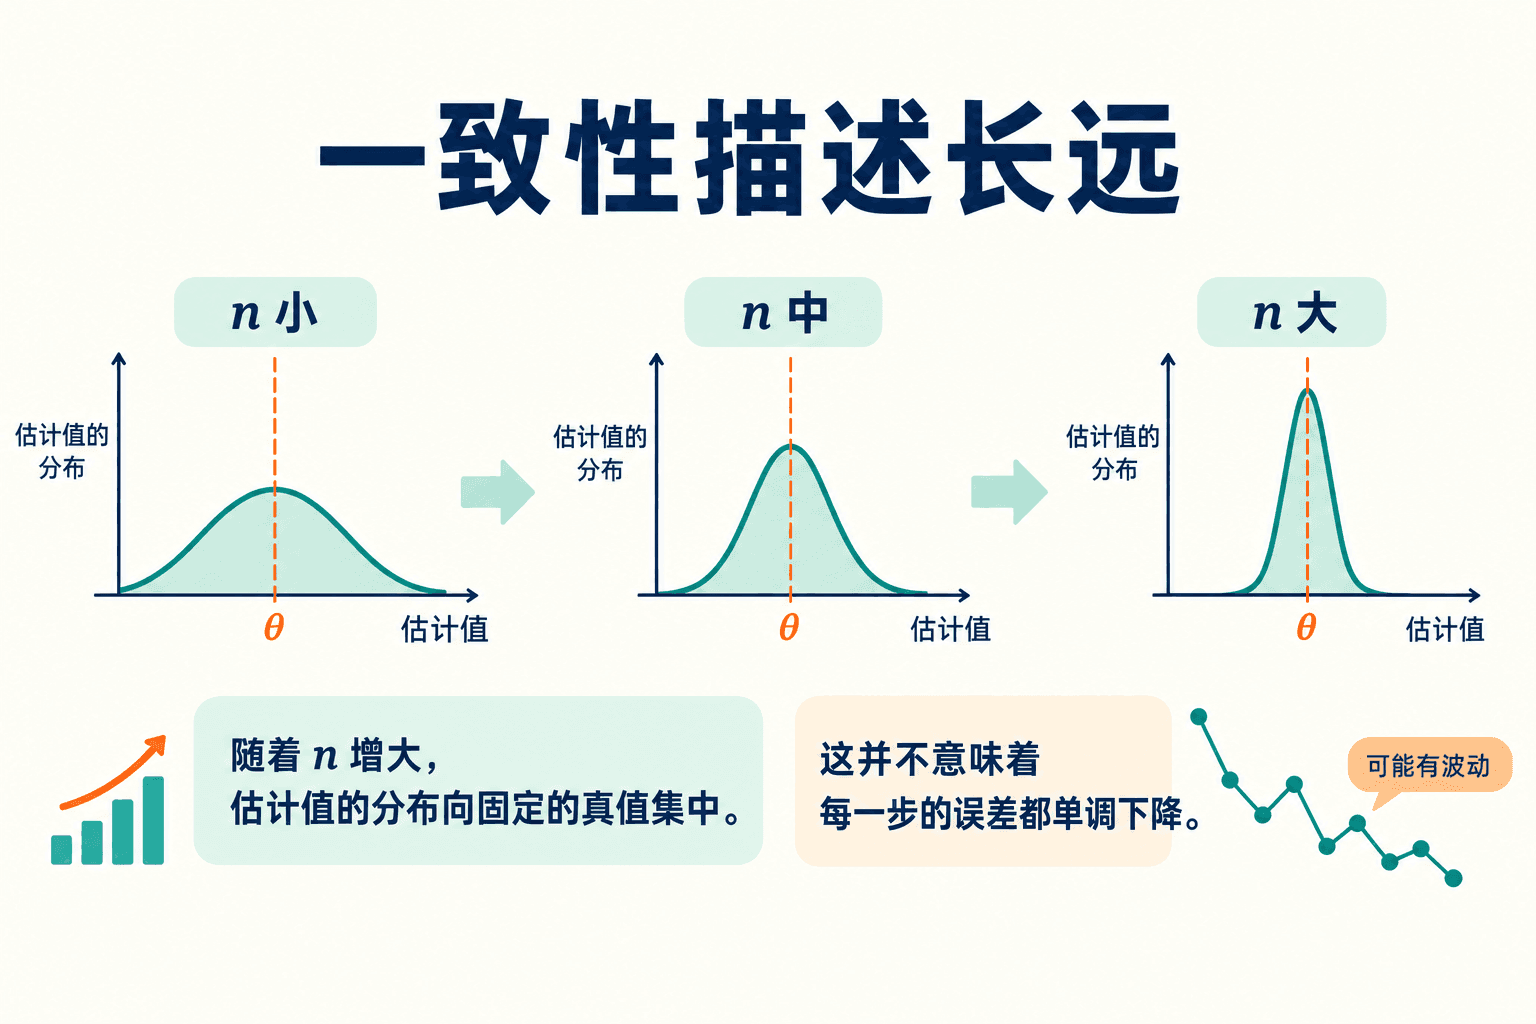 图 3-5:一致性描述长远
MSE 趋于零是足以推出一致性的条件:由 Markov 不等式,
Pθ(∣Tn−θ∣>ε)≤
因此,只要偏差和方差都趋零,就足以得到一致性。反过来却要小心:估计虽然越来越可能接近目标,极少发生的大误差仍可能撑起二阶矩,使 MSE 不趋零。
始终使用 Tn=X1 估计总体均值,可以无偏却通常不一致,因为分布并不随 n 集中。正态模型的 V 则展示了另一种组合:有限样本有偏,偏差与方差都趋零,仍然一致。
固定 a=1 的 aXˉ 则通常收敛到 aμ,不是 μ。可以让收缩随数据增加而退出,但需要真的验证极限。对固定参考点 、预先规定的 ,令
Tn=m0+an(X
偏差是 (1−an)(m0−μ),方差是 a。只要 ,二者的平方风险之和便趋零。举例 、 时,风险为 。它可以有限样本有偏,同时对每个固定参数一致。
刚才的 an 是确定数。若看见数据特别极端才更换 an(X),权重就可能与均值相关。此时应对实际选择规则重新求期望,原来把权重视为常数的风险式不再适用。
写出一个趋于零的概率上界
对 Tn=Xˉ+1/n,设 iid 样本具有均值 μ、有限方差 σ。它每个有限 都偏高 ,所以不是无偏的。但
E[(Tn−μ)2]=nσ
给定你事先选定的误差容许量 ε,超出它的概率不大于
ε2σ2/n+1/n2,
右边确实趋于零,一致性到这里才证明完。只说“样本大了应该稳定”,还没有给出误差概率会消失的理由。
反过来,即使一个估计越来越有可能接近目标,平均平方损失也未必下降。构造一个目标为 0 的序列:Tn 以概率 1/n 等于 n,否则等于 0。对任意固定 ε>0,最终超出误差带的概率是 1/n;但 ,反而增长。这是概率收敛不能独自控制极端损失的原因。
无偏性描述固定样本量下的分布中心,不能回答增加数据是否有帮助。一致性需要误差概率的极限;MSE 还计入了尾部大误差对平均平方损失的贡献。判断一种评价是否有用,要看任务关心哪部分表现。
实验:增加样本后各条规则的误差概率
X̄+1/n 的偏差会随样本增加而消失,X₁ 却始终没有使用后来的观测。根据这一区别,判断两条规则在固定误差带外的概率会怎样变化。
固定 ε 和 σ,将样本量从 1 调至 1024,观察曲线的整体趋势。换一个重复抽样种子,模拟点的位置会变化,可以和理论线对照。
均值和偏差逐渐消失的估计,其超界概率都在下降;X₁ 曲线仍是水平的。模拟圆点会随着重复样本略微晃动,不必期待每一点都落在理论线上。
这里比较的是每个固定 ε 下的一串误差概率,公式直接用正态均值和标准差计算。一次抽得好或不好,都不能代替这一整串概率。
逐点一致还不等于对整个参数范围同时可靠
取 Xi∼Uniform[0,θ]、Tn=2。其风险为 。固定任一有限 ,它一致;但若让参数空间为所有正数,就不能找到一个与 无关的样本量,让绝对误差统一很小。
写 Xi=θUi,其中 Ui,则
Pθ(∣Tn−θ∣>ε)=
对固定 n,2Uˉ−1 有连续分布、恰好为零的概率为零;令 θ→∞,右侧趋近 1。因此该概率对所有 θ>0 的上确界是 1。每个固定参数处随 改善,与在无界参数空间上统一控制绝对误差,是不同命题。若改看相对误差 ,尺度因素消失,就能建立统一界。这也说明评价单位和误差尺度会改变问题。
6. 最优性结论的比较范围
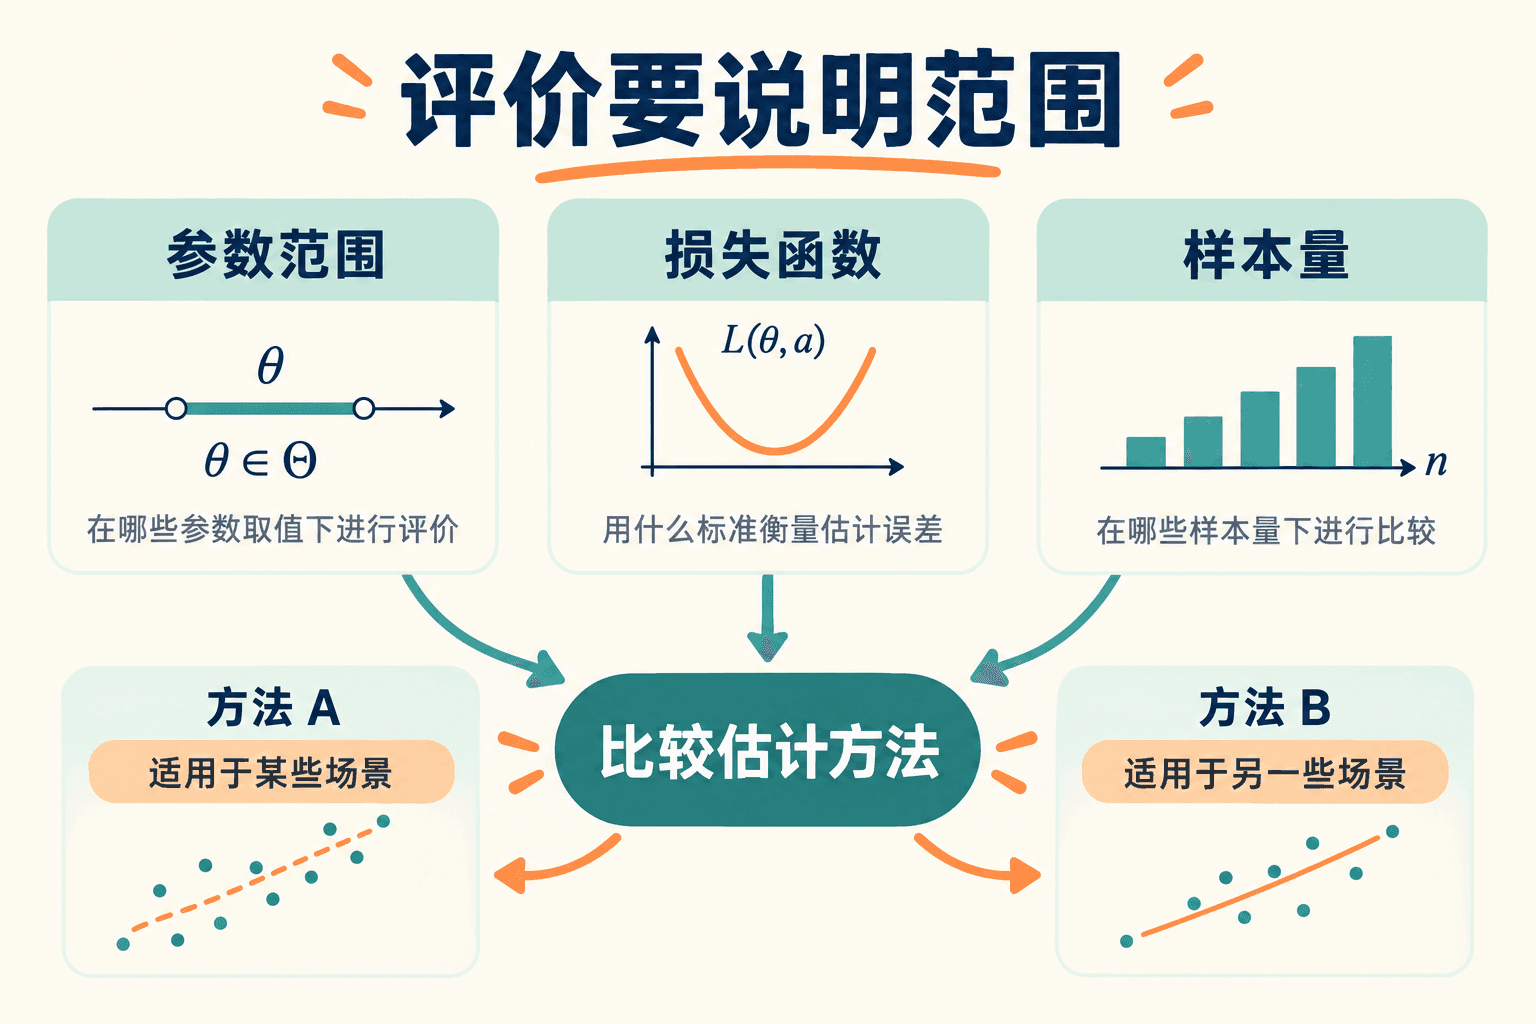 图 3-6:评价要说明范围
在正态模型中比较两个无偏估计,不能据此声称在任意有限方差分布中胜过所有估计。结论的范围还涉及参数空间、样本量与损失函数。下一章构造估计量时,这些评价标准仍会用到。
为评价结论补齐理由
1估计 A 无偏且方差为 4;估计 B 偏差为 −1 且方差为 2。按均方误差应选哪一个?
2一个一致的估计,在同一条实际抽样轨迹上,误差必须随样本量逐次减少。
3一个估计量的偏差为 −2、方差为 3,它的均方误差是多少?
7. 练习:把“更好”的理由算出来
练习 1|损失会改变排序。 某真值下,A 的绝对误差以概率 0.98 为 0、以概率 0.02 为 50;B 恒为 1.5。分别按平均绝对误差、平方风险排序,解释排序为什么不矛盾。
A 的两种风险为 1、50,B 则为 1.5、2.25。按平均绝对误差,A 较好;平方损失对极端误差的代价更大,所以排序反过来。指标需要在评价前确定,不能看完结果挑对自己有利的一个。
练习 2|完整优化一个类。 正态样本量为 6。求 Q/5,Q/6,Q/7 的偏差和 MSE;再从二次式证明第三个在所有常数倍 cQ 中最优。
k=5,风险系数为 35c2−10c+1=35(c−1/7)。三个偏差依次为 ,MSE 依次为 。正的平方项证明全局最小,但候选范围仍限于非随机常数倍 。
练习 3|换总体后重新计算。 两个 iid 观测各以一半概率为 −2 或 2。列出 Q 的分布,计算 Q 与 Q/2 估计总体方差时的 MSE。为什么不能使用正态卡方公式?
总体方差为 4。Q 以各一半概率为 0、8,故风险为 (16+16)/2=16;Q/2 为 0、4,风险为 (16+0)/2=。总体为两点分布, 只有两个取值,不可能是连续卡方变量的倍数。二阶矩相同不意味着平方和的分布相同。
练习 4|向非零基准收缩。 iid 数据均值为 μ、方差为 9,n=9。令 T=10+(Xˉ−10)/2。在哪些 下它的 MSE 小于 ?选择基准 10 是否已经使用了未知真值?
风险为 1/4+(10−μ)2/4,均值风险为 1,所以当 ∣μ−10∣<3 时更小。若 10 是事先基于任务规定的基准,规则可实施;若分析后用未知真值来指定基准,则不是可执行程序。可实施和处处占优仍是两回事。
练习 5|消失的收缩。 取 Tn=3+[n/(n+2)](Xˉ−3)。计算偏差和风险,证明一致,并给出它优于均值的参数条件。
偏差为 2(3−μ)/(n+2),风险为 [nσ2+4(3,由 Markov 得一致。比较 ,化简得 。每个固定参数一致,并不使这一有限样本优势自动扩展到所有均值。
练习 6|概率与期望分道扬镳。 目标为 0,Tn 以概率 n−2 为 n2,否则为零。计算超出固定误差带的概率、期望与 MSE。它一致吗?渐近无偏吗?
对最终满足 n2>ε 的 n,超界概率为 n−2→0,所以一致。但期望恒为 1,偏差不趋零;MSE 为 n。收敛概率不能控制极端尾部对期望的贡献。
练习 7|统一保证的尺度。 在均匀上界模型中,利用 Var(2Xˉ/θ)=1/(3n),给出相对误差超过 10% 的概率至多为 5% 的一个充分样本量。这个保守界是否依赖 θ?
Chebyshev 给概率不超过 1/[3n(0.1)2]=100/(3n)。取 n≥667 即可使界不超过 0.05。界不含 θ,因此是全正参数空间的统一相对误差保证;它只是充分条件,通常远比精确分布算出的样本量保守。
练习 8|审查一句结论。 “我对本批数据挑到一个收缩系数,把它代进常数系数的风险公式;结果更小,因此新方法对所有均值都更优。”指出两个独立的逻辑缺口,并说明各自需要补什么证据。
这里要补两处证明。按样本选出来的系数是随机量,得对完整选择程序求期望,不能继续当成固定常数。即使某个代入参数处的风险更小,也还得证明风险差对每个允许参数都不为正,才能说全参数支配。前一处关系到规则怎样运行,后一处关系到结论能说多大。