概念理解:例子、反例与边界
仅仅会背诵“平均数等于总和除以数量”这样的定义,并不代表真正理解了平均数的概念。学习一个概念,不止要知道计算公式,还要明白在什么情境下可以或不可以使用它。
真正的概念理解,至少要包括:平均数成立时有哪些前提条件;它能帮助我们回答什么类型的问题;在什么情况下容易误用(比如遇到极端值时);以及和类似概念(如中位数、众数)相比,有哪些本质上的区别。只有这样,才能在实际场景里正确、灵活地选择合适的方法处理数据。
本章任务卡
先算,再解释
30秒挑战:同一组数据为什么会有两个正确答案
先不要看下面的解释。看到 10、11、11、12、56 时,快速写下你认为最能代表“典型等待”的数,并补一句理由。如果只写出一个数而没有说明问题目的,答案还不能被核查。
先独立计算这组数据的平均数和中位数:
- 总和为100分钟,平均数为20分钟;
- 排序后的中间值为11分钟,中位数为11分钟。
两个答案都计算正确,但“典型等待时间是多少”并没有自动得到唯一答案。如果目的是估计总等待负担,平均数保留了56分钟这次长等待的影响;如果目的是描述多数人的常见体验,中位数更接近其余四次记录。
把定义拆成判断条件
建立概念卡时,不只抄定义:
text
概念名称:
它回答的问题:
计算或判断条件:
一个清楚正例:
一个容易混淆的反例:
一个边界情形:
与相近概念的区别:
选择它时需要说明的目的:
对平均数而言,极端值会进入总和并影响结果;对中位数而言,排序和位置是关键。不能把“中位数不受极端值影响”夸张成“中位数永远更好”。指标选择取决于问题,而不是偏爱某个算法。
正例、反例和边界各自检查什么
- 正例检查你能否识别典型成立情形。
- 反例专门改变一个关键条件,暴露“只看表面”的误解。
- 边界例保留大部分条件,却让结论需要更谨慎的说明。
例如,数据10、11、11、12、13中,平均数和中位数都接近常见体验,是清楚正例。若把13改成130,仍直接说“平均数最能代表典型等待”,就是一个反例。若只有两次记录,虽然仍能计算指标,却要提醒样本很少,这是边界问题。

概念理解可以分成四层
复述定义:能够说出规则和术语,但还未证明会使用。
区分相邻概念:知道平均数与中位数不是同一个问题的两种写法。
说明成立边界:能指出异常值、样本大小和问题目的如何影响选择。
迁移到新情境:换成收入、交付时长或响应时间后,仍能根据结构选择指标。
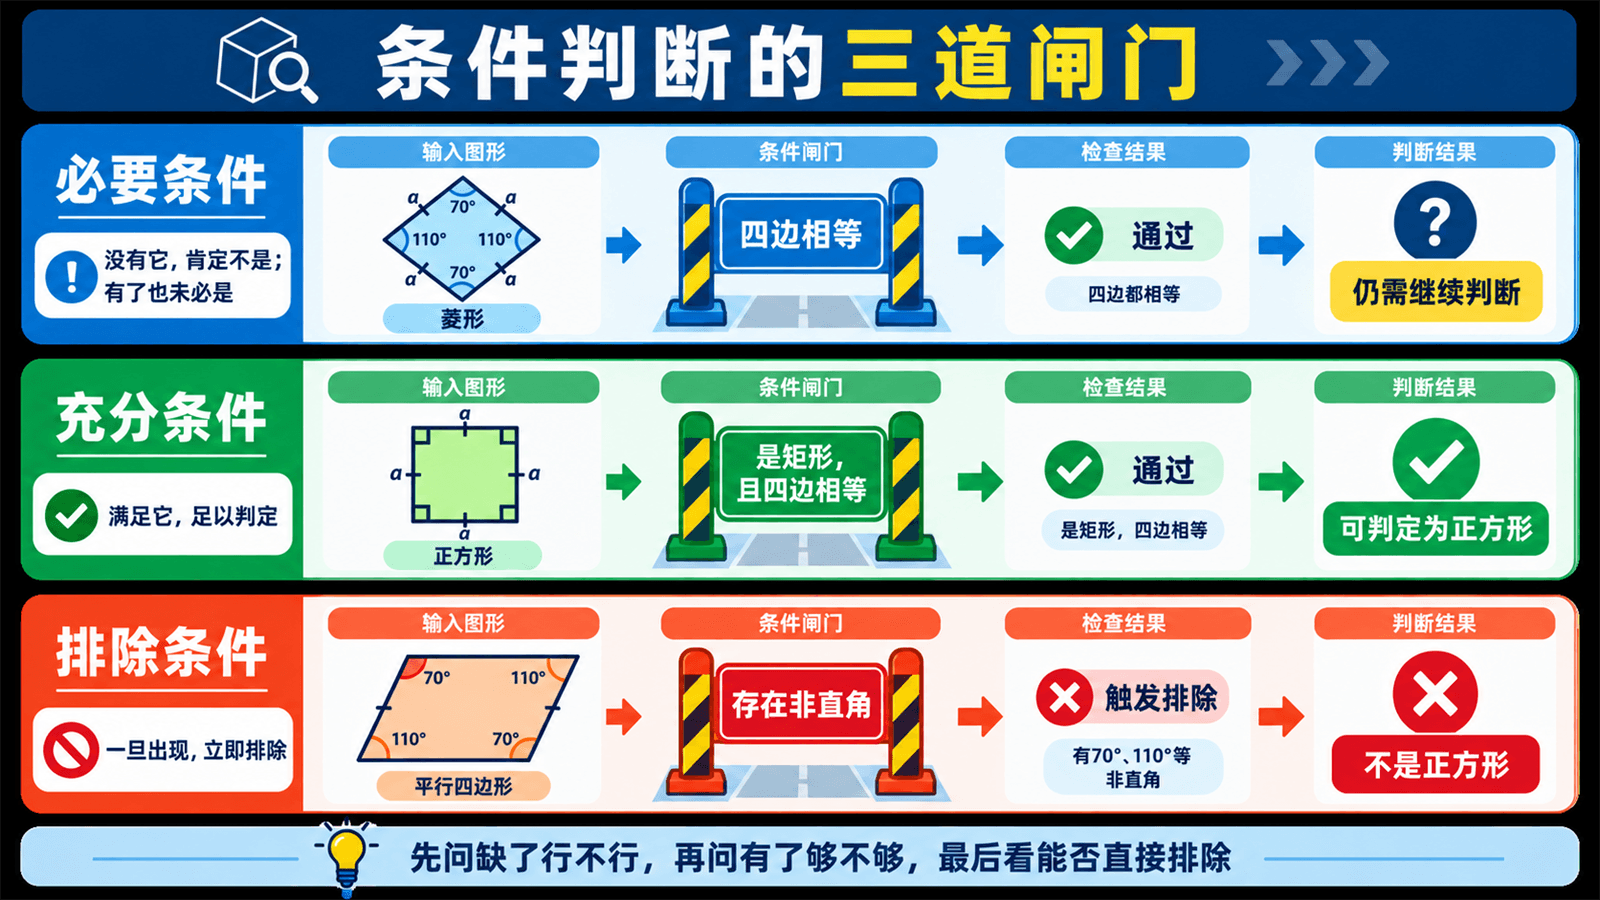
检查条件时还要区分三种角色:必要条件缺失时结论不能成立;充分条件一旦满足即可支持结论;排除条件出现时,原规则需要停止或改写。多数课堂概念并不只有一个漂亮的充分条件,因此不要让 AI 为了整齐而虚构“万能判断口诀”。
构造反例的实用方法是只改变一个条件:保持计算方法不变,只加入极端值;保持数据不变,只更换问题目的;保持目的不变,只减少样本。这样才能知道是哪一个条件让原判断失效。
换一个场景,边界还在吗
场景改变后,计算规则可能没有变,但“哪个指标更有解释力”仍取决于问题目的。能在新场景中重新说明条件,才不是背诵案例答案。
中途检查:自己制造一个反例
从五个相近的数开始,只改变其中一个数,使平均数明显变化而中位数保持不变。随后再保持数据不变,只改变提问目的,观察原来的指标选择是否需要更新。
让 AI 生成候选例子,再逐一审查
text
我要检查自己是否理解平均数和中位数的选择边界。
请生成三个短数据集:一个清楚正例、一个容易误判的反例、一个需要谨慎解释的边界例。
先只给数据和任务,不给分类与答案。
我作答后,再按“问题目的、数据分布、异常值、样本限制”解释。
所有计算请列出可重算过程。
AI 可能生成重复、算错或边界不清的例子。学习者要重算并判断它是否真的改变了关键条件。
交互练习:判断概念边界
进入交互前:写下三条判定线索
至少包含问题目的、异常值和样本限制,不要只写“平均数大就选中位数”。带着规则进入交互,才能判断反馈是否真正修正了你的概念边界。
先对每组数据选择“更适合平均数”“更适合中位数”或“信息不足”,再写理由。交互给出的反馈用于比较判断条件,不代替重算。静态替代任务:自行构造一组让平均数与中位数差异明显的数据,并说明它暴露哪种误解。
完成后复盘:找出一次“算对但解释错”
保存一组计算正确但指标选择理由不充分的数据,补写遗漏的目的或条件。概念学习的关键证据不是只会算,而是知道什么时候应该谨慎使用。
一次常见失败:生活类比代替正式条件
把中位数说成“排队时站在最中间的人”有助于入门,但当记录数量为偶数时,这个类比不完整。类比只能解释某一部分;最后仍要回到排序、位置和偶数个数据时取中间两项平均值的规则。
修正方法是为每个类比加一句:“它帮助说明什么,又没有说明什么。”
换条件独立任务
比较两组数据:
- A:8、9、9、10、11
- B:8、9、9、10、44
分别计算平均数和中位数,并为“描述大多数人的常见等待”选择指标。然后把问题改为“估算五次等待的总时间负担”,判断选择是否需要变化。
挑战加码:再构造两组平均数相同、分布明显不同的数据,说明为什么只知道平均数还不足以了解数据形态。
实操与验收
完成以下内容:
- 一张包含定义条件、正例、反例和边界例的概念卡;
- 一次面对新数据的指标选择与重算过程;
- 一段说明为什么另一个指标在当前目的下较弱;
- 一处生活类比的适用范围说明。
将结果写入专题学习档案的“概念边界”部分。下一章将把“知道定义”推进到“理解过程中的方法选择”。