数据库和缓存注定会短暂不一致
上一章把 Cache Aside 的基本路径搭了起来:读资料时先查 Redis,没命中再查数据库并回填;改资料时先写数据库,再让缓存失效。把这几行代码放进开发环境,几乎看不出问题。真正麻烦的是它上线以后:请求会并发,数据库提交和 Redis 命令之间隔着网络,任何进程都可能恰好在两步之间退出。
这一章不再把“缓存一致性”当成一道背顺序的题。我们就盯住一个接口:PUT /users/:id/profile;一张表:users;一个缓存 key:cache:user:profile:<id>。数据库里的 users 记录是权威数据,Redis 里的 JSON 是随时可以重建的副本。只要副本存在,系统就有两个可见位置;只要一次修改不能原子地同时改变这两个位置,短暂不一致就不是偶发缺陷,而是系统结构带来的常态。
先把目标说清楚:我们通常不是证明两个位置在每一微秒都相同,而是控制四件事——旧值最多能被谁看到、最多持续多久、失败后能不能自动收敛、代价是否符合这项业务。昵称晚几秒和收款状态晚几秒,显然不该用同一套答案。
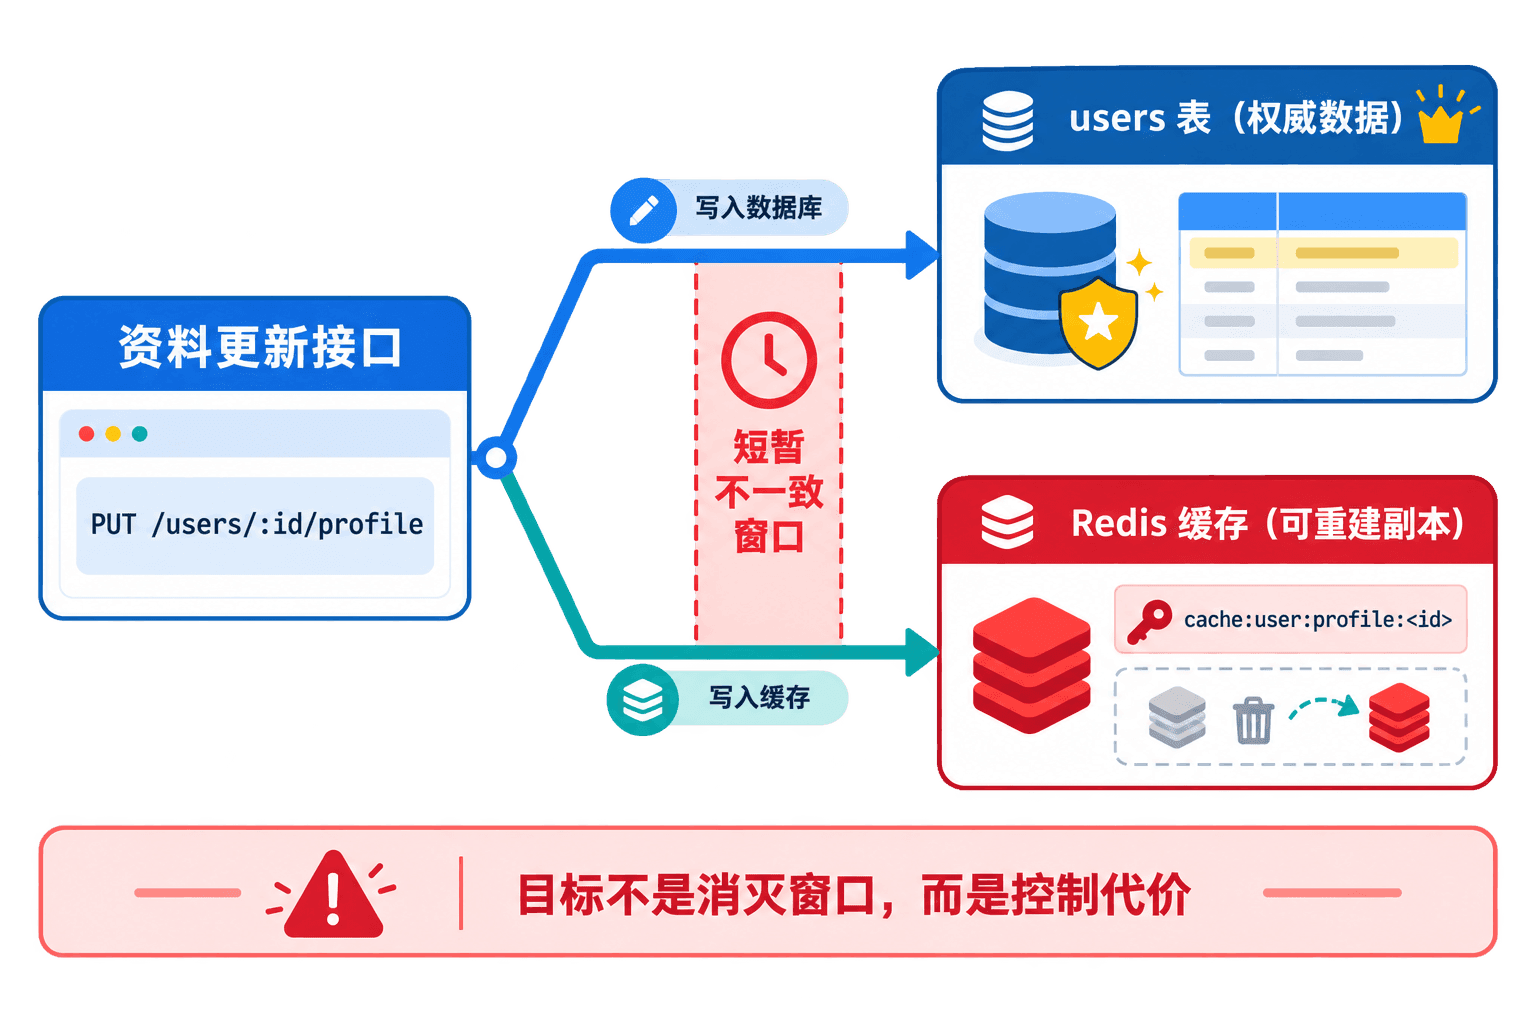
缓存命中旧值时,读请求通常只是把旧值返回给调用方,不会“顺手回填”。会把旧数据重新写进 Redis 的,是缓存未命中后已经从数据库拿到旧快照、但直到较晚时刻才完成 SET 的慢读请求。把这两种情况混在一起,会直接把竞态分析带偏。
先定义一份可讨论的资料缓存
假设 users 表至少有下面几列。version 每成功修改一次就加一,它既方便做乐观并发控制,也让我们能在日志和缓存中判断谁新谁旧。
sql
CREATE TABLE users (
  id          varchar(32) PRIMARY KEY,
  name        varchar(80) NOT NULL,
  city        varchar(80) NOT NULL,
  version     bigint NOT NULL DEFAULT 1,
  updated_at  timestamptz NOT NULL DEFAULT now()
);
读接口遵循 Cache Aside。命中就直接返回;未命中才查 users,然后带 TTL 回填。这里把正向缓存设为 120~150 秒,抖动来自用户 ID 的稳定哈希。这样同一条资料的过期时间可预测,不同用户又不会在同一秒成批过期。
js
import Redis from "ioredis";

const redis = new Redis({
  host: "127.0.0.1",
  port: 6379,
  maxRetriesPerRequest: 1,
  enableOfflineQueue: false,
});

function profileKey(userId) {
  return
这段代码里有两个容易被忽略的事实。第一,GET 返回非空时没有 SET,所以“命中旧缓存又把旧缓存续上”不是这里的故障路径。第二,未命中的请求从数据库取得一行后,到执行 SET 之前仍有一段时间;它手里的对象不会因为别人提交了新版本就自动变化。真正棘手的竞态藏在这里。
写接口也先给出最小版本。更新数据库成功后删除缓存,响应直接返回数据库 RETURNING 得到的新行,不要为了“确认一下”又走缓存读路径。
js
app.put("/users/:id/profile", async (req, res, next) => {
  try {
    const { id } = req.params;
    const { name, city, expectedVersion } = req.body;
这已经是很实用的起点,却还不是“数据库和缓存组成了一个事务”。SQL 提交与 DEL 是两个系统中的两次操作。Redis 的 MULTI/EXEC 只能让一组 Redis 命令连续执行,不能把 PostgreSQL 或 MySQL 的 UPDATE 一起卷进去;数据库事务也不能在 Redis 删除失败后自动把已经提交的行回滚。给 Redis 命令外面套一层 multi(),并没有跨过这条边界。
为什么默认删除,而不是把新对象写进缓存
直接更新缓存看起来少一次回源,问题却出在并发写的完成顺序。假设 A 把名字改成“林一”,B 紧接着改成“林二”。数据库最终按提交顺序保存 B 的 v3;可 A 的网络请求可能更慢,直到 B 已把 v3 写入 Redis 后,A 才把 v2 写进去。于是数据库是 v3,缓存反而被较早的修改覆盖成 v2。写请求的发起顺序、数据库提交顺序与 Redis 到达顺序是三件不同的事,不能靠代码排列推断它们永远相同。
删除对这种乱序更耐受:A 删一次、B 再删一次,或者 B 先删、A 后删,终态都是 key 不存在。下一次读请求再以当时数据库中的已提交版本重建副本。它牺牲了一次未命中,换来了更简单的收敛方向。若资料构建成本很高,确实想主动写新缓存,也必须把版本比较和可靠事件一起设计进去,不能只是把 DEL 换成 SET。
还要把“一个数据库行影响哪些缓存”写成明确契约。修改 users.id = u1001 可能同时影响详情 key、用户名搜索结果、团队成员列表和页面片段。只删 cache:user:profile:u1001,并不能让其他派生缓存自动失效。适合按实体精确失效的 key 可以直接计算;集合查询和聚合结果则要么接受较短 TTL,要么维护标签、版本化命名空间或明确的事件订阅关系。缓存一致性经常不是某个 DEL 写错,而是团队根本没有列完整失效范围。
事故一:先删缓存,慢读把 v1 写回来了
现在复盘最容易制造长期脏值的顺序。u1001 当前在数据库和 Redis 中都是 version=1。写请求 A 要把名字改成新值,读请求 B 恰好同时查询详情。
A 先执行 DEL cache:user:profile:u1001。缓存已经空了,但 users 表尚未提交,数据库里仍是 v1。
B 在这时执行 GET,得到未命中,于是查询 users。数据库给 B 一份 v1 快照。B 已经把 v1 放进进程内存,但还没来得及回填。
A 提交数据库,users.id = u1001 变成 v2。因为 A 的删除动作已经做过,它不会再碰这个缓存 key。
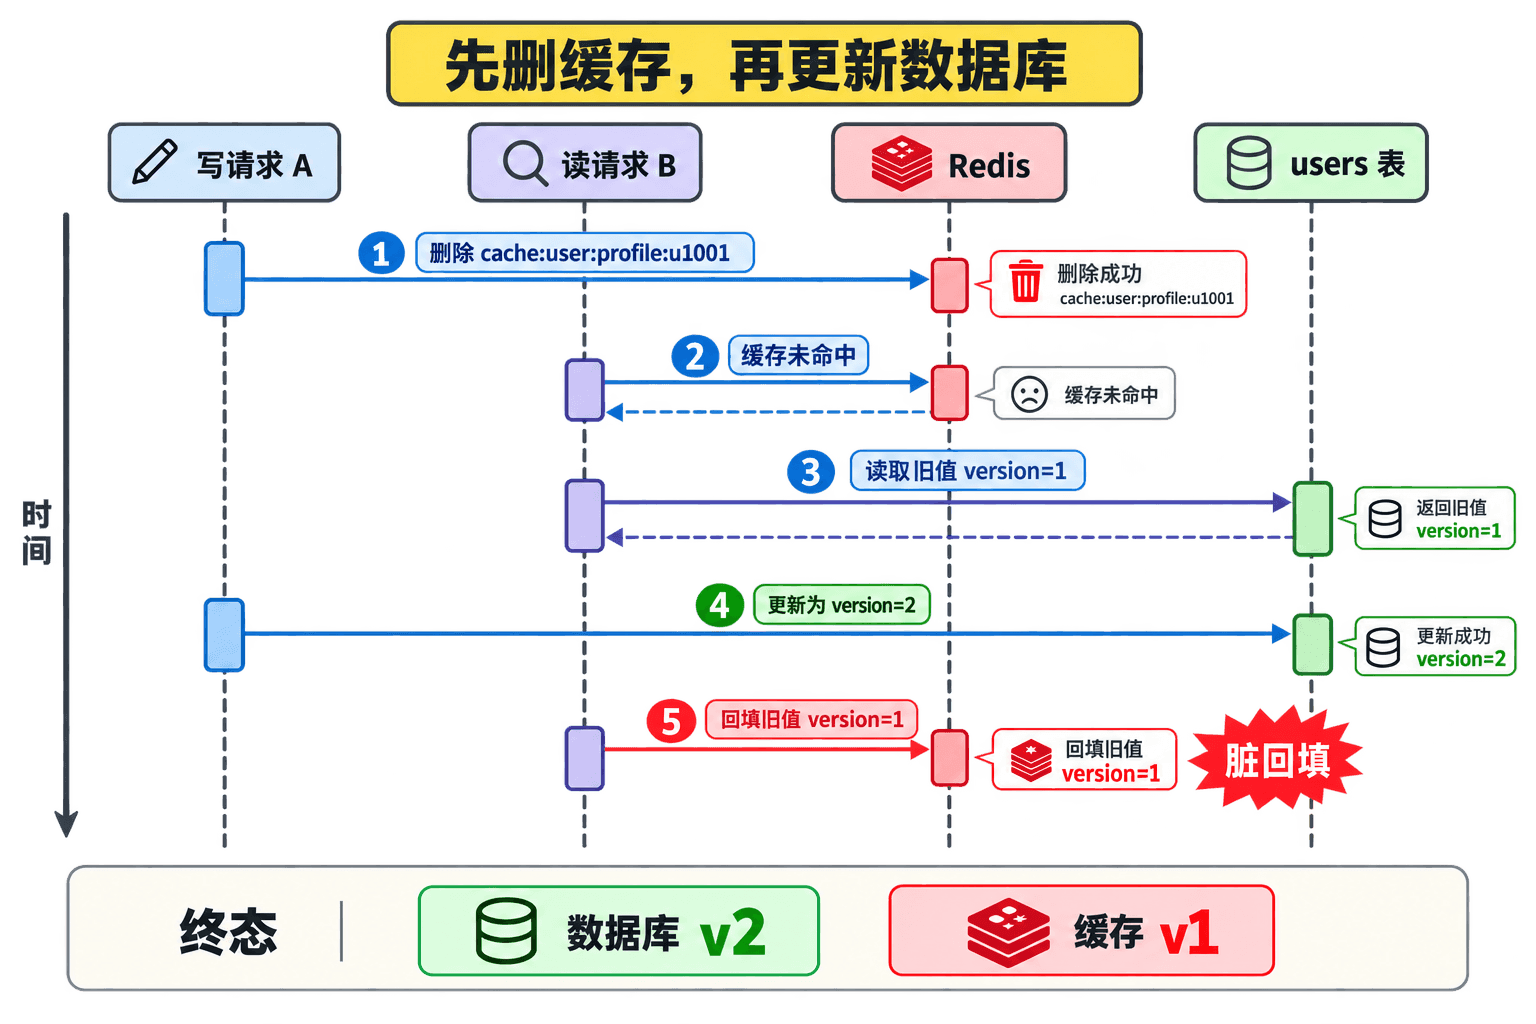
注意 B 不需要在 A 提交以后再次查询数据库。它只要在提交前取得旧快照、在提交后才完成回填,就足以制造脏缓存。生产环境中的数据库连接池排队、网络抖动、进程暂停和下游序列化,都可能把这段原本很短的间隔拉长。
下面的时序重放器可以逐步切换两种操作顺序。请先观察“缓存命中旧值”的请求只返回什么,再观察“未命中并持有旧快照”的请求最终写了什么。
“先删缓存,再更新数据库”还有一个更直白的问题:如果数据库更新失败,缓存已经被无谓地删掉;热点资料会突然回源,系统多承担一次重建压力。删除本身不是灾难,但它没有换来任何新数据,反而放大了写失败的影响。
事故二:先更新数据库,再删缓存也有窗口
把顺序改成“先更新数据库,再删除缓存”后,最常见的竞态温和很多:A 先把数据库提交为 v2,在 A 的 DEL 到达 Redis 之前,B 命中原有 v1。B 把 v1 返回给用户,但不回填、不续期。紧接着 A 删除成功,下一次读取未命中,便从数据库取回 v2。旧值只在数据库提交与删除成功之间短暂可见。
text
A:提交 users v2 ─────────────── DEL 成功
                          ▲
B:                    GET 命中 v1 → 返回 v1

下一次读取:GET 未命中 → SELECT users 得到 v2 → SET v2
这就是它通常比“先删再更”更合适的原因:危险动作被放在权威数据提交之后,而且删除成功会主动结束旧缓存的生命周期。它降低了形成长期脏缓存的概率,但不能把概率降为零。
还有一条更窄、却真实存在的路径:读请求 C 在写入提交前就缓存未命中,并从数据库取得 v1;随后 A 提交 v2 并成功删除缓存;最后 C 才把手里的 v1 回填。即使 A 采用“先更新再删除”,C 依然可能在删除之后写入旧值。要触发它,C 的整段回源必须跨过 A 的提交和删除,所以它比“先删再更”的典型竞态苛刻,但慢查询、从库延迟或线程长时间停顿都可能满足条件。
因此,工程结论不该写成“先更新数据库再删缓存就一致了”,而应写成:它是 Cache Aside 的默认基线,残余风险再由可靠失效、版本栅栏、按业务选择的读路径和 TTL 共同控制。
本章的小型程序把关键顺序固定下来,避免靠运气撞竞态。它得到的输出如下:
text
[先删缓存,再更新数据库]
1. A 删除缓存
2. B 查询缓存:未命中
3. B 取得数据库快照 v1
4. A 提交数据库 v2
5. B 回填自己手里的 v1
终态:数据库 v2,缓存 v1

[先更新数据库,再删缓存]
1. A 提交数据库 v2
2. B 命中缓存 v1,只返回、不回填
3. A 删除缓存成功
4. 下一次读取:未命中
5. 下一次读取从数据库回填 v2
终态:数据库 v2,缓存 v2
这两段输出只证明被安排出来的两条时序,不证明线上每次都会按这个顺序发生。并发测试的价值是把一个“偶尔出现”的事故变成稳定可复现的因果链,然后再针对这条链设计保护。
删除失败才是更常见的午夜告警
很多团队最终遇到的不是精巧的纳秒级竞态,而是朴素的第二步失败:UPDATE users 已经提交,应用对 Redis 发出 DEL 时连接被重置、命令超时,或者 Redis 正在故障切换。数据库是 v2,缓存仍是 v1。此后每个 GET 都稳定命中旧值,数据库完全没有机会参与读取。
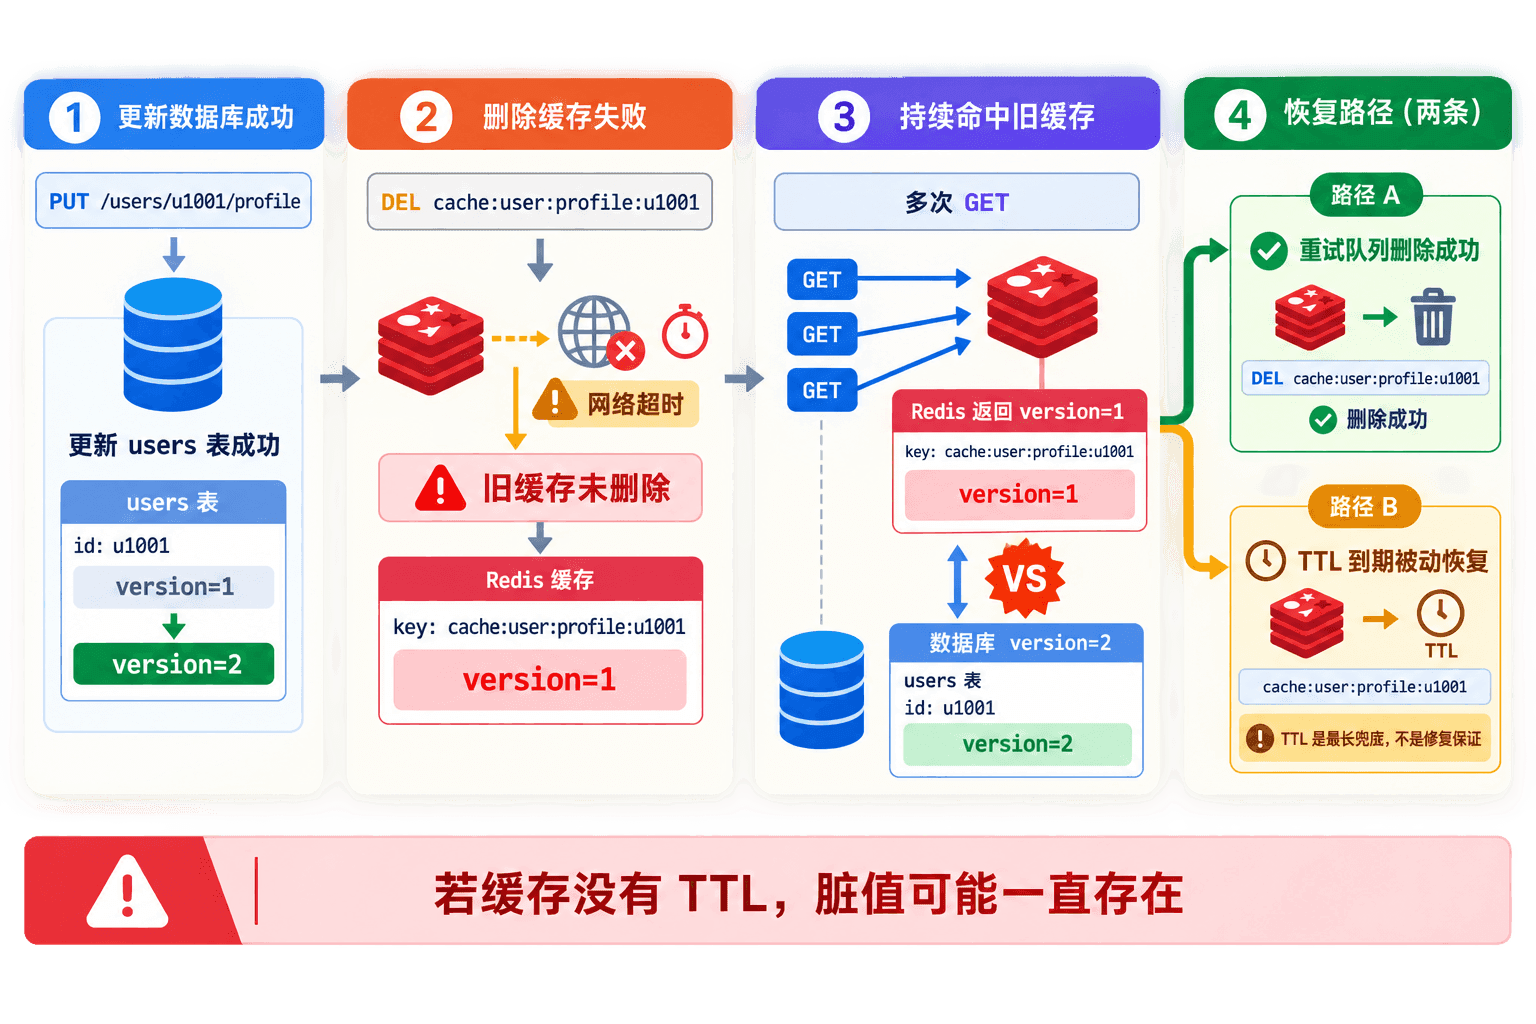
复现实验把 DEL 注入为 ECONNRESET,再执行一次可靠重试,输出很直接:
text
[删除失败与重试]
DEL 错误:ECONNRESET
重试前:数据库 v2,缓存 v1
缓存仍有 TTL:true
重试删除后未命中:true第一层保护可以是短暂的应用内重试。DEL 天然幂等:同一个 key 删除一次返回 1,再删一次返回 0,目标状态都是“不存在”。当客户端不知道超时前服务端究竟有没有执行命令时,重发 DEL 通常安全。重试要有退避和随机抖动,还要有限次,避免 Redis 故障时所有应用实例整齐地持续轰击它。
js
import { setTimeout as delay } from "node:timers/promises";

async function deleteProfileCacheWithRetry(userId) {
  const waits = [30, 100, 300];
  let lastError;

  for (let attempt = 0; attempt < waits.
但内存里的循环有一个洞:数据库刚提交,进程还没把任务放进任何地方就崩了,重试逻辑随进程一起消失。单纯“记一条错误日志”也不等于恢复,除非有人真的消费日志并完成删除。更可靠的办法必须把“这次提交之后需要让哪个缓存失效”变成可持久化、可重放的事实。
这里还涉及接口语义。若数据库已经提交 v2,只因为 DEL 超时就向客户端返回“修改失败”,客户端可能再次提交同一次修改,甚至把 version 冲突误当成另一场故障。比较稳妥的做法是区分“业务写入结果”和“缓存失效结果”:业务事实已提交就返回已提交的新版本,同时把失效失败可靠入队并报警;如果产品要求成功响应前必须完成缓存失效,就要明说这个接口会被 Redis 可用性拖住,并设计幂等请求 ID,让客户端重试时不会重复产生业务修改。无论返回什么,都不能假装数据库会因为缓存错误自动回滚。
TTL 是最后一道时间上限,不是第一责任人。假如每个资料缓存都保证有 120~150 秒 TTL,那么删除永久失败时,旧值通常不会无限存在;但用户可能在这两分钟内一直看到旧名字。若某些代码路径忘了设置 TTL,这个上限就不存在。若 Redis 淘汰、主从切换或客户端重连影响了实际行为,TTL 也不会替你解释业务结果。我们应该监控失效任务,而不是等过期时间替系统“擦屁股”。
延迟双删能清理窗口,但它不是正确性证明
延迟双删常见的形式是:先删缓存,更新数据库,等一小段时间,再删一次。第一次删除打开了“旧快照回填”的窗口,第二次删除试图在所有慢读都结束以后,把窗口中写回的旧值清掉。
js
async function updateProfileWithDelayedDoubleDelete(userId, patch) {
  const key = profileKey(userId);

  await redis.del(key);
  const updated = await updateUserRow(userId, patch);

  setTimeout(() => {
    redis
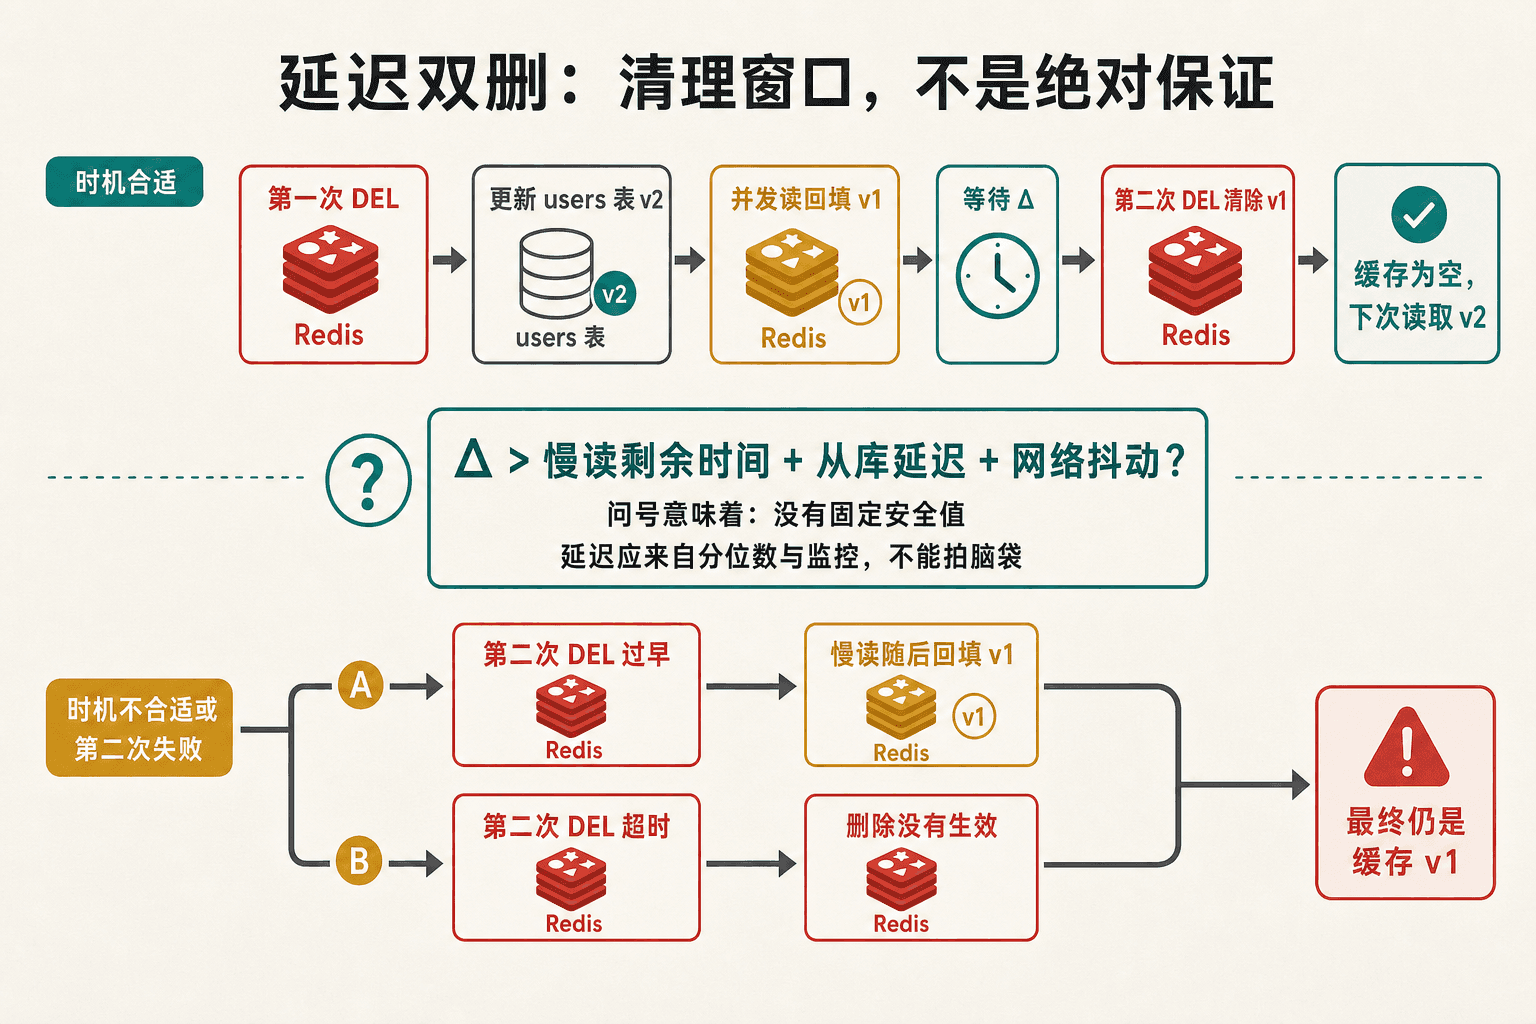
问题全在那个 500。它至少要覆盖慢读剩余时间;如果读请求走从库,还要考虑复制延迟;再加上连接池排队、进程暂停和网络抖动。把延迟拍成固定数字,只是在当前流量和当前延迟分布下碰运气。设得太短,第二次删除先发生,慢读随后仍可回填 v1;设得太长,脏值暴露更久;第二次 DEL 自己也可能失败。
还有一种实用变体是“先更新数据库、立即删除、过一段时间再删一次”。立即删除处理普通窗口,延迟删除清理跨越提交过程的慢回填。它少了更新前那次主动制造的缓存空洞,但依然需要为第二次删除提供可靠任务,而不是在请求进程里放一个无人负责的定时器。
下面的实验台可以调节数据库提交时刻、慢读回填时刻和第二次删除时刻。请把第二次删除拖到慢读之前,再放到慢读之后,终态会从 v1 变为空缓存。这个变化正好说明:延迟双删是在猜测尾部耗时,不是在建立跨系统原子性。
如果决定使用延迟双删,延迟值应来自回源请求的高分位耗时、数据库副本延迟和网络抖动监控,并定期校准。第二次删除必须进入可恢复的延迟队列或任务表。它适合降低残余竞态概率,不适合承担“绝不能读旧”的业务承诺。
把失效动作做成能恢复的工作
可靠失效大致有三档。它们的共同终点都是删除 cache:user:profile:u1001,差别在于“数据库已提交但删除尚未完成”这件事记录在哪里。
应用内重试:最小成本,但怕进程消失
请求线程先更新数据库,再尝试删除;失败后把任务放入一个真正持久化的队列,并设置指数退避、最大尝试次数、死信和告警。若所谓“队列”只是 Node.js 进程里的数组,它只能覆盖短暂网络错误,覆盖不了进程崩溃和发布重启。
ioredis 的自动重连、命令重试和离线队列是连接层能力,不是业务完成证明。开启离线队列可能让请求在连接恢复后才执行;关闭它可以让接口更快感知缓存故障。无论选哪种,都要明确接口超时以后,DEL 可能处于“没执行”或“执行了但响应丢失”的不确定状态。好在 DEL 幂等,可以安全重做;非幂等缓存写就不能直接套用这个结论。
事务 Outbox:让业务修改和失效意图一起提交
在同一个数据库事务里,同时更新 users 和插入一条 outbox 记录。数据库回滚时两者都没有;数据库提交时两者都存在。独立 relay 持续领取未完成事件,删除缓存,成功后标记完成。
sql
BEGIN;

UPDATE users
   SET name = '小林(新)',
       version = version + 1,
       updated_at = now()
 WHERE id = 'u1001';

INSERT INTO cache_invalidation_outbox
  (event_id, cache_key, aggregate_version, created_at)
VALUES
  ('evt-8f31', 'cache:user:profile:u1001', 2, now());
relay 可能在 DEL 成功后、标记事件完成前崩溃,于是重启后再次删除同一个 key。这是典型的至少一次投递,重复删除没有业务副作用。需要监控的是待处理数量、最老事件年龄、重试次数和死信数量。事件积压一分钟,就意味着某些缓存可能比预期多旧一分钟。
CDC:从数据库提交日志中发现变化
如果系统已经有变更数据捕获设施,可以让连接器读取 MySQL binlog 或 PostgreSQL 逻辑变更流,把 users 的 INSERT/UPDATE/DELETE 转为事件。消费者根据 id 计算缓存 key 并执行 DEL。业务接口不再亲自维护每个缓存映射,别的写入入口、批处理和后台修复只要真正提交了数据库变更,也能触发失效。
CDC 仍然是异步链路。连接器可能积压,消息可能重复,消费者可能停机,源数据库日志还需要足够长的保留期。消费端必须幂等并记录偏移;监控必须看到从数据库提交到缓存删除完成的端到端延迟。不要把“订阅了 binlog”翻译成“缓存实时同步”。
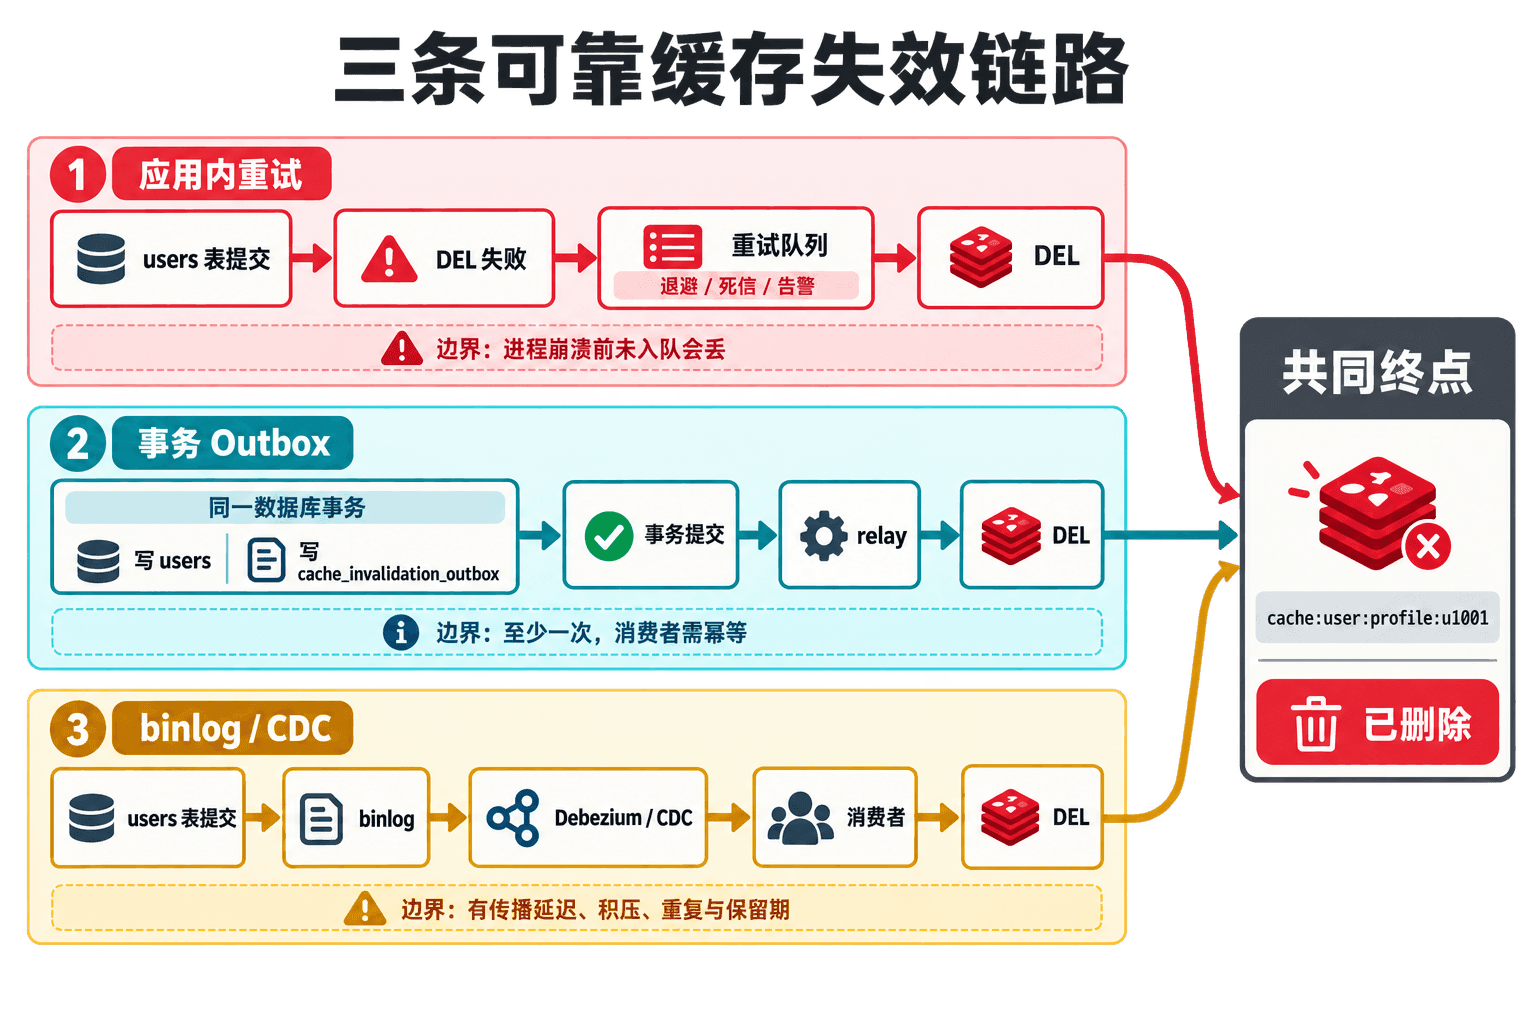
Outbox 与 CDC 也可以组合:业务事务只写 users 和 outbox,CDC 专门捕获 outbox 表,再把明确的失效事件交给消费者。这样事件语义由业务定义,不必让消费者猜“users 哪些字段变化会影响哪几个缓存”;同时,写业务事实和写事件仍在同一个数据库事务里。
如果消费者选择“更新缓存”而不是“删除缓存”,问题会立刻复杂一层:重复事件还好,乱序事件却可能让 v3 被迟到的 v2 覆盖。删除是更稳妥的默认动作;确实要更新时,事件必须带 version,消费端只允许更高版本覆盖更低版本。
版本号和栅栏专门拦截迟到的旧回填
TTL 限制脏值寿命,可靠失效保证删除最终会发生;版本栅栏处理的是另一件事:一个慢读拿着 v1,在 v2 已经可见以后还想执行 SET。
最简单的版本比较是读取当前缓存,拒绝用更小版本覆盖它。下面的 Lua 在 Redis 内一次完成比较和写入,避免两个客户端在“先 GET、再 SET”之间互相穿插。
js
redis.defineCommand("setProfileIfNotOlder", {
  numberOfKeys: 1,
  lua: `
    local current = redis.call("GET", KEYS[1])
    local incoming = cjson.decode(ARGV[1])

    if current then
      local existing = cjson.decode(current)
      if tonumber(existing.version) > tonumber(incoming.version) then
        return 0
      end
    end

    redis.call("SET", KEYS[1], ARGV[1], "EX", ARGV[2])
    return 1
  `,
});
实验先在缓存中放入 v2,再尝试写入 v1,结果是:
text
[版本闸门]
旧版本写入是否被接受:false
缓存最终版本:v2
但先别急着把这段 Lua 当成完整答案。如果 v2 提交后缓存被删除,key 当前为空,单看缓存内容就无法知道 v1 已经过期,脚本仍会接受它。因此,真正的“栅栏”通常需要一个独立的最新版本 key,例如 fence:user:profile:u1001 = 2。写入或失效事件到达 Redis 时,用一段 Lua 把 fence 单调推进到 v2 并删除资料缓存;迟到的 v1 事件不能把 fence 降回去。回填脚本只有在 incoming.version >= fence 时才允许写入。
lua
-- KEYS[1] = cache:user:profile:u1001
-- KEYS[2] = fence:user:profile:u1001
-- ARGV[1] = profile JSON, ARGV[2] = version, ARGV[3] = ttl seconds
local fence = tonumber(redis.call("GET", KEYS[2]) or "0")
local incoming = tonumber(ARGV[2])

if incoming < fence then
  return 0
end

redis.call
栅栏也没有凭空消除双写。数据库已经提交 v2、但 fence 事件还没到 Redis 的那段时间,v1 仍可能回填;所以 fence 的推进要靠 Outbox 或 CDC 这类可恢复链路。fence 的生命周期还要长于任何可能迟到的读请求和资料缓存,不能先于脏回填线索消失。它的价值是把“事件已经到达 Redis 以后,旧请求还能不能反扑”这个问题解决掉。
版本号还帮助处理并发写。PUT 携带 expectedVersion,SQL 只在当前版本相同时更新;受影响行数为 0 就返回 409。这样两个编辑者同时拿着 v1 修改资料时,只有一个能提交 v2,另一个必须重新读取后再决定怎么合并。它解决的是 users 表内的丢失更新,和缓存失效是两层问题,不能互相替代。
“刚改完就刷新”需要单独保证
最终一致并不等于用户应该接受所有旧读。最刺眼的投诉往往是:PUT /users/u1001/profile 明明返回成功,紧接着详情页刷新却又显示旧名字。即使旧值只存在 200 毫秒,对当前用户来说也像修改失败。
第一条规则很简单:写接口响应直接返回数据库提交后的新行。不要提交 v2 后立刻调用普通 GET /users/u1001/profile,再让这个 GET 有机会命中 v1。前端可以用 PUT 响应更新本地页面。
如果后续页面必须重新请求,可以建立“读己之写”栅栏:PUT 返回 version=2;客户端在短时间内给 GET 带上 X-Min-Profile-Version: 2;服务端读到缓存后,如果缓存版本小于 2,就绕过缓存读主库,并只回填不低于 2 的数据。这个最小版本可以放在登录 Session、短期令牌或请求头中,期限取决于失效链路的高分位延迟。
js
async function getProfileWithMinimumVersion(userId, minimumVersion = 0) {
  const key = profileKey(userId);
  const cachedText = await redis.get(key);

  if (cachedText !== null) {
    const cached = JSON.parse
若正常读取会走数据库只读副本,读己之写窗口内应读主库,或者等到副本确认追上指定版本再读。否则服务端虽然绕过了 Redis,却可能从仍落后的只读副本拿到 v1。缓存一致性排查不能只盯 Redis,数据库读写分离本身也会产生可见性延迟。
对权限、封禁、支付状态、余额和库存扣减这类字段,更稳妥的做法常常是让关键决策直接查询权威存储,Redis 只缓存展示数据或只做性能提示。不要为了统一缓存封装,把“昵称可以短暂旧”和“账号已封禁必须立即生效”塞进同一个 TTL。
选择方案前先写下允许的代价
缓存一致性没有一张适合所有接口的固定配方。可以按业务承诺逐层加东西,而不是一开始就堆满组件。
下面的策略实验台把容忍窗口、写流量、现有基础设施和运维成本放在一起。它给出的不是“标准答案”,而是提醒你:每加一层机制,都应该对应一条明确的事故路径。
上线后至少记录这些信号:资料更新提交版本、缓存删除结果与耗时、重试次数、Outbox 最老未处理事件年龄、CDC 端到端延迟、回填时的数据库版本、版本栅栏拒绝次数。可以低比例抽样对比缓存版本和数据库版本,但不要为了监控把所有缓存命中都再查一遍数据库,那会直接抵消缓存价值。
告警也应围绕业务窗口。例如资料允许旧 30 秒,那么“Outbox 有一条任务”并不一定要半夜叫人;“最老任务超过 30 秒且持续增长”才接近真正违约。反过来,如果封禁要求立刻生效,就不该拿 30 秒告警去掩盖错误的数据路径。
把本章结论压成一次故障排查
凌晨收到“用户资料改完又变回去了”的告警,可以按下面的顺序查,而不是先猜 Redis 丢数据。
先查 users.id = u1001 的 version 和 updated_at,确认数据库事务是否真的提交。数据库没变,是写接口问题;数据库已是 v2,才进入缓存链路。
查 cache:user:profile:u1001 的内容与剩余 TTL。缓存是 v1 且 TTL 很长,说明旧值确实还在服务;key 不存在却页面仍旧,要继续查本地缓存、CDN、只读副本或前端状态。
按请求 ID 串起 UPDATE 提交、DEL 返回、重试入队和回填日志。命中旧值的 GET 不会产生 SET;重点找未命中后读取 v1、较晚才回填的请求。
排查记录最好保留一条完整时间线,而不是只截 Redis 当前值。当前缓存是 v2,不代表五分钟前没有服务过 v1;当前 key 不存在,也不代表删除动作从未失败。把数据库提交时间、版本号、缓存命令结果、回填请求 ID 和异步事件位置放在同一条链上,才能区分“旧值一直没删掉”和“删掉以后又被慢请求写回来”。前者优先修可靠失效,后者优先看回填版本与栅栏。两种现象都叫缓存不一致,修复位置却完全不同。
这一章真正要记住的不是一句“先更新数据库,再删缓存”,而是一套边界:数据库保存事实,Redis 保存可重建副本;默认顺序负责缩小窗口,可靠任务负责最终执行,版本负责阻止旧请求反扑,TTL 负责限制最坏寿命,读己之写负责当前用户体验。任何一层都不该被宣传成绝对一致。
下一章会把同样的边界带到分布式 Session。Session 也有 TTL、共享读写和故障恢复,但它通常不是某张数据库表的简单副本。先分清“可重建缓存”和“运行时登录状态”,后面的过期、续期和强制下线才不会混成一套含糊规则。