同一个公式,换一种写法可能算得准确很多;同一个程序,换一组输入却可能突然失去可信的小数位。遇到这两种情况,修补的方向并不一样。有时要改算法,有时要回头检查数据本身给了我们多少信息。
这一章把两件事分开算清楚。条件数衡量数学问题对输入的敏感程度,稳定性考察算法是否引入了本可避免的误差。到线性方程组那里,你会看到一个残差很小、答案却明显不准的例子。
输入变一点,输出会变多少
设问题是计算 y=f(x)。我们暂时用精确算术,只把输入换成 x+Δx。这时的输出变化来自输入数据,而不是程序的舍入。
若 f 在 x 可微,一阶展开给出
f(x+Δx)−f(x)=f′(x)Δx+o(∣Δx∣).
因此,绝对变化的局部放大率为 ∣f′(x)∣。想比较相对变化,还要分别除以输入和输出的大小。假设 x=0 且 f(x),便有
∣f(x)∣∣f(x+
把系数记成
κf(x)=f(x)
它就是这里采用的局部相对条件数。条件数很大时,我们说这个输入附近的问题病态。“很大”要结合所需精度判断:输入只有约六位可靠数字,若某方向的相对扰动被放大约一万倍,通常不能还指望输出保留六位。
这只是局部的一阶判断,不能把 κ∣Δx∣/∣x∣ 当作任意大小扰动的严格上界。要证明有限扰动的上界,可以在连接 x 与 x+Δx 的区间上估计导数。若其中 ∣f′∣,中值定理才给出 。
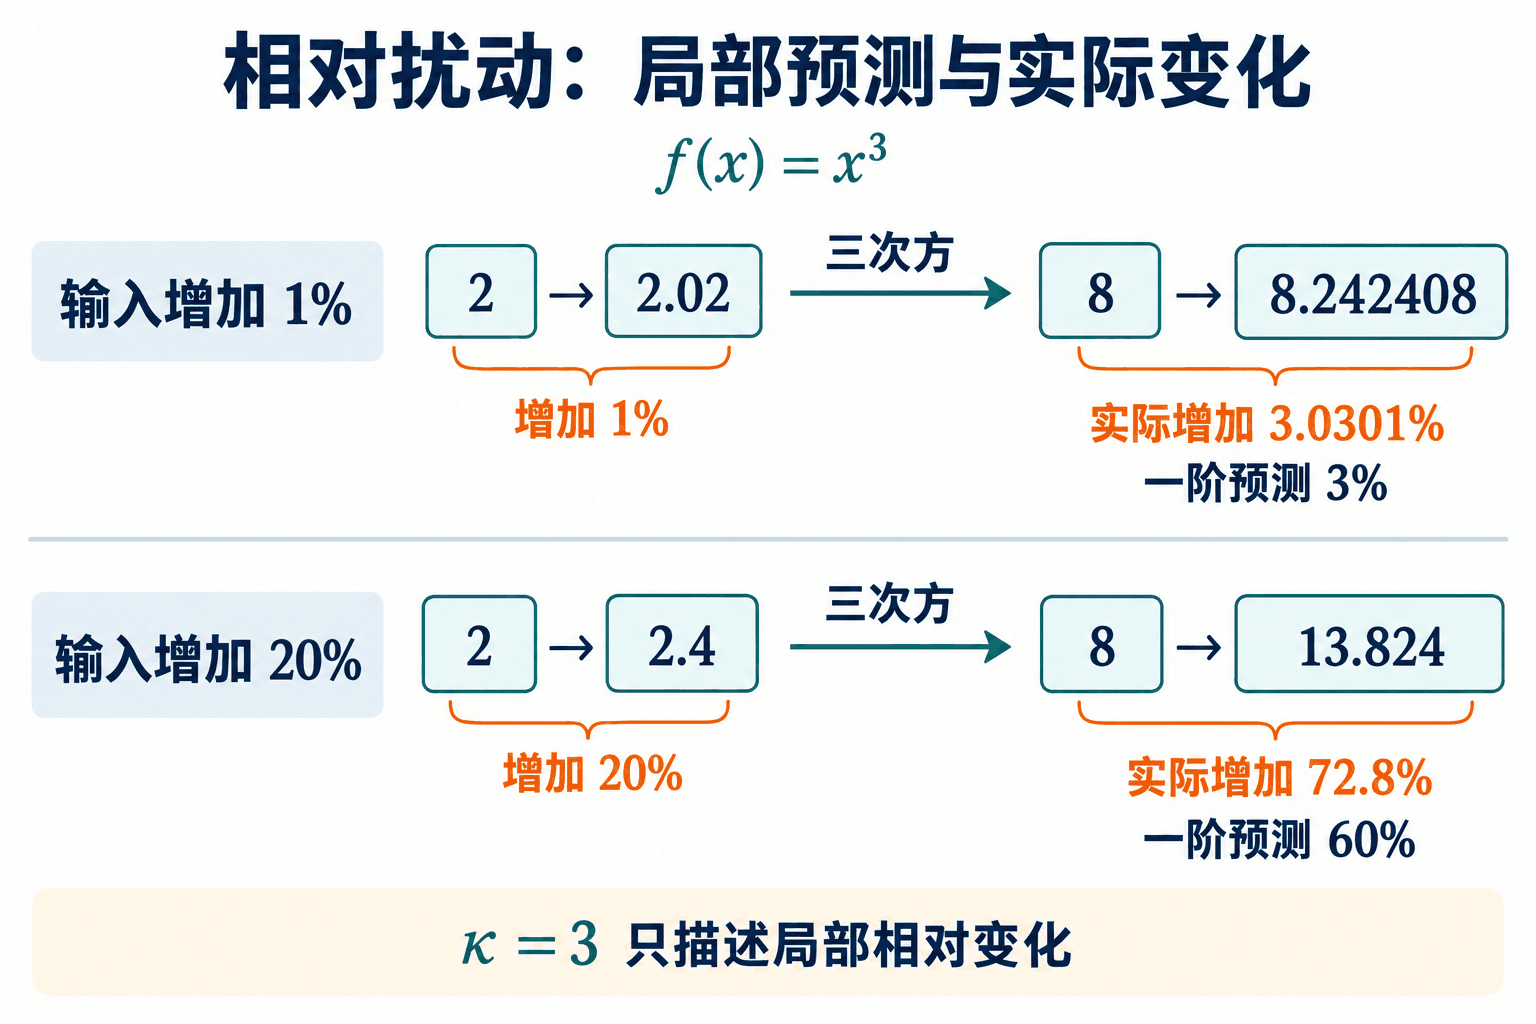
同一个三次方函数:输入增加 1% 时,一阶预测接近实际变化;增加 20% 时,高阶项已不能忽略。
例:三次方的条件数。 对 f(x)=x3 和 x=0,有 κ。输入从 增加到 ,相对增加 。精确输出从 变为 ,相对变化为 ,与局部预测的 很接近。
为什么还差一点?把扰动写成 x(1+δ) 就能看见:
f(x)f(x(1+δ))−f(x)=(
条件数留下了一阶项的大小,后两项并没有消失。若输入增加 20%,实际输出增加 72.8%,已经不能把 60% 的一阶预测当成精确结果。
在输入或输出为零的地方,相应的相对误差没有定义。比如 f(x)=x−1 在 x=1 的输出为零,但绝对条件数仍是 1。此时应使用绝对误差或预先约定的尺度,不能因为一个相对比值无法计算,就说所有误差都“无限大”。
靠近极点时,输入的单位要看仔细
考虑 g(x)=1/(x−1),定义域排除 x=1。当 x=0 时,
g′(x)=−(x−1)2
在 x=2,条件数为 2;在 x=1.01,它已经是 101。输入的百分之一与它离极点的距离,可能根本不在同一个尺度上。
取基准输入 x=1.01,把它相对增加 0.01%,也就是 δ=10−4。新输入为 1.010101,仍未碰到极点。输出的有符号相对变化可以直接算:
g(x)g(x(1+δ))−g(x)=−
输入增加了万分之一,输出约减少百分之一。一阶预测为 −0.0101,两者接近,但并不相等。若扰动后的输入恰好成为 1,函数根本没有有限值;若跨过 1,就更不能沿用跨越极点的局部线性解释。
下面的实验把三次方、平方根和这个倒数函数放在同一个坐标系中比较。先判断:平方根会放大还是缩小小幅相对扰动?把输入设为 4,相对扰动设为 1%,对照实际变化与 0.5% 的一阶预测。然后切到倒数函数,慢慢把基准输入移近 1。留意曲线怎样变陡,以及“扰动很小”到底是相对哪个量说的。
实验里的两条变化线越接近,说明这一次扰动越适合一阶描述;它们分开时,应检查高阶项、输入尺度和定义域。条件数不是额外加进程序的一道放大运算,而是原函数已经具有的性质。
算法会把良态问题算坏
第 01 章算过 h(x)=1+x−1。直接计算时,根号的结果很接近 1,再减去 1,就容易把前面舍入留下的误差显露出来。现在可以检验:这是不是问题本身就特别敏感?
对 x>−1 且 x=0,求导并有理化,得到
κh(x)
当 x→0 时,这个条件数趋于 1。因此,在零附近的非零输入上,输入相对误差并没有理由被严重放大。直接算法丢掉许多位,不能推给问题的条件性。
等价形式
h(x)=1+x+1
保留了小量 x,并把两个接近 1 的数相减换成相加。零附近的分母约为 2,没有小差作分母;在没有上溢、下溢等异常且每步正确舍入的条件下,这条路径的相对误差可控制在舍入单位 u 的常数倍量级。这里判断的是所讨论的输入区间,不能据此给所有输入和实现作保证。
这个量级也能算出来。限定 0<∣x∣≤1/2,把已存储的 x 当作精确输入,假设下面每一步都满足第 01 章的相对舍入模型,且 u≤1/16。记 t=1+、。第一步得到 ,。利用
∣1+δ1−
再加上求平方根这一步至多 u 的相对舍入,得到 q=q(1+εq),其中 。计算分母时, 的误差先乘上 ,再经历一次加法舍入。因此 ,且
∣εd∣≤3u+u+3u2≤5u.
除法的舍入记为 ∣δ4∣≤u,最终
hh
这个界很宽松,作用是说明误差不会随着 x→0 被 1/∣x∣ 放大。输入存储以前的误差还要另算,最终结果若下溢,也不在刚才的假设内。
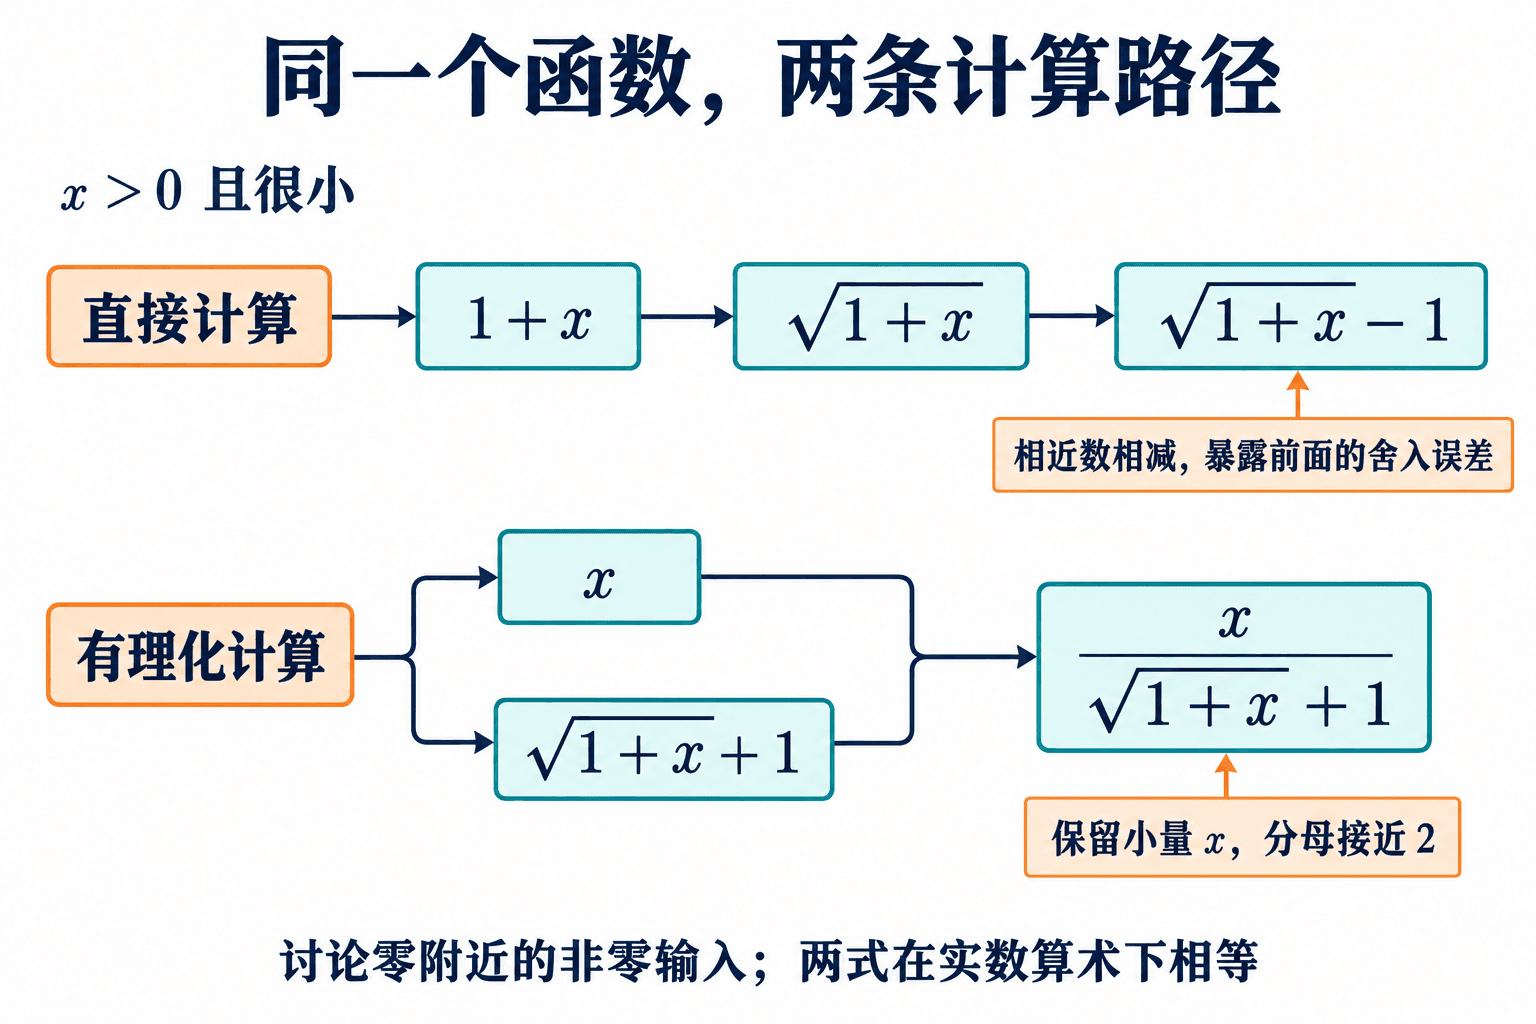
计算同一个小差的两条路径。有理化后的分母是两个正量之和,保留了分子中的小量。
反过来,假设实验测得两个长度 a 和 b,它们各自有误差,目标就是求 a−b。当差远小于两个长度时,问题本身就对独立的测量误差敏感。代数改写不能找回测量中已经丢掉的信息。一个是算法引入了不必要的相消,一个是输入数据本来就不足以确定小差,处理办法不同。
把算出来的答案放回附近的问题
设精确结果为 y=f(x),算法返回 y。前向误差直接比较 y 与 ,绝对值为 ;相对版本还要假设 。
后向误差换一个观察方向:能否找到允许范围内的 x,使
f(x)=y?
若可以,就比较 x 与原输入 x。可能有多个这样的输入,严格定义通常取允许扰动中的最小大小或下确界;若根本不存在,就不能硬套“某个附近问题的精确答案”。允许改哪些数据、采用什么范数,也必须提前说明。
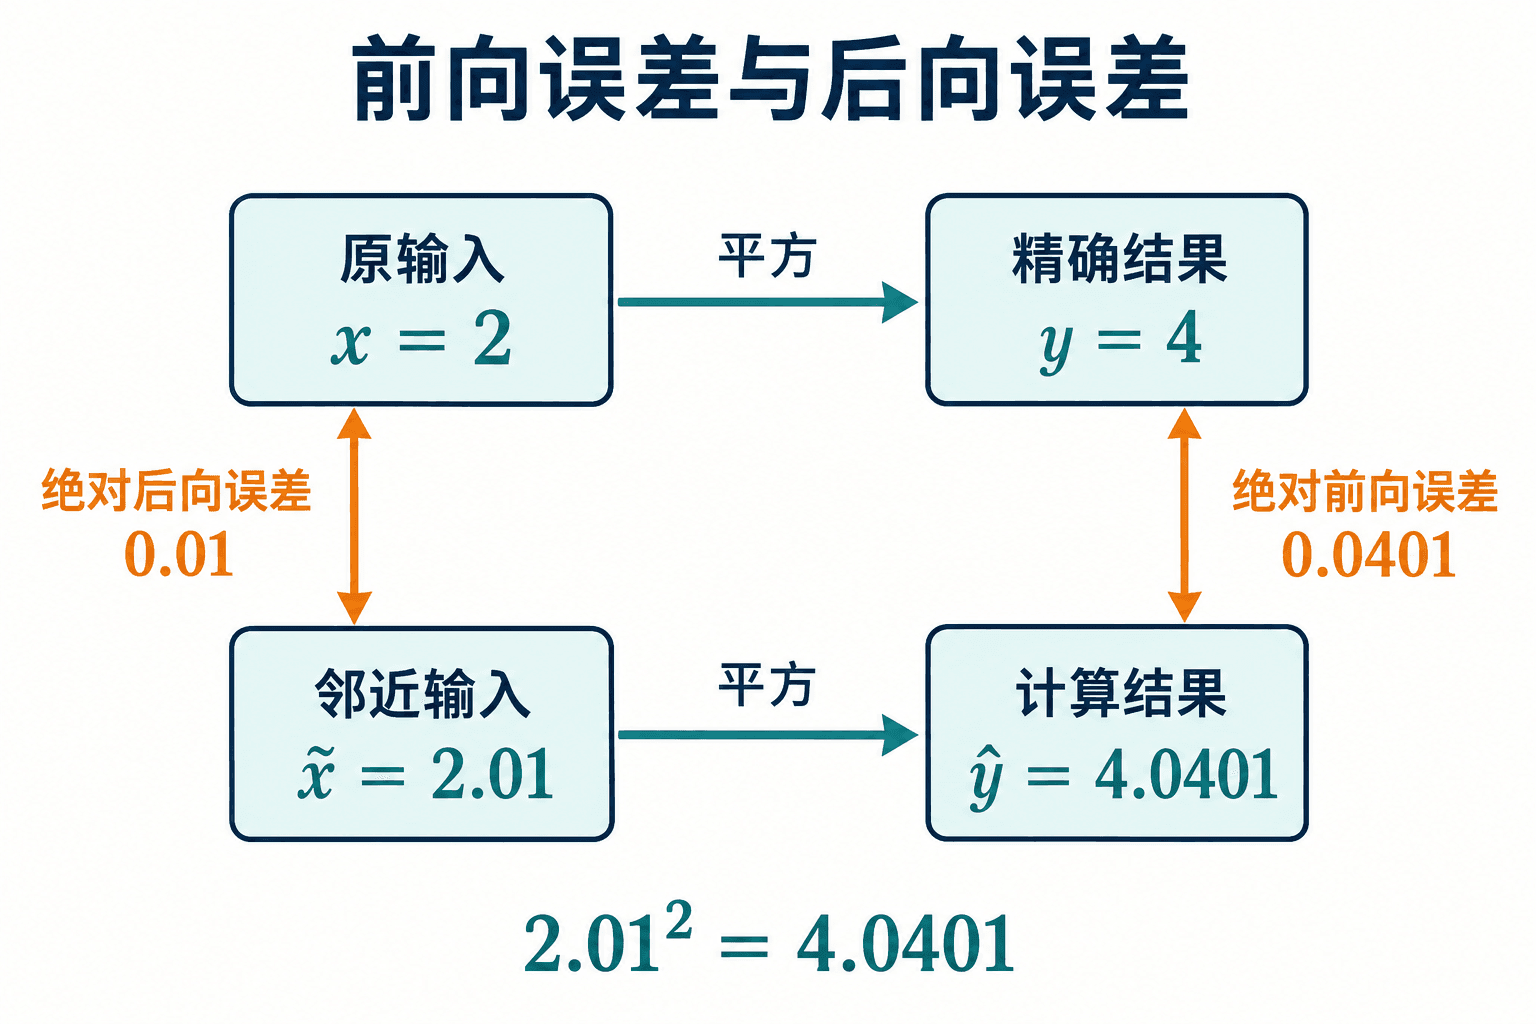
平方运算中,前向误差比较两个输出,后向误差比较两个输入;这里把输入限制为正数。
例:平方运算的前向与后向误差。 输入为 x=2,精确输出是 4。假设一个计算结果为 y=4.0401。它的绝对前向误差是 0.0401,相对前向误差为 0.010025。如果限定输入为正数,满足 的输入是 ;因此绝对后向误差是 ,相对后向误差是 。平方运算的条件数为 2,于是局部预测为 ,与实际相对前向误差接近。
我们称一个算法后向稳定,通常是说在指定的问题类别、扰动方式和计算模型下,它的后向误差能被约束在 Cu 这样的量级,C 可以依赖问题规模,但不能把不受控制的放大藏在里面。一个算例的后向误差小,并不能证明整个算法后向稳定。
若 f 对这次后向扰动可作局部线性分析,就得到常用的理解:前向误差约受“条件数乘以后向误差”控制。一个后向稳定的算法用于病态问题,仍可能产生不小的前向误差。这并不自相矛盾。
小残差能说明什么
线性系统 Ax=b 提供了一个可直接计算后向误差的场景。假设 A 可逆,数值解为 x,定义
r=b−Ax.
因为 Ax=b−r,若只允许改变右端项,计算结果精确求解的就是右端 b−r。相应的扰动是 Δb=,绝对后向误差为 ;当 时,相对后向误差为 。若也允许改变 ,那是另一种后向误差问题,不能把这两个定义混用。
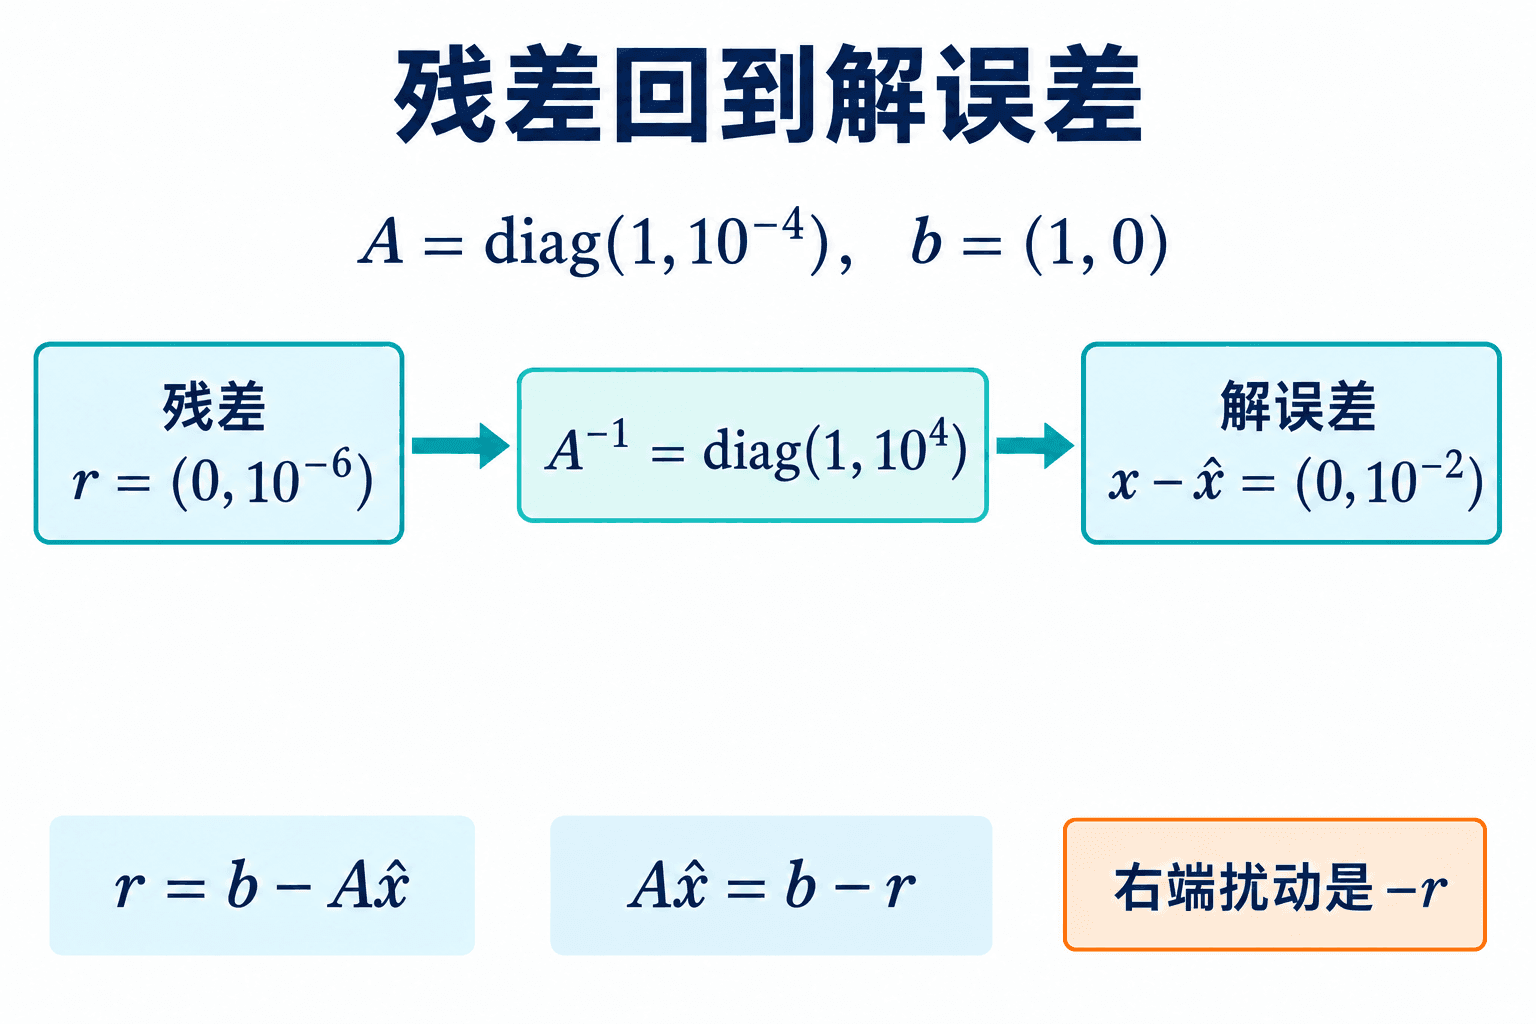
A 的第二个对角元为 10⁻⁴:竖直残差经过 A⁻¹ 后放大一万倍,右端扰动则是 −r。
要把残差转成解误差,从两个方程相减即可:
A(x−x)=r,x−x
对选定的向量范数,用它诱导的矩阵范数,就有 ∥A−1r∥≤∥A−1∥∥r∥。同时,b=Ax 给出 。把这两个不等式合起来,得到
∥x∥∥x−x∥
这里假设 b=0,从而 x=0。矩阵条件数 κ(A) 依赖所选范数;下面统一使用 2-范数。又因为 ,可逆矩阵的条件数至少为 1。
例:相同大小的残差,方向不同。 取
A=[10
矩阵把第二个分量缩小为万分之一,所以 ∥A∥2=1、∥A−1∥2=、。若残差为 ,那么
x−x=A−1r=(0,10
相对残差是 10−6,相对解误差却是 10−2,恰好达到上界。换成同样长度的 r=(10,解误差只有 。条件数给出可能的最大放大程度,并不保证每次扰动都达到它。
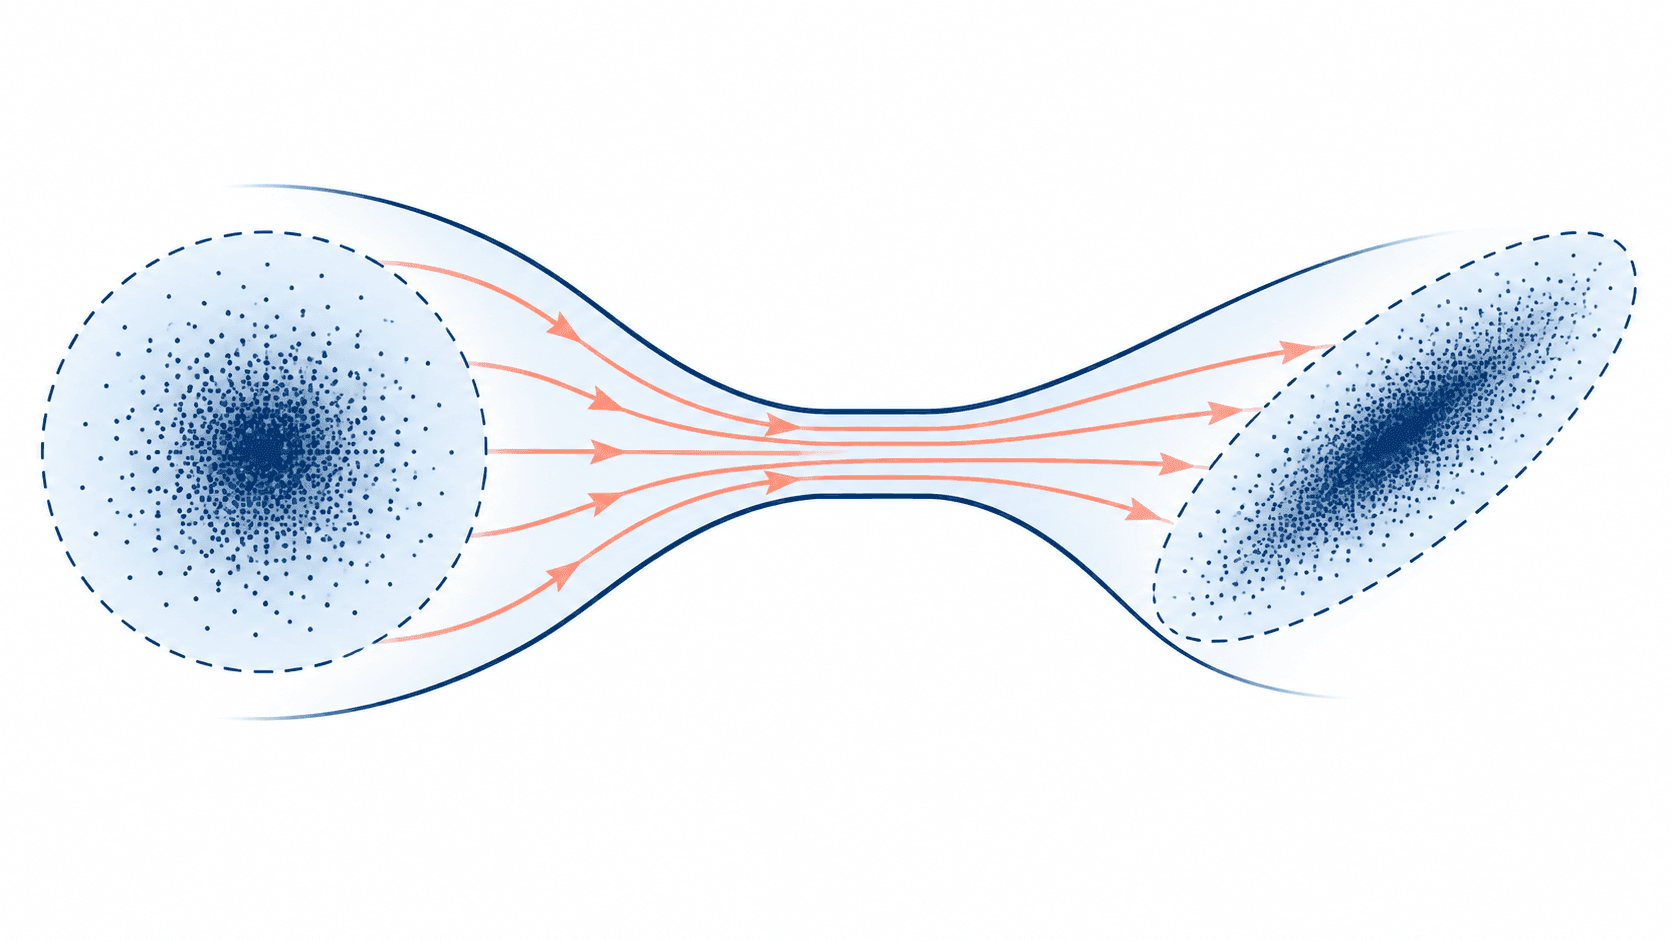
圆形扰动集合变成拉长的集合,示意不同方向受到不同放大;图中方向和比例不对应正文对角矩阵的具体数值。
图中从圆形扰动集合到拉长集合的变化,可以理解为不同方向受到不同放大;它不表示扰动服从某个概率分布。对于上面的对角矩阵,具体放大由 A−1 的两个对角元决定。
在下面的实验中,把第二个对角元设为 10−4,残差大小设为 10−6。转动残差方向之前,猜一猜哪个方向最不利。分别试 0∘ 与 90,核对图中的实际误差与条件数上界;再把矩阵改成单位矩阵,看方向是否还会影响放大倍数。
如果误差上界大于目标精度,只能说这条界不能给出所需保证,不能直接断言当前结果一定不准确。实验里的水平方向就是反例。还应注意,实际程序算出的残差也有舍入误差;第 06 章会讨论为什么迭代改进常需要更可靠的残差计算。
稳定不等于收敛,步长也不是越小越好
收敛考察一族近似是否在参数趋向极限时接近目标。例如在精确算术下,某个方法的误差随 h→0 趋于零。稳定性则关心扰动怎样经过算法传播。后面讨论 ODE 时,还会区分有限时间内的扰动控制和测试方程的绝对稳定域;这些术语有具体定义,不能只看曲线是否平滑。
一种中心差分近似可能同时承受截断误差与函数值的舍入扰动,误差上界模型形如
B(h)=Ch2+hDu,C,D
这是数值微分中常见的模型,第 05 章会推导两项的来源。它不是所有求积算法的通用公式。减小 h 会压低第一项,却抬高第二项;固定精度下,仅凭截断误差收敛还不能保证总误差一直下降。
求这个模型的最小值,令
B′(h)=2Ch−h2
因为 B′′(h)=2C+2Du/h3>0,这是唯一的最小点。在这里 ,两项同量级,但并不相等。实际误差还可能因符号抵消而上下波动, 只是这个上界模型的建议尺度。
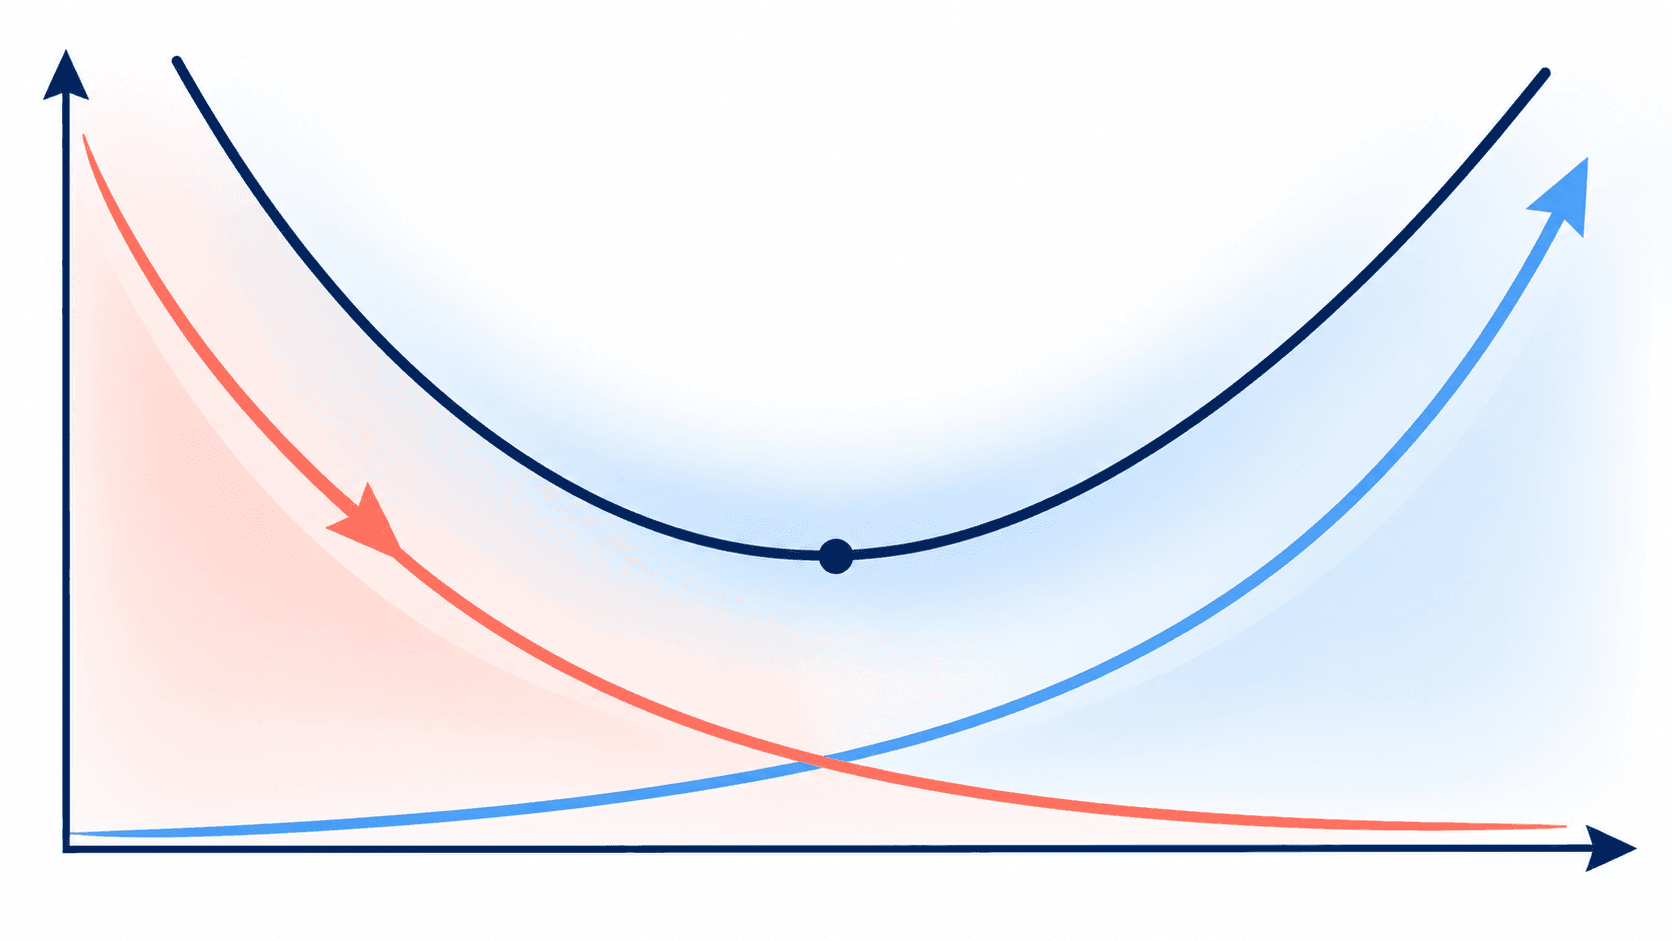
误差趋势示意:横向向右表示步长增大,红线代表舍入影响减小,蓝线代表截断影响增大,黑线示意总误差先降后升;曲线不按指定系数精确绘制。
自己核对这些判断
1. 分别求 f(x)=ex 与 g(x)=x 的绝对条件数和相对条件数,并指出相对公式的使用范围。
对指数函数,绝对条件数为 ex,相对条件数为 ∣x∣,后者按本章定义要求 x=0。在 x=0 可用绝对输入误差描述,不能把输入相对误差直接定义出来。对平方根,在 时绝对条件数为 ,相对条件数为 。靠近零时,绝对敏感性增大,但相对敏感性仍为 ;在零点需另行分析,不能代入除以零的公式。
2. 对 f(x)=x3,输入相对减小 10%。实际输出的有符号相对变化是多少?局部预测是多少?
取 δ=−0.1,实际变化为 (1−0.1)3−1=−0.271,即减少 27.1%。一阶预测为 ,即减少 。差来自 。条件数乘以扰动的大小不能代替有限扰动的精确计算。
3. 输入 x=3,问题为计算 x2,某算法得到 9.0601。限定输入为正,求相对前向误差与最小相对后向误差。这个例子能证明算法稳定吗?
相对前向误差为 0.0601/9≈0.00667778。由于 3.012=9.0601,相对后向误差为 0.01/3=1/300≈0.00333333。正输入下平方严格单调,所以匹配输入唯一。这个单例不能证明算法稳定;还需指定舍入精度,并对所讨论的一类输入建立统一误差界。
4. 在正文的对角矩阵例子中,若 x=(1,0.03)T,求 r、对应的右端扰动 Δb 和相对解误差。请不要漏掉符号。
Ax=(1,3×10⁻⁶)T,所以 ,。解误差 ,相对大小为 ,与 相等。
5. 已知 κ(A)=200,希望相对解误差不超过 10−5。仅使用本章的残差界,相对残差多小才足以保证目标?若观测值略大于这个阈值,又能说明什么?
要求 ∥r∥/∥b∥≤10−5/200=5×10−8。这里还假定条件数与残差的估计可靠。相对残差超过该阈值时,这条上界不能保证目标,但实际误差仍可能较小,因为当前残差未必沿最不利方向。
6. 模型 B(h)=2h2+10−15/h 的最优步长是多少?若舍入项的系数缩小为原来的千分之一,最优步长怎样变?
有 h∗3=10−15/4=2.5×10−16,故 。系数缩小千分之一时,立方根使 缩小十倍。这里优化的是给定上界模型,不能承诺某次实际计算恰好在这个步长取得最小误差。
7. 两次独立长度测量分别给出 a=10.001、b=10.000,各自的绝对误差不超过 0.002。能否用更稳定的减法算法保证差值 0.001 的符号正确?
不能。真实差值与测得的差值最多相差 0.004,所以真实差值可在 [−0.003,0.005] 内,正负都有可能。即使减法完全精确,输入测量也不足以确定符号。需要更准确的数据或更多约束,而不是增加显示位数。
8只要一个算法后向稳定,它在病态问题上就一定有很小的相对前向误差。