半夜告警之后:Redis 生产排障清单
凌晨 02:13,GET /articles/a100 的 P99 从 80 ms 跳到 2.4 s。应用错误日志里同时出现 Command timed out,Redis CPU 升到 92%,数据库连接池也开始排队。值班群里很快冒出三个判断:“肯定是大 Key”“先重启 Redis”“把连接池加大”。
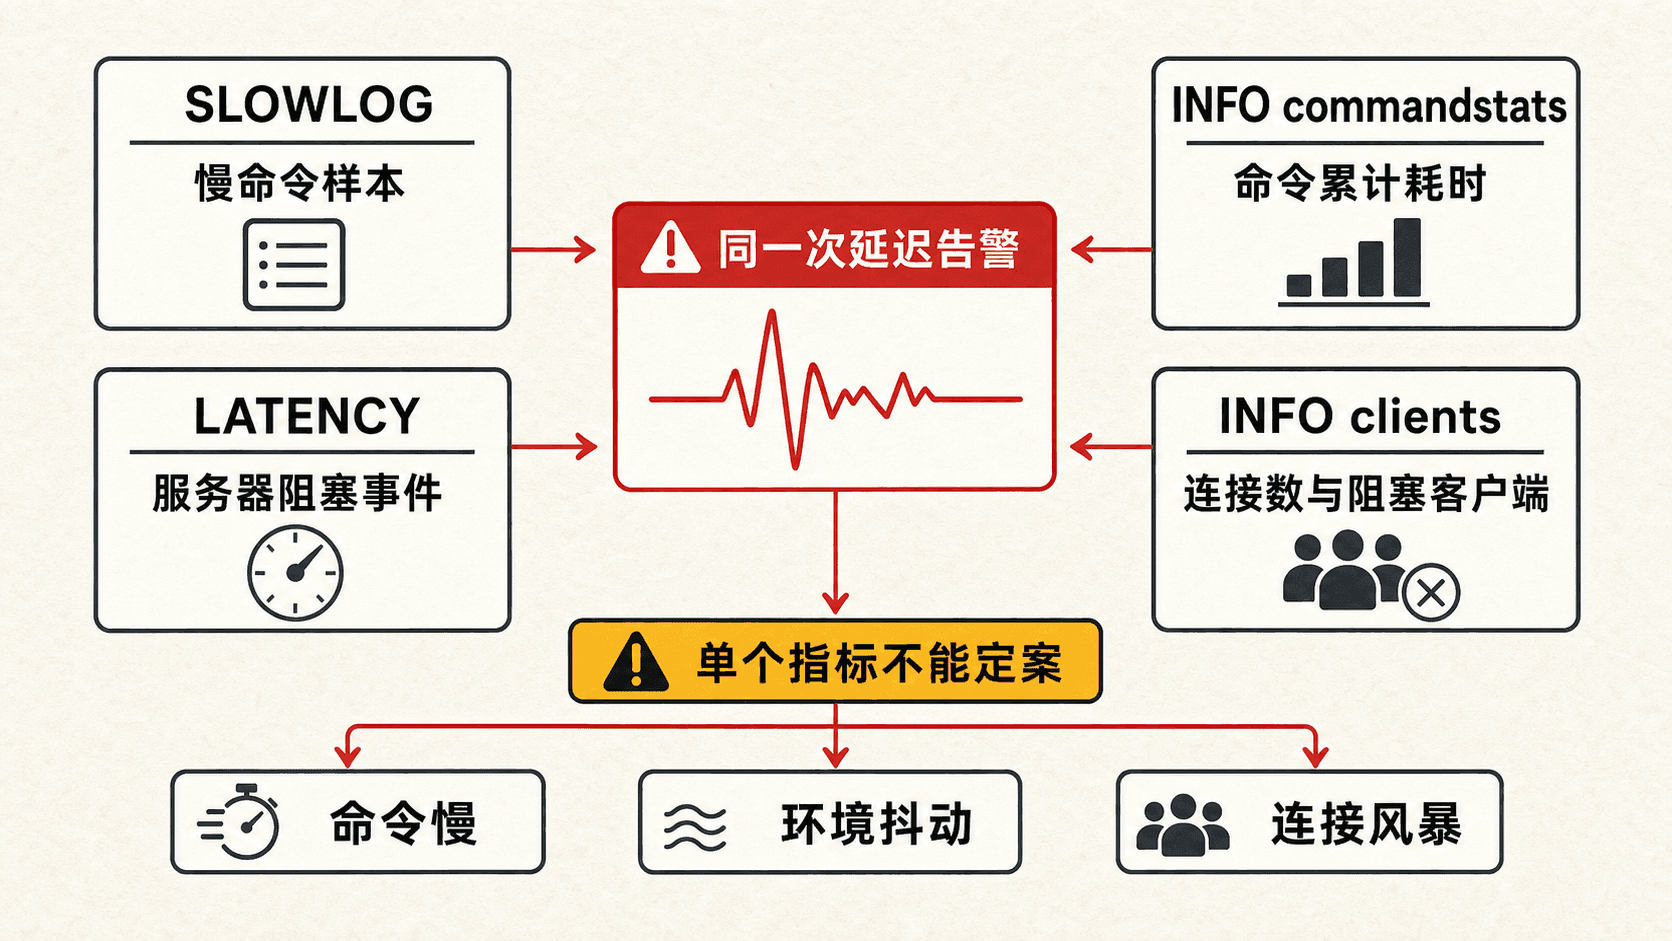
先别动。这三个动作都可能暂时改变现象,却会破坏最有价值的时间关联。重启会清掉慢日志与进程状态;临时扩连接会把连接风暴放大;不确认对象类型就删除所谓大 Key,可能直接把会话或库存状态删掉。生产排障真正难的地方,不是 Redis 有多少条诊断命令,而是同一份延迟告警可能来自客户端排队、网络往返、Redis 主线程、后台 fork、内存淘汰或下游回源。单看一张 CPU 图,定不了案。
这一讲不再按“大 Key、热点 Key、淘汰策略”逐个背名词。我们把它们放回一次完整事故:先保住现场,按客户端、网络、服务端三层缩小范围;再处理大 Key、热点 Key、内存水位;最后把临时止血变成可执行的 runbook。前面各讲做出的 user:profile:u1001、diag:hot:article:a100、排行榜和 Stream 也会继续出现,因为生产问题从来不是凭空出现的,它总是落在某个接口、某类 key 和某段调用链上。
告警响起后的前五分钟,先保留证据
第一件事不是执行命令,而是确定事故窗口。记录告警开始时间、受影响接口、应用版本、Redis 节点或分片、是否刚发布、是否正在扩缩容、是否发生 RDB 快照或 AOF 重写。所有截图和命令输出都带上时间。没有时间轴,后面看到的峰值很容易互相错配:应用 02:13 的 P99,拿去对 Redis 02:18 的 CPU,结论没有意义。
第二件事是保存低成本快照。下面这组命令不要求遍历整个 keyspace,适合先看趋势。受管 Redis 可能限制部分管理命令,运行前也要遵守平台权限和脱敏要求。
bash
date -u
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" PING
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO server
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO clients
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO memory
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO stats
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO persistence
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO replication
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" INFO commandstats
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" SLOWLOG GET 32
redis-cli -h "$REDIS_HOST" -p "$REDIS_PORT" LATENCY LATEST
不要把 INFO 的单次绝对值当作结论。total_commands_processed、keyspace_hits、keyspace_misses、evicted_keys、expired_keys、rejected_connections 都是累计计数,要用两次采样的差值除以时间间隔,才能得到“每秒发生多少”。同理,commandstats 的 calls 和 usec 也是累计量。服务重启会让计数归零,因此快照里还要保存 uptime_in_seconds 与进程启动时间。
第三件事是判断是否需要立即降级。若错误率仍在上升,就先保护业务边界:隐藏非核心周榜、暂停预热任务、限制缓存未命中回源、降低批任务并发、对可重建缓存读快速失败。库存确认、会话鉴权这类不能靠旧值猜测的路径,宁可失败关闭,也不要为了“可用”放过错误状态。
排障现场禁止顺手执行 FLUSHALL、FLUSHDB、KEYS *,也不要长时间开启 MONITOR。MONITOR 会流式返回实例收到的命令,本身有性能成本,还可能暴露业务参数。必须临时使用时,也应先评估权限、脱敏、持续时间与实例负载,并优先在可控环境复现。
先把慢分成客户端、网络和服务端
应用里的一次 Redis 调用,至少经过四段时间:等待连接、建立或恢复连接、网络往返、Redis 执行命令。如果应用观察到 800 ms,而 SLOWLOG 里同一时间没有慢命令,并不代表 Redis “没问题”;它只说明被记录的服务端命令执行没有越过阈值。排队、DNS、TLS、跨可用区网络、响应体传输和客户端反序列化,本来就不计入 Slow Log 的执行时间。
客户端先看等待,而不是只看连接成功
Node.js 侧至少记录这些字段:命令名、业务 key 的类型或前缀、总耗时、是否等待连接、重试次数、Redis 节点、错误码。不要把完整 key 和 value 打进日志,用户 ID、Session token 与请求参数都可能是敏感数据。
一次连接风暴通常有这样的时间线:Redis 或网络短暂抖动,数百个应用实例同时断开;每个实例立即重连;默认离线队列继续收命令;网络恢复时,大量积压命令和新请求一起冲向 Redis。此时 connected_clients 突然上升,应用内存与事件循环延迟也可能升高。真正的问题不只在服务器能不能接住连接,还在客户端是否允许请求无限等待。
面向可降级缓存读取,可以从有限重试、退避加抖动和关闭离线队列开始:
js
import Redis from "ioredis";

export function createCacheRedis() {
  const client = new Redis({
    host: process.env.REDIS_HOST,
    port: Number(process.env.REDIS_PORT ?? 6379),
    lazyConnect:
这段配置只适合“失败后可以限流回源或返回降级内容”的缓存客户端。阻塞式 XREADGROUP、后台任务和库存扣减拥有不同的等待语义,不能共用同一套超时。maxRetriesPerRequest: null 会让请求一直等到连接恢复,在后台消费者中也许可接受,放进在线接口却可能让请求早已超时、命令仍留在队列里。
网络要从两端量
在应用主机执行 redis-cli --latency,测到的是从该位置到 Redis 的往返表现;在 Redis 所在主机执行 redis-cli --intrinsic-latency,测到的是操作系统与虚拟化环境能提供的延迟下限,它甚至不连接 Redis。二者回答的问题不同。前者升高、Slow Log 平静,优先看网络、跨区路由、TLS 和客户端;内在延迟本身就高,则要看宿主机抢占、虚拟化抖动与操作系统调度。
还要检查请求和响应大小。一个 300 KB 的 GET 在 Redis 内部可能执行得不慢,但传给大量客户端会占用网卡与客户端输出缓冲。应用 P99 上升、Redis CPU 不高、instantaneous_output_kbps 和输出缓冲增长,往往就是这一类问题。此时继续找“慢命令”会走错方向。
服务端要把事件和命令对上
如果应用与 Redis 的延迟在同一秒升高,再看 LATENCY LATEST 或 LATENCY DOCTOR。Latency Monitor 默认关闭,需要提前按业务延迟预算配置 latency-monitor-threshold;事故发生后才打开,它不会补录过去的事件。它能区分 command、fork、expire-cycle、eviction-cycle、AOF 写入等阻塞事件,比一张总 CPU 图更接近原因。
下面的决策树把几个入口放在一起。它的价值不是替你自动定案,而是迫使每一步都拿到下一份证据。
慢命令、阻塞事件和命令总量要互相作证
SLOWLOG GET 32 能回答“哪些命令在 Redis 执行阶段超过阈值”。记录中包括命令、执行耗时、客户端地址和客户端名称。它不包含网络 I/O 时间,因此 Slow Log 空白与应用很慢可以同时成立。还要先确认配置:
bash
redis-cli CONFIG GET slowlog-log-slower-than
redis-cli CONFIG GET slowlog-max-len
redis-cli SLOWLOG LEN
redis-cli SLOWLOG GET 32
阈值单位是微秒。设得太高会漏掉对低延迟接口已经不可接受的命令;设得太低、列表又很短,则样本很快被覆盖。调整运行时配置前要走变更流程,并把相同设置写回配置来源,否则重启后会恢复旧值。
拿到一条慢命令后,先问四件事:它是什么类型的 key;元素数或 value 大小是多少;调用量是否刚刚增加;复杂度是否随集合大小增长。一个单次很慢、每天只跑一次的离线命令,和平均只慢 2 ms、每秒调用十万次的命令,处置顺序完全不同。
INFO commandstats 补上“量”的维度。假设两次采样相隔 60 秒,cmdstat_hgetall 的 calls 增加 600000,usec 增加 1800000,那么这段时间平均每次服务器执行约 3 微秒,但 QPS 达 10000。它可能不是 Slow Log 主角,却能吃掉大量 CPU。相反,某个 SUNION 每次 80 ms,调用不多,也会周期性卡住其他请求。生产排障要同时找“很慢的一次”和“很密的许多次”。
blocked_clients 也经常被误读。它统计等待 BLPOP、XREAD BLOCK 等阻塞命令的客户端,业务设计如此时,大于零完全正常。异常的是它突然偏离基线,或者在线接口误用了阻塞连接。阻塞式消费者应该使用专用连接;若与普通 GET 共用一条连接,后续命令会排在阻塞读取后面,应用看起来像 Redis 整体卡住。
连接问题继续看 CLIENT LIST,重点观察 name、addr、age、idle、cmd、查询缓冲和输出缓冲。它的复杂度随连接数增长,连接风暴中不要高频轮询完整列表。给 ioredis 连接设置可识别但不含敏感信息的名称,例如 article-api:cache:pod-17,才能把慢日志、客户端列表和部署单元对起来。
“Redis CPU 高”不是根因。可能是大量廉价命令堆出的吞吐瓶颈,也可能是少数集合命令、Lua 脚本、过期清理或淘汰循环占住主线程。先把 commandstats 的增量、Slow Log 样本和 LATENCY 事件对齐,再决定是改调用量、改数据结构,还是改容量。
Big Key 事故:300 KB 不只是占了 300 KB
统一教学项目里建立了一个明确样本:
js
await redis.set("diag:big:string", "中".repeat(100000));
await redis.rpush(
  "diag:big:list",
  ...Array.from({ length: 150 }, (_, i) => `item-${
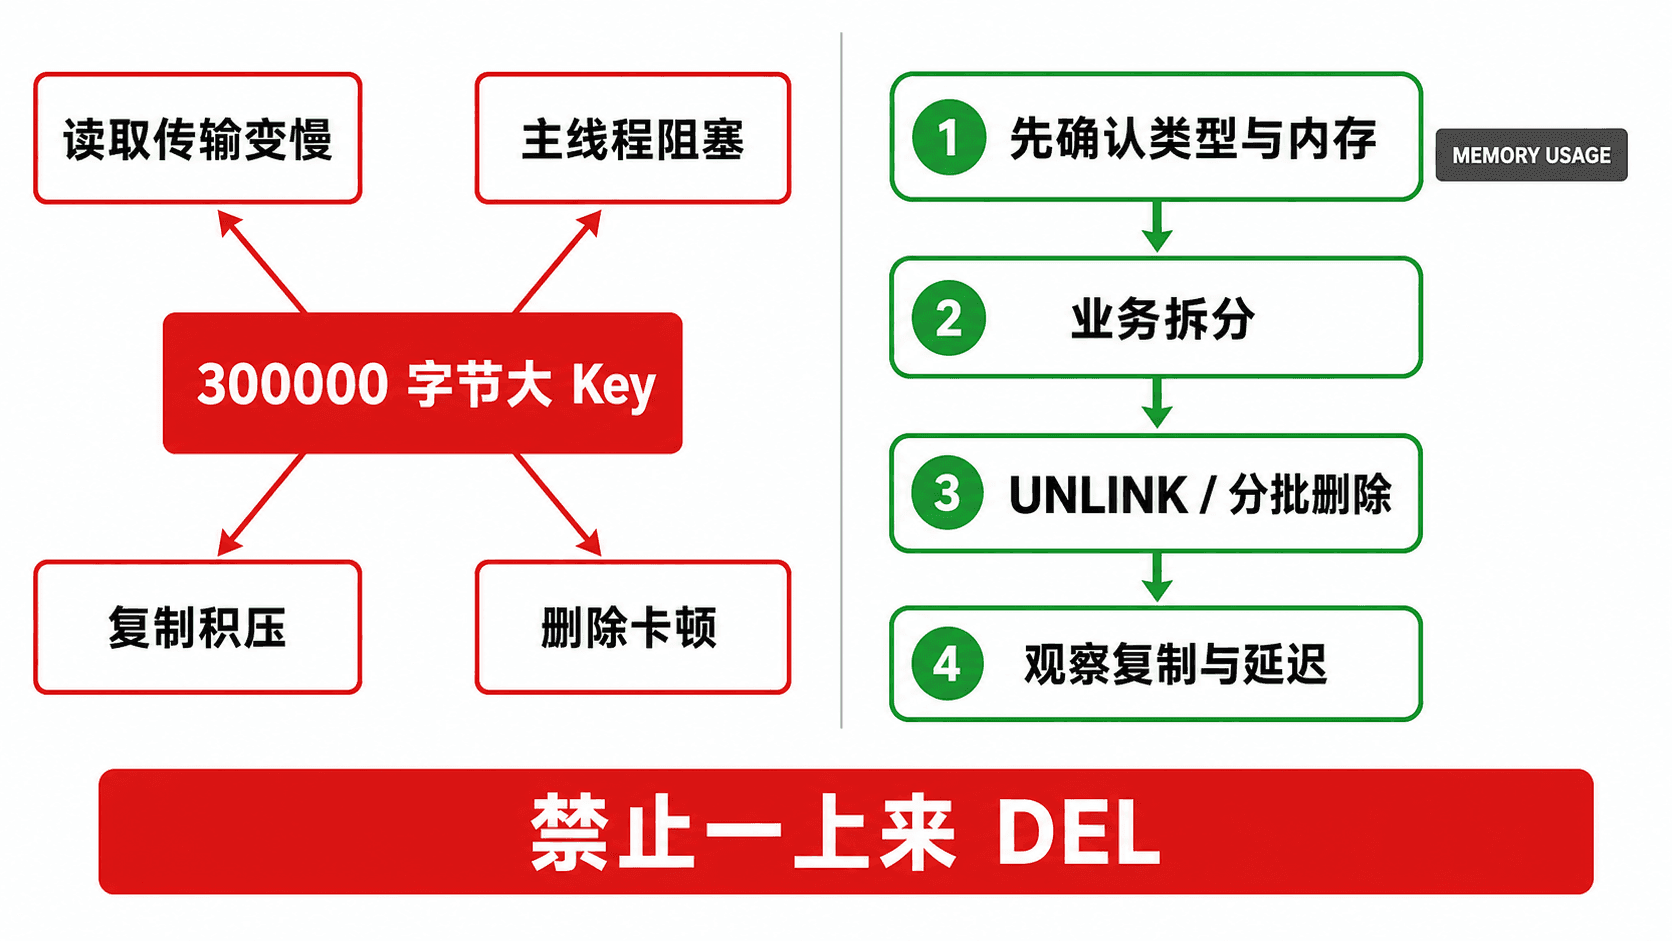
在 Redis 8.2.2 上,redis-cli --bigkeys 找到 diag:big:string 的逻辑长度为 300000 字节,MEMORY USAGE diag:big:string 返回 311344 字节:
text
Sampled 18 keys in the keyspace!
Biggest list found "diag:big:list" has 150 items
Biggest string found "diag:big:string" has 300000 bytes
text
311344逻辑长度和内存占用不是同一个指标。后者还包含 Redis 对象、编码与分配器开销,而且会随版本和环境变化。--bigkeys 更偏向找各类型中元素很多或逻辑长度大的 key;--memkeys、--keystats 与 MEMORY USAGE 更接近实际内存。不要背“超过 10 KB 就是大 Key”这种统一门槛。一个 key 是否危险,取决于命令复杂度、访问频率、网络带宽、复制与持久化成本,以及业务可以接受的延迟。
先确认类型,再确认大小
对已知候选 key,可以做有边界的检查:
bash
TYPE diag:big:string
MEMORY USAGE diag:big:string SAMPLES 5
STRLEN diag:big:string

TYPE diag:big:list
MEMORY USAGE diag:big:list SAMPLES 5
LLEN diag:big:list
Hash、Set、ZSET 分别看 HLEN、SCARD、ZCARD,但元素数少不代表每个 field 或 member 都小。抽样内容时必须避开敏感值,并限制返回量。全库 --bigkeys、--memkeys、--keystats 都会用 SCAN 渐进遍历,虽然不像 KEYS * 一次阻塞整个 keyspace,却仍然消耗 CPU、网络与命令配额。大实例应在低峰限速运行,使用 -i 插入间隔,并保存游标或缩小匹配范围。
删除也会形成一次大操作
发现 diag:big:list 后,最危险的动作是直接对未知规模的对象执行 DEL。DEL 需要在主路径释放对象;UNLINK 先把 key 从 keyspace 摘除,再把内存回收交给后台线程,通常更适合删除可一次失效的大对象:
js
const type = await redis.type("diag:big:string");
const bytes = await redis.memory("USAGE", "diag:big:string", "SAMPLES", 5);

if (type === "string" && bytes > 256 * 1024) {
  await redis
但 UNLINK 不是“没有成本”。后台仍要释放内存,复制与 AOF 仍要传播删除,突然删除很多大对象还会形成 lazy-free backlog。对需要保留部分数据的大 Hash、Set 或 ZSET,可以用 HSCAN、SSCAN、ZSCAN 找到一小批元素,再分批 HDEL、SREM、ZREM;每批都要设置上限、观察延迟,并处理扫描期间集合仍在变化的语义。
更稳妥的长期改造通常是业务拆分。例如把一个用户所有动态塞进 feed:u1001,可以按月份或页拆为 feed:u1001:2026-08:0001;一次返回整份商品 JSON,可以拆成基础信息与低频扩展字段。拆分会增加 key 数、请求数量和一致性边界,因此要结合 pipeline、批量读取和生命周期设计,不能为了消灭“大”而制造上百次网络往返。
下面的取证实验台同时展示对象大小与访问热度,避免把 Big Key 和 Hot Key 混成一个词。
Hot Key 事故:全局有余量,单个分片已经喘不过气
热点文章 a100 上首页后,所有请求都读取 diag:hot:article:a100。教学项目连续读取 300 次,再运行 redis-cli --hotkeys,得到的关键结果是:
text
Sampled 18 keys in the keyspace!
hot key found with counter: 11 keyname: "diag:hot:article:a100"
hot key found with counter: 8  keyname: "rate:sliding:u1001"
hot key found with counter: 7  keyname: "rank:weekly:2026-W34"
hot key found with counter: 7  keyname: "stream:orders"
随后 OBJECT FREQ diag:hot:article:a100 也返回 11。300 次读取没有得到 300,因为 Redis 的 LFU counter 会概率递增并随时间衰减,它表达的是相对热度,不是精确访问次数。--hotkeys 还要求实例使用 LFU 类淘汰策略。若生产策略不是 allkeys-lfu 或 volatile-lfu,不要为了跑一次命令就在线切换策略;优先使用网关、客户端埋点、代理层或分片级网络指标确认热点。
大 Key 和热点 Key 是两条轴。300 KB 且每秒读 2 次的对象,主要风险可能是尾延迟和带宽;20 字节但每秒读 20 万次的 key,主要风险是单分片 CPU 与网卡。一个 key 又大又热时,风险相乘:每次响应搬运大量数据,单节点带宽先被打满,慢客户端的输出缓冲也继续增长。
热点读的第一选择通常是减少远程访问。对允许几十秒陈旧的文章详情,可以在应用进程内加容量受控、短 TTL 的本地缓存,并用请求合并让同一时刻只有一个协程去 Redis。代价是每个实例各有一份副本,失效传播变复杂,实例越多总内存越大。
把一个逻辑 key 随机拆成 article:a100:copy:0..7 也能分散读取,但只有这些副本落到不同分片时才真正分散服务端压力。单机 Redis 里复制八份,只是增加内存。更新时还要删除或刷新八份副本,读到旧值的窗口更长。副本读能增加读容量,却会引入复制延迟;刚写完必须立即读到的新值,不应无条件路由到副本。
热点写更难。计数器拆成多个桶后,读取总数必须聚合;限流 key 拆散后,原来的全局限额会变成多个局部限额;库存不能随机写多份再期望它们自动一致。分散热点是一笔明确交易:用更多内存、聚合成本和更弱的即时一致性,换取更大的吞吐。
内存到红线时,淘汰策略不会替你做业务判断
used_memory 接近 maxmemory 时,Redis 会按 maxmemory-policy 决定是否淘汰 key。这个行为很容易被误解为“内存自动清理”。实际上,Redis 只认识访问信息、频率和 TTL,不知道 session:sess_demo_001 比 user:profile:u1001 更难重建,也不知道 inventory:sku1001 根本不该作为可随意淘汰的唯一库存状态。
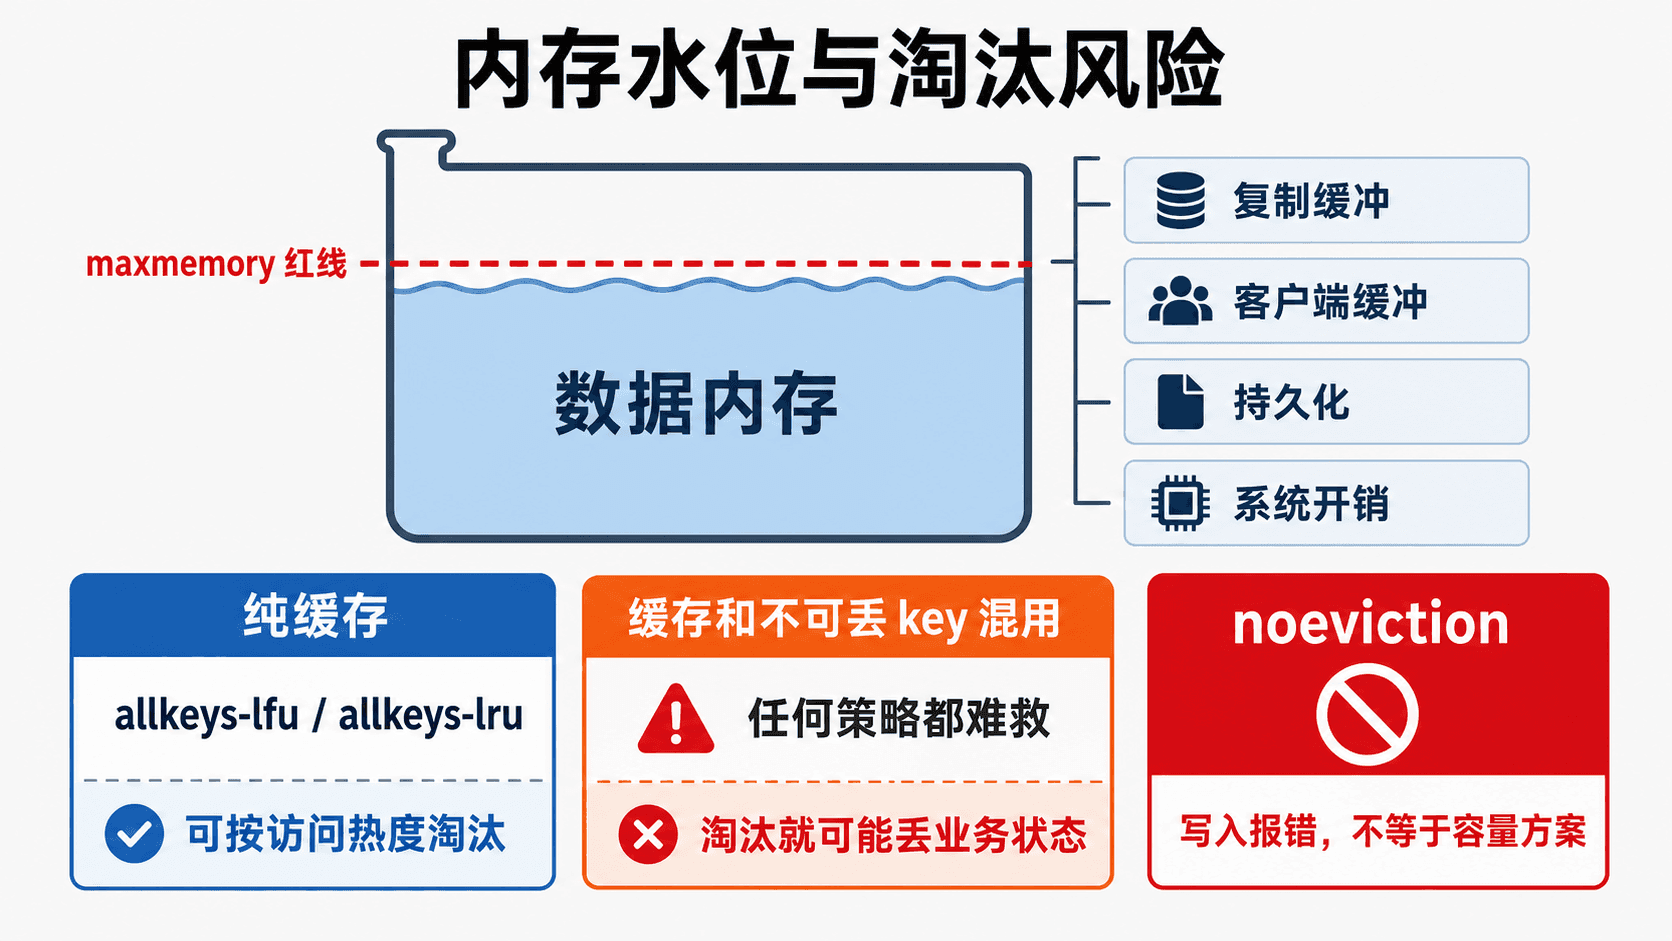
常见策略可以按候选集合来理解:
LRU 与 LFU 是采样近似,不维护一份精确全局排序。不要把策略切换当成无风险开关,也不要用单次命中率判断哪种“最好”。比较前要定义业务损失:被淘汰后一次回源花多少、是否会击穿数据库、某类 key 能不能消失。
最危险的是把缓存和不可丢状态放进同一实例。使用 allkeys-lfu,会话、幂等标记和库存 key 也可能被淘汰;改成 volatile-lfu,不带 TTL 的状态 key 可能占满内存,使可淘汰候选越来越少,最终写入仍然失败;改成 noeviction 只是把静默删除换成显式 OOM 错误,并没有创造容量。可靠的方案是按数据责任拆实例或至少拆资源边界,让“可淘汰”成为实例级契约。
下面的模拟器可以调节 TTL 占比、访问倾斜与策略。重点观察 volatile 策略没有候选时发生什么,以及一批无 TTL key 如何挤占整个水位。
内存告警要看红线外面的空间
教学实例的状态是:
text
used_memory_human:2.20M
maxmemory_human:64.00M
maxmemory_policy:allkeys-lfu
这只能说明当时数据量离配置上限还很远,不能推出生产实例应该使用相同比例。复制 backlog、AOF 缓冲和部分客户端缓冲不会简单地被 maxmemory 红线包住,操作系统、共享库和分配器也要占内存。观察 mem_not_counted_for_evict、used_memory_rss、客户端缓冲与宿主机可用内存,才能知道进程是否真的安全。
evicted_keys 的增量一旦持续出现,说明实例已经在用命中率换空间;命中率下降后,数据库回源可能随即升高。expired_keys 突增则可能来自正常 TTL 到期,也可能是同批缓存整点失效。告警最好把淘汰速率、命中率、回源量与数据库连接池放在一张图上,才看得到因果链。
RSS 很高,不等于数据还在涨
Redis 删除 2 GB key 后,used_memory 可能下降,操作系统看到的 used_memory_rss 却不立刻下降。分配器通常会保留已经获得的内存页,以便后续复用。此时只看 mem_fragmentation_ratio = used_memory_rss / used_memory,很容易误判“碎片率爆炸”。
INFO memory 里要把几个量分开:
used_memory是 Redis 通过分配器使用的内存;used_memory_rss是操作系统看到的驻留内存;allocator_frag_ratio更接近分配器外部碎片;mem_fragmentation_bytes与allocator_frag_bytes提供绝对字节差;used_memory_peak能解释为什么刚删完很多数据后 RSS 仍贴近历史峰值。
比例必须和绝对量一起看。一个空实例只有几 MB 数据,进程与共享库的固定开销就能让比例很高,却不构成容量事故。反过来,1.15 的比例放在 200 GB 实例上,绝对差可能很大。先观察一段时间内是否复用、宿主机是否有压力,再评估主动碎片整理、滚动重启或迁移;不要看到比例超过某个模板阈值就立刻重启。
MEMORY PURGE 只是请求分配器释放可能归还的页,不保证 RSS 下降,也可能带来工作量。activedefrag 会用 CPU 换取碎片整理。两者都应该先在同版本与相似负载下演练,放进变更窗口,而不是半夜告警时的第一反应。
fork、COW 和过期风暴会在同一条时间线上叠加
RDB BGSAVE、AOF 重写和部分复制过程需要 fork。fork 时主进程要复制页表,数据集越大、宿主环境越慢,主线程停顿越明显。子进程存在期间,主进程继续处理写入;被修改的内存页触发 Copy-On-Write,于是 RSS 可能在短时间内显著上升。高写入流量、大数据集与后台持久化碰到一起,既会产生延迟,也会把宿主机推向 OOM。
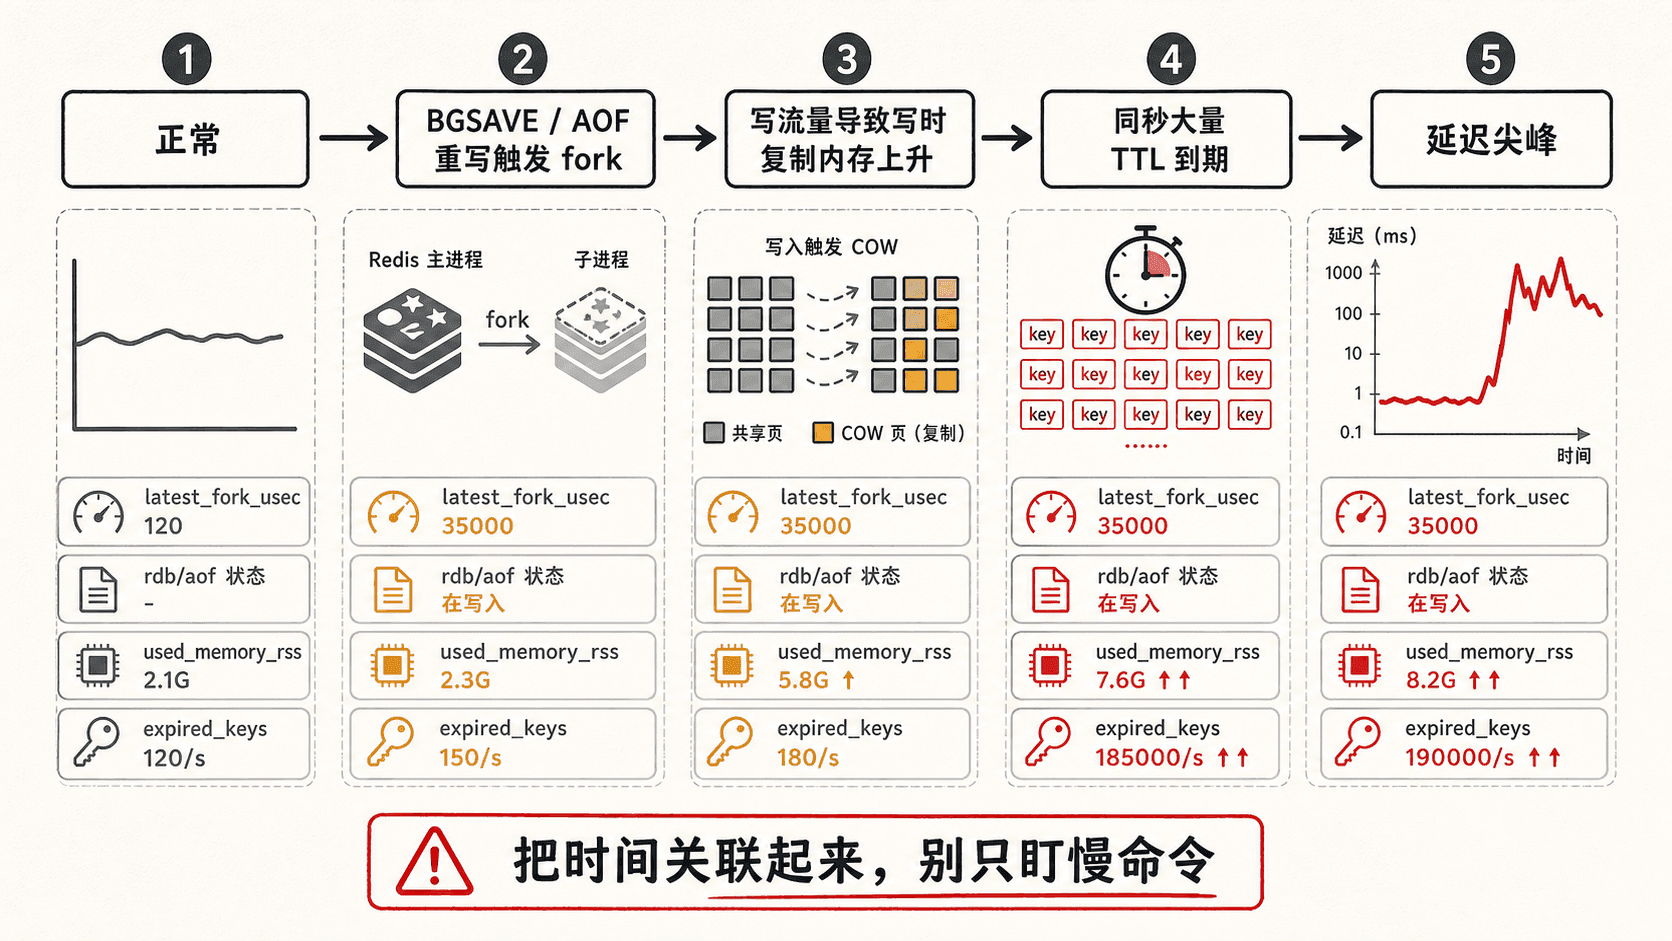
排查时把这些字段放进同一时间窗:
bash
redis-cli INFO persistence
redis-cli INFO memory
redis-cli INFO stats
redis-cli LATENCY LATEST
重点看 latest_fork_usec、rdb_bgsave_in_progress、aof_rewrite_in_progress、rdb_last_cow_size、aof_last_cow_size 与 used_memory_rss。看到 fork 事件,不要只调慢日志,因为 fork 不是一条业务命令;看到 RSS 上升,也不要直接判定内存泄漏,它可能是后台子进程期间的 COW。
过期风暴是另一种“没有明显慢命令,Redis 却突然卡”的来源。Redis 会在访问过期 key 时被动删除,也会周期性抽样做主动过期。若数十万缓存都设置为同一个整点 TTL,主动过期循环会集中工作;与此同时大量请求又未命中并回源数据库,Redis 与数据库两边一起抖。
TTL 抖动要在写入时做,而不是事故后才补:
js
function stableTtlSeconds(key, base = 1800, jitter = 300) {
  let hash = 0;
  for (const char of key) {
    hash = (hash * 31 + char.codePointAt(0)) >>> 0
稳定抖动让同一个 key 的策略可预测,不同 key 又分散到一个时间带。它不能解决 Redis 节点整体故障,也不能替代热点互斥回填;它只降低“同一批 key 在同一秒到期”的概率。若业务必须在整点切换,可以采用逻辑版本、预热新 key、分批失效,而不是让所有旧 key 同秒物理删除。
危险命令的风险,不只写在命令名字上
很多生产事故不是某条命令“绝对不能用”,而是执行者没有给它限定数据规模、运行时间和影响节点。KEYS user:* 在只有几十个 key 的隔离实例里看不出问题,到了数亿 key 的主节点上却要一次遍历 keyspace;Redis 在这段时间里还要让其他请求等待。线上找 key 应改用 SCAN,但也不能误以为 SCAN 免费。它只是把一次大遍历拆成多次小工作,完整跑完仍会消耗 CPU、网络和命令处理时间。
集合命令也一样。HGETALL cart:u1001、SMEMBERS campaign:users、ZRANGE ranking 0 -1 单看名字很普通,复杂度却跟元素数和返回量一起增长。代码评审不能只查 KEYS,还要查所有“把全集返回给客户端”的调用。更稳妥的接口会设置分页或数量上限,并在写入侧限制单 key 元素数;否则今天的小集合会在几个月后悄悄变成大 Key。
MONITOR 适合观察命令流,却会把收到的命令持续推给客户端。高流量实例上,它既增加服务端工作和网络输出,又可能把 key、参数或业务标识暴露给观察者。排查命令构成时,优先看 commandstats、慢日志和应用埋点。真的需要短时采样,也必须限定权限、时间、节点和数据处理方式,结束后确认连接已经关闭。
删除类命令要按对象大小区分。DEL 一个小字符串没有必要紧张,DEL 一个包含数百万成员的集合却可能让主线程做大量释放工作;UNLINK 把回收移到后台,更适合整个对象失效。FLUSHDB、FLUSHALL 的问题更直接:目标不是单个业务 key,而是整个逻辑库甚至整个实例。即使平台支持异步选项,也不代表数据能够恢复。共享实例中不应把它们放进日常应用账号权限。
脚本和事务也能制造长时间占用。Lua 脚本在 Redis 内连续执行,循环扫描大集合或一次处理海量参数时,其他客户端只能等。MULTI/EXEC 里排入几万条命令,同样会形成一大段连续工作。这里的安全边界不是“用了 Lua 就原子、用了 pipeline 就快”,而是每次请求有多少命令、每条命令处理多少数据、最坏情况要占用多久。
CONFIG SET、DEBUG、SHUTDOWN、MIGRATE、模块管理等命令更应使用独立运维账号和审批流程。运行时修改配置还存在一个常见陷阱:它不一定同步回声明式配置或 redis.conf,重启后可能恢复旧值。事故中的临时变更必须记录旧值、新值、执行人、节点、回滚条件和持久化方式;否则这次止血会变成下一次重启后的新事故。
最后给“只读诊断”也加预算。CLIENT LIST 随连接数增长,MEMORY USAGE 对聚合类型可采样,--bigkeys、--memkeys 与 --hotkeys 会扫描 keyspace。一个命令没有修改数据,不等于不会影响延迟。生产 runbook 应写清允许在哪类节点执行、每次最多持续多久、何时中止,以及优先去副本还是必须在主节点取证。
把止血动作写成一份可照着执行的 runbook
事故中最浪费时间的,是每个人都知道十条命令,却没人知道先做哪一条。下面这份清单应结合团队权限、托管平台与业务边界调整,并在演练环境中跑过。
发现阶段
- 记录告警窗口、接口、部署版本、Redis 节点和最近变更;确认是所有接口还是单个业务 key 前缀受影响。
- 从应用、Redis、数据库三端保存同一时间窗的 P50/P95/P99、错误率、连接等待、回源量、CPU、网络与内存。
- 保存
INFO clients/memory/stats/persistence/replication/commandstats、SLOWLOG GET、LATENCY LATEST,所有累计值按时间差计算速率。 - 判断业务降级:可重建缓存限流回源,非核心榜单隐藏,库存与鉴权失败关闭。
定位阶段
- 应用慢、Slow Log 不慢:查连接等待、重试、离线队列、DNS/TLS、网络往返、响应大小与序列化。
- Slow Log 有样本:按命令、key 前缀、类型、元素数和调用方聚合;结合
commandstats增量判断是少数慢操作还是高频小操作。 blocked_clients上升:先区分正常阻塞消费者与异常共享连接,再查CLIENT LIST的name、cmd、缓冲和来源地址。- 内存逼近红线:看
evicted_keys、expired_keys、mem_not_counted_for_evict、RSS、策略和 TTL 占比;确认实例是否混入不可淘汰状态。 - 延迟事件是
fork、expire-cycle或eviction-cycle:沿时间轴核对持久化、COW、批量 TTL 与内存水位,不要继续只盯 Slow Log。
止血阶段
- 优先停掉造成放大的上游:无界重试、缓存预热、全库扫描、大批量删除、离线任务和高频管理命令。
- Big Key 先确认业务归属与类型;可整体失效时用
UNLINK,需要保留时分批处理,并持续观察延迟、复制和 lazy-free 压力。 - Hot Key 读先做请求合并、容量受控的本地缓存或副本读评估;拆副本前确认是否跨分片,并写清更新代价。
- 容量不足时先限制写入放大和非核心流量,再按预案扩容或迁移。临时换淘汰策略必须知道哪些 key 会消失,不能在混合实例上盲切。
恢复与复盘阶段
流量恢复后不要立即宣布结束。验证应用 P99、Redis 延迟、错误率、数据库回源、命中率和连接池是否一起回到基线;检查副本延迟、持久化状态与被淘汰数据是否能正确重建。随后给事故补上四个具体结果:第一个异常信号是什么,哪个放大环节把局部故障变成全链路故障,哪条自动保护没有生效,下一次用什么指标提前发现。
容量告警也不要只写“内存 80%”。至少覆盖:数据集与 maxmemory 的比例、宿主机可用内存、RSS 与绝对碎片字节、复制/AOF/客户端缓冲、淘汰与过期速率、连接数与拒绝连接、命令 P99、应用回源量。阈值要来自实例的正常基线和增长速度。今天 70% 但每天增长 5%,比长期稳定在 82% 更需要提前行动。
Redis 的性能问题,最后都是取舍问题
回到 02:13 的告警。如果 SLOWLOG 指向一个巨大的 HGETALL,修复重点是对象边界和读取方式;如果 Slow Log 平静、应用连接等待很长,重点是客户端超时、重连与网络;如果 LATENCY 记录了 fork 和 expire-cycle,重点是实例规模、写入量、持久化窗口与 TTL 分布;如果 evicted_keys 上升后数据库连接池才排队,真正的链路是内存压力导致命中率下降,再由无界回源拖垮数据库。
这些结论没有一条是“Redis 不够快”。Redis 把很多操作放在内存里,并通过清楚的数据结构和单命令边界提供低延迟;代价是单次大操作会影响其他请求,热点会集中到分片,内存有上限,持久化和复制要争用 CPU、内存与 I/O,缓存与数据库也不会自动一致。
所以,生产上真正可靠的姿势不是寻找一个永不出事的淘汰策略,也不是收集更多排障命令。它是提前决定哪些数据能丢、能旧、能重建,给每类客户端设定等待边界,为 TTL、对象大小、热点、内存和后台任务留出预算,再用同一时间窗里的证据验证判断。Redis 带来的速度从来不是免费的;我们要做的,是让这笔交换在事故发生前就写清楚。