排行榜不是把分数塞进 ZSet 就结束了
上一讲我们用计数器承接高并发写入。排行榜看起来只是给计数器加一个排序:用户完成学习任务,积分加上去;首页取前十名;个人中心再查一下“我排第几”。于是很多实现只剩三条命令:ZINCRBY、ZREVRANGE、ZREVRANK。
这样的榜单在演示环境里通常很漂亮,真正跑到周日结算却容易出问题:同分用户每次看到的名次和产品规则不一致;翻到第二页时有人突然加分,上一页的人又出现一次;补发积分执行两遍,榜首凭空多出 100 分;新一周开始后,迟到的旧事件又把已经结算的榜单改了;为了扩容把读取发到副本,用户加完分却看到自己还没动。
所以这一讲不把 Sorted Set 当成主角。我们要围绕学习活动里的 weekly_rank 做一张可以更新、可以解释、可以结算、也可以纠错的周榜。Redis 负责维护当前顺序,业务事件和数据库负责回答“为什么是这个分数”。这条边界比会背多少条 ZSet 命令更重要。
先把一张榜的契约写清楚
我们先固定场景:2026-W34 是一个自然周学习榜,member 使用稳定的用户 ID,score 是本周有效学习积分。最小 key 定为:
text
weekly_rank:2026-W34member 只放 u1001 这样的 ID,不把昵称和头像 JSON 塞进去。昵称会修改,头像会换;如果它们参与 member,改资料就等于换了一个榜单成员。列表接口先从 ZSet 取用户 ID 和分数,再批量查询用户摘要缓存或数据库。这样,排序索引和展示资料的生命周期不会绑死。
一张榜至少要先约定下面这些问题:
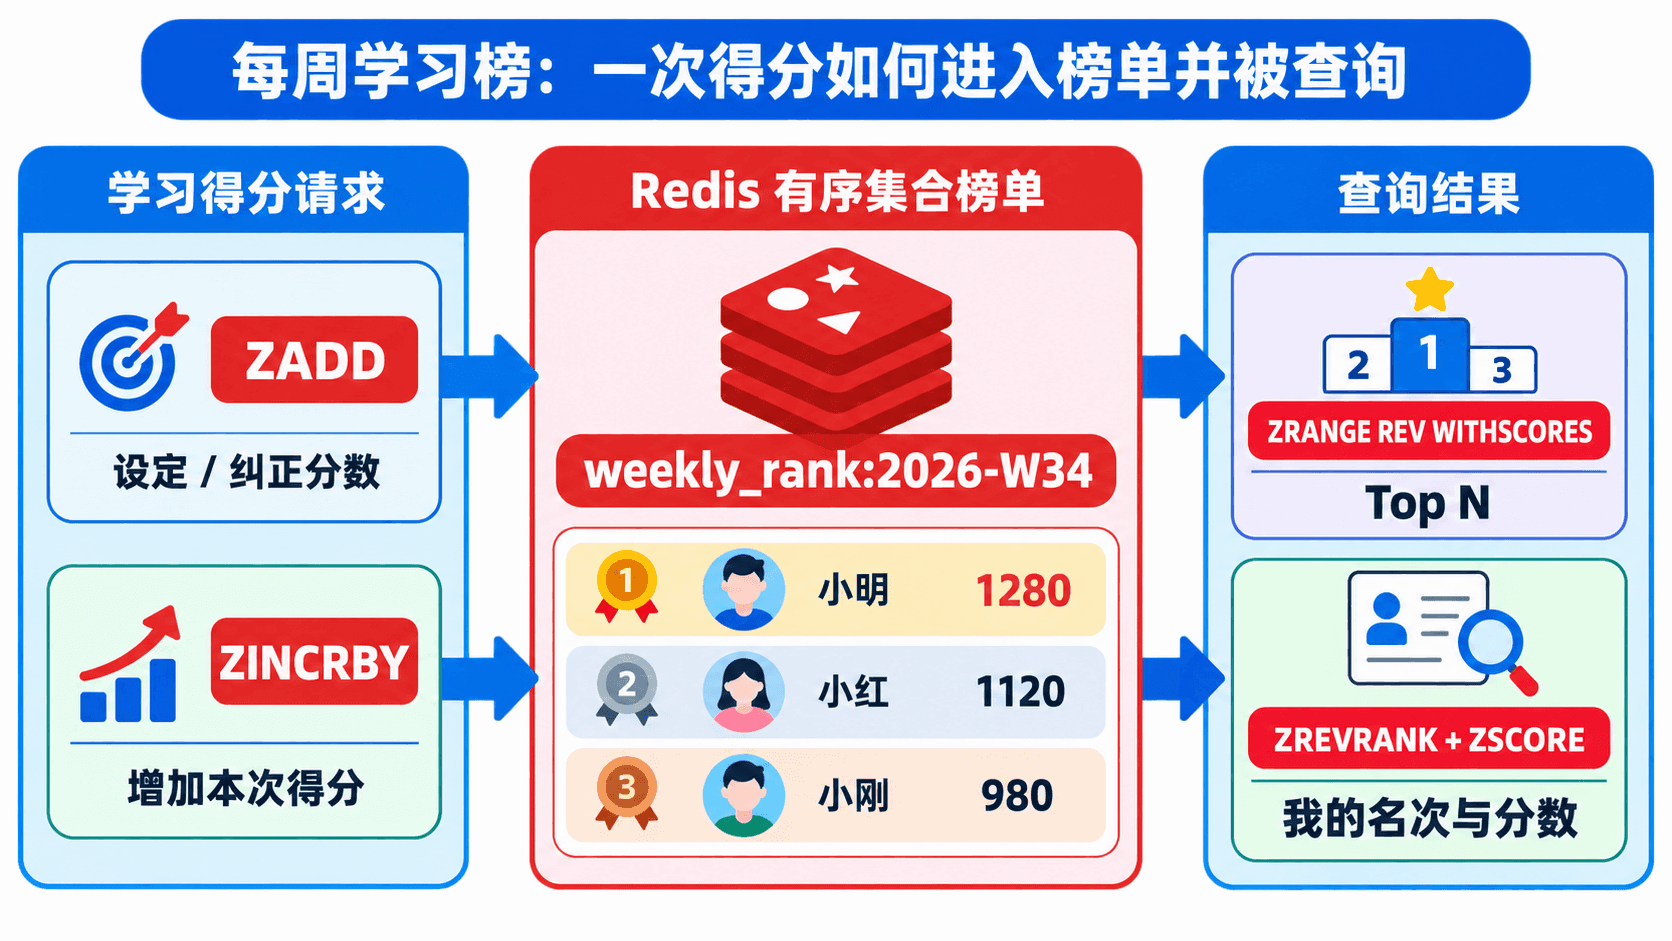
接着看最小可运行版本。ZADD 适合导入或直接设置最终分数;ZINCRBY 适合在原始积分模型里做原子增量。ZREVRANGE 按高分到低分读取区间,ZREVRANK 返回从 0 开始的位置,所以界面名次要加 1。
js
import Redis from "ioredis";

const redis = new Redis({ host: "127.0.0.1", port: 6379 });
const key = "weekly_rank:2026-W34";

await redis.zadd(
  key,
  1250, "u1001",
  980, "u2001",
  1420, "u3001",
);

await redis.zincrby(key, 300, "u2001");

const rows = await redis.zrevrange(key, 0, -1, "WITHSCORES");
const rank = await redis.zrevrank(key, "u1001");

console.log(rows);
console.log({ userId: "u1001", displayRank: rank === null ? null : rank + 1 });
text
[
  'u3001', '1420',
  'u2001', '1280',
  'u1001', '1250'
]
{ userId: 'u1001', displayRank: 3 }
这里的原子性只覆盖“一次 ZINCRBY 不会被另一次增量覆盖”。它不保证消息只消费一次,也不保证 Redis 加分和数据库积分流水同时成功。排行榜是积分事件的投影,不该是唯一账本。
下面的实验台可以直接切换 ZADD 与 ZINCRBY,观察设置分数、增量更新、返回值和 0-based rank 的区别。
如果“完成一节课加 20 分”来自可重试的消息,不能看到 ZINCRBY 是原子的就直接调用。消息重复两次,Redis 会正确地加两次。生产写入需要事件 ID 去重,数据库流水还要对 event_id 建唯一约束。
别把设置分数和增加分数混成一个接口
ZADD 与 ZINCRBY 看起来都能让排名变化,业务含义却不同。导入“用户当前总分为 1250”时,应使用 ZADD;处理“本次任务增加 20 分”时,才使用 ZINCRBY。如果同步任务误把总分 1250 当成增量执行两次,Redis 会忠实地得到 2500。命令没有出错,错的是接口没有说清输入究竟是状态还是事件。
建议把应用接口也分开:setProjectedScore(userId, version, total) 只接受带版本的最终状态,applyPointEvent(eventId, userId, delta) 只接受可去重的积分事件。调用方不能只传一个含义模糊的 score。日志要记录榜单周期、用户、事件 ID、原始增量、投影前后分数和规则版本,遇到投诉时才能沿着同一组字段排查。
ZADD 还有 NX、XX、GT、LT 等条件选项。它们适合表达“只新增”“只更新已有成员”“只允许分数上升”之类的局部约束,却不能代替业务校验。例如 GT 可以阻止旧的低分覆盖新高分,但无法处理合法扣分;一旦榜单允许撤销积分,单纯禁止下降反而会把错误成绩永远保留下来。版本号比“只许变大”更准确,因为它描述的是事件新旧,而不是分数方向。
查询接口也应把“不在榜上”和“排在第零名”分开。ZREVRANK 查不到 member 时返回空值,查到榜首时返回 0。如果代码写成 if (!rank),榜首和缺席都会进入同一分支。前面的示例使用 rank === null,就是为了守住这个看似不起眼的边界。
同分时,Redis 不知道谁先到
最容易被忽略的事故来自同分。假设 u1002 和 u1009 都是 1500 分,产品经理说“先达到 1500 分的人在前”。你按到达顺序先写 u1009,再写 u1002,结果并不会保留写入顺序。ZSet 先比较 score;score 完全相同时,再按 member 的二进制字典序比较。倒序读取还会把这段字典序一并反转。
redis
ZADD weekly_rank:2026-W34 1500 u1009
ZADD weekly_rank:2026-W34 1500 u1002
ZRANGE weekly_rank:2026-W34 0 -1 WITHSCORES
ZREVRANGE weekly_rank:2026-W34 0 -1 WITHSCORES
text
ZRANGE    -> u1002 1500, u1009 1500
ZREVRANGE -> u1009 1500, u1002 1500
这不是随机排序,但它也不是“稳定保持写入顺序”。只要 member 不变、score 不变,结果就可重复;规则却只是用户 ID 的字节顺序。中文昵称、数字字符串和大小写混在一起时,这个顺序更不适合直接当产品规则。
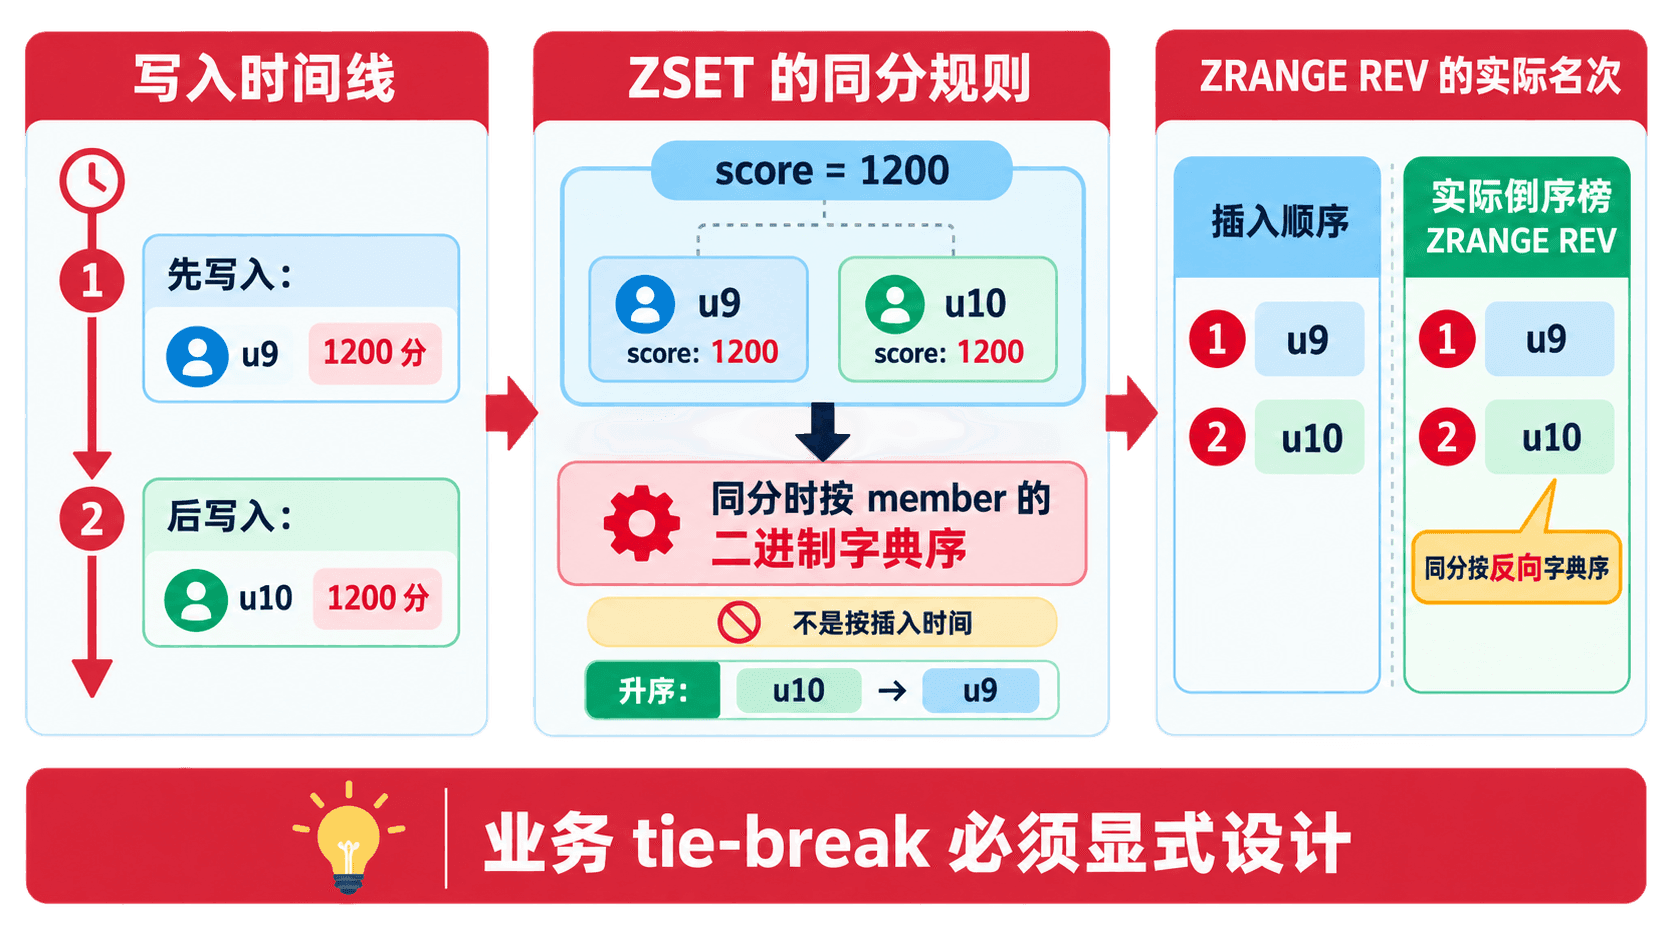
如果业务接受“同分并列”,最干净的做法是展示相同名次,不把 ZSet 的位置直接当竞赛名次。例如三个人分数为 1600、1500、1500,位置是 1、2、3,但竞赛名次可以显示 1、2、2。接口读取一段数据后,按相同 score 合并展示名次即可。需要注意,分页边界若切在同分组中间,就要把整组补齐或在产品上接受拆组。
如果业务必须“同分时先达到当前分数的人在前”,就要显式编码 tie-break。一个可控的整数方案是:
text
复合分数 = 原始积分 × B + (B - 1 - 本周达成序号)B 必须大于一个周期内可能出现的最大序号。倒序读取时,原始积分高的人一定在前;原始积分相同,序号更小、也就是更早达到的人得到更大的尾数。达成序号要由服务端生成,并保存到积分投影元数据中,不能拿各客户端上报的时间直接比较。
这时不要再对复合分数执行普通的 ZINCRBY delta。加 20 个原始积分,真正应该移动的是 20 × B,而“达到新分数的时间”也可能需要重置。更稳妥的写法是先在原子脚本中读出原始积分与规则元数据,算出新复合分数,再 ZADD 覆盖;或者让数据库积分流水算出最终投影,由消费者幂等地写入。
下面的探索器把写入顺序、member 字典序和复合分数放在一起。先拖动写入顺序,再切换规则,你会看到“谁先写入”和“谁排在前面”本来就是两件事。
复合 score 有一条看不见的精度边界
复合分数不是想留几位就留几位。Redis 的 score 是 64 位双精度浮点数,整数在 -2^53 到 2^53 之间可以精确表示,边界值是 9007199254740992。再往外,并不是命令报错,而是相邻整数可能落到同一个浮点值上。这种错误最麻烦:系统仍能运行,只有某些高分用户的 tie-break 悄悄失效。
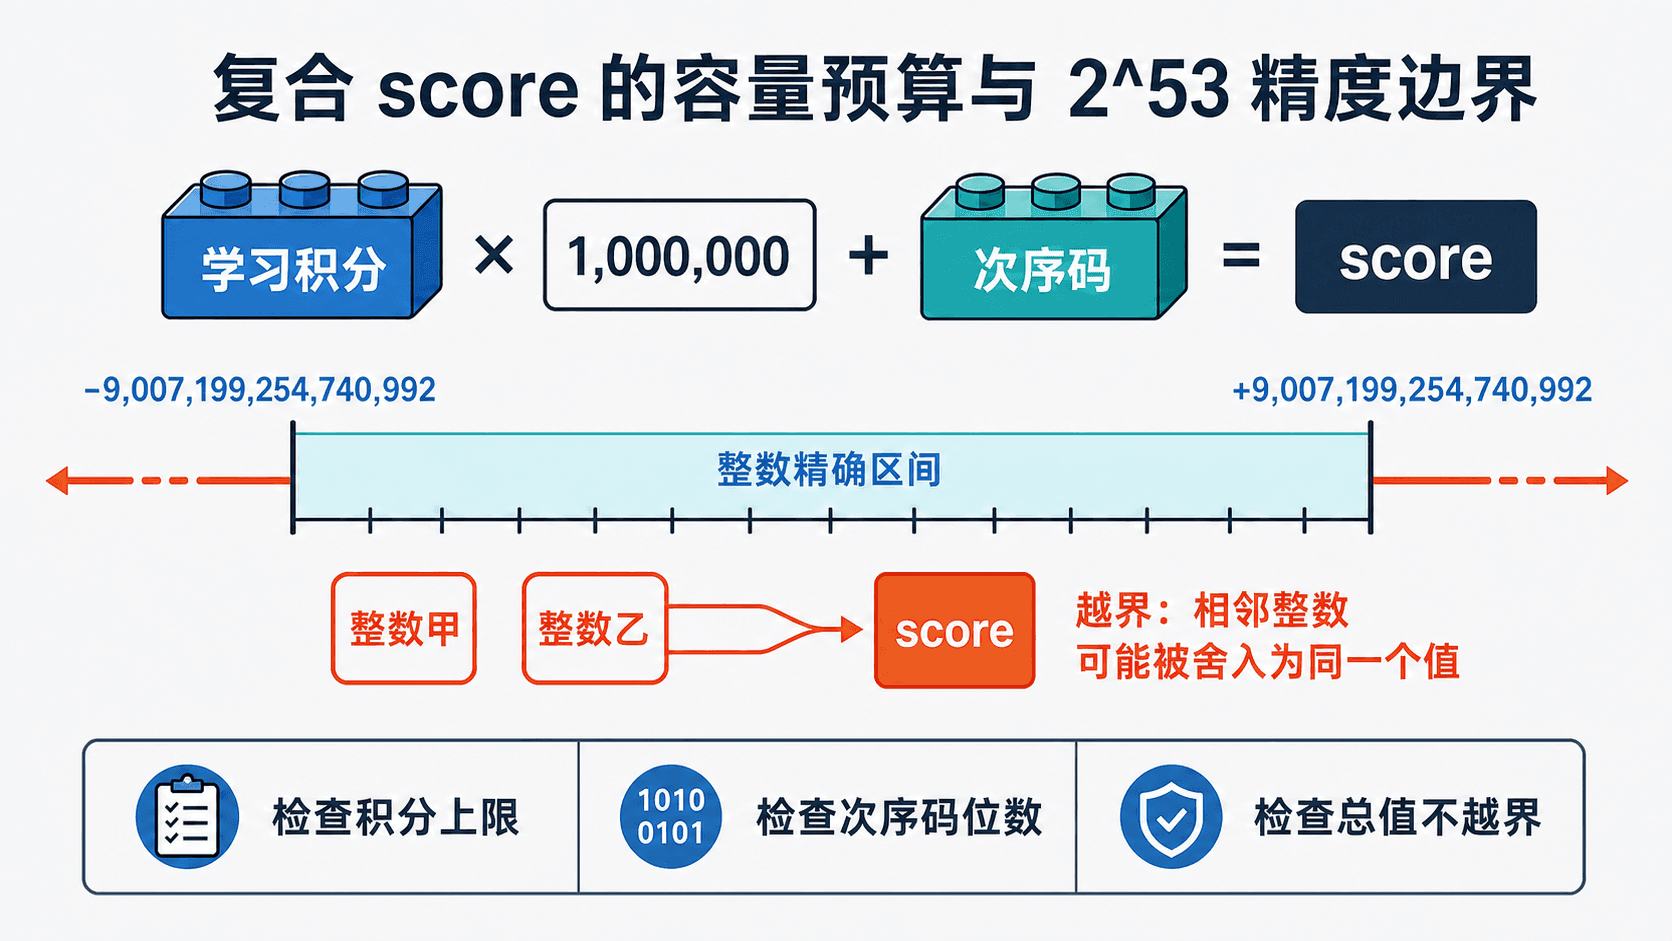
假设积分上限是 1000 万,B = 1_000_000,复合分数最大约为 10^13,仍在安全整数范围内。上线前不能靠“大概没问题”,应该把上界写成校验:
js
const TIE_BASE = 1_000_000;
const MAX_POINTS = 10_000_000;

function encodeScore(points, sequence) {
  if (!Number.isInteger(points) || points < 0 || points > MAX_POINTS) {
    throw new RangeError(
选 B 时同时检查三件事:次级值会不会超过预留范围,主分数最大值乘 B 后会不会越过安全整数边界,未来增加第三个维度时是否还留有空间。不要用一个随手写下的 10^10 乘毫秒时间戳;两者一乘,很容易在没有任何警告的情况下丢掉低位。
如果维度太多,别硬塞进一个 double。可以让 ZSet 只维护主排序,把 tie-break 元数据放在 Hash 或数据库中;读取一个有限候选区间后再做二次排序。代价是不能直接用一个 ZREVRANK 得到最终业务名次,但规则更容易解释,也不会被浮点精度偷走信息。
把时间写成小数尾巴也不天然安全。分数越来越大时,浮点数相邻可表示值的间隔也会变大,原先能区分的时间小数可能被舍入。只要排名需要审计,就应优先使用有明确上界的整数编码,并用 Number.isSafeInteger 和边界测试守住它。
一次加分还要经得起重试和乱序
真实接口里,“用户完成课程”往往不会同步执行一条 ZINCRBY 就结束。课程服务先确认学习记录,再发出积分事件;榜单消费者稍后接收事件并更新 Redis。消息系统通常保证的是至少投递一次:消费者更新成功,却在确认消息前崩溃,同一事件就会再次到来。如果每次收到都加 20 分,重复消息会变成重复积分。
最直接的补丁是在 Redis 里记已处理事件:
text
processed_rank_event:evt-8842 = 1消费者用 Lua 把“检查事件 ID、标记已处理、给用户加分”放在一次执行中。这个方案能关掉并发窗口,却还要回答两个问题:去重 key 保存多久,以及 Redis 故障恢复后去重记录是否仍然在。榜单要保留 45 天,去重 key 却只留 1 天,第二天重放旧消息照样会重复加分。把所有事件永久留在 Redis,又会让大量小 key 长期占内存。
更容易对账的设计是把积分流水放在数据库。event_id 有唯一约束,数据库事务同时写积分事件和待投影任务;消费者拿到某用户截至版本 37 的最终积分后,用 ZADD 设置绝对值。版本 37 重放十次,仍是同一个绝对分数。这时 Redis 是可重建投影,数据库能列出 u1001 的 1250 分由哪些事件组成。
绝对值写入又带来乱序问题。版本 38 先到,写成 1270 分;版本 37 后到,如果直接 ZADD,榜单会倒退到 1250。可以在同一个 Lua 中比较用户版本,只接受更大的版本:
lua
local oldVersion = tonumber(redis.call('HGET', KEYS[2], ARGV[1]) or '-1')
local newVersion = tonumber(ARGV[2])

if newVersion <= oldVersion then
  return {0, oldVersion}
end

redis.call('ZADD', KEYS[1
调用时,KEYS[1] 是榜单,KEYS[2] 是版本 Hash,ARGV 依次传用户 ID、投影版本和最终 score。Cluster 环境要让两个 key 使用相同 hash tag,例如 weekly_rank:{2026-W34}:scores 与 weekly_rank:{2026-W34}:versions,否则脚本无法跨 slot 执行。
这里还有一个常被忽略的失败顺序:Lua 已经更新 Redis,消费者却没来得及确认消息。事件重来后,版本判断会拒绝重复投影;反过来,消费者在执行前崩溃,消息仍会再次投递。两条路径都能收敛到版本 37。相比“希望消息别重复”,可重试才是能写进验收标准的性质。
如果榜单只是几分钟的临时互动,不需要审计,Redis 去重完全够用;如果榜单决定证书、奖品或权益,积分流水、规则版本、修正记录和结算记录就应该进数据库。系统复杂度不是由 ZSet 大小决定的,而是由出错后要不要解释和追回决定的。
实时榜翻页,本来就可能重复和漏人
Top 10 很简单:ZREVRANGE key 0 9 WITHSCORES。查自己也不难:先拿 ZREVRANK,再读取前后各两名。真正棘手的是排行榜页面的连续翻页。
假设第一页读取位置 0~9。用户准备读第二页时,原本第 15 名突然加分升到第 3 名,位置 3~9 的人都向后挪了一格。此时再按 offset 读取 10~19,第一页末尾的人可能重复出现;也可能有另一个用户掉到已读区间,之后再也读不到。Redis 没有算错,第二次查询面对的是另一版实时榜。
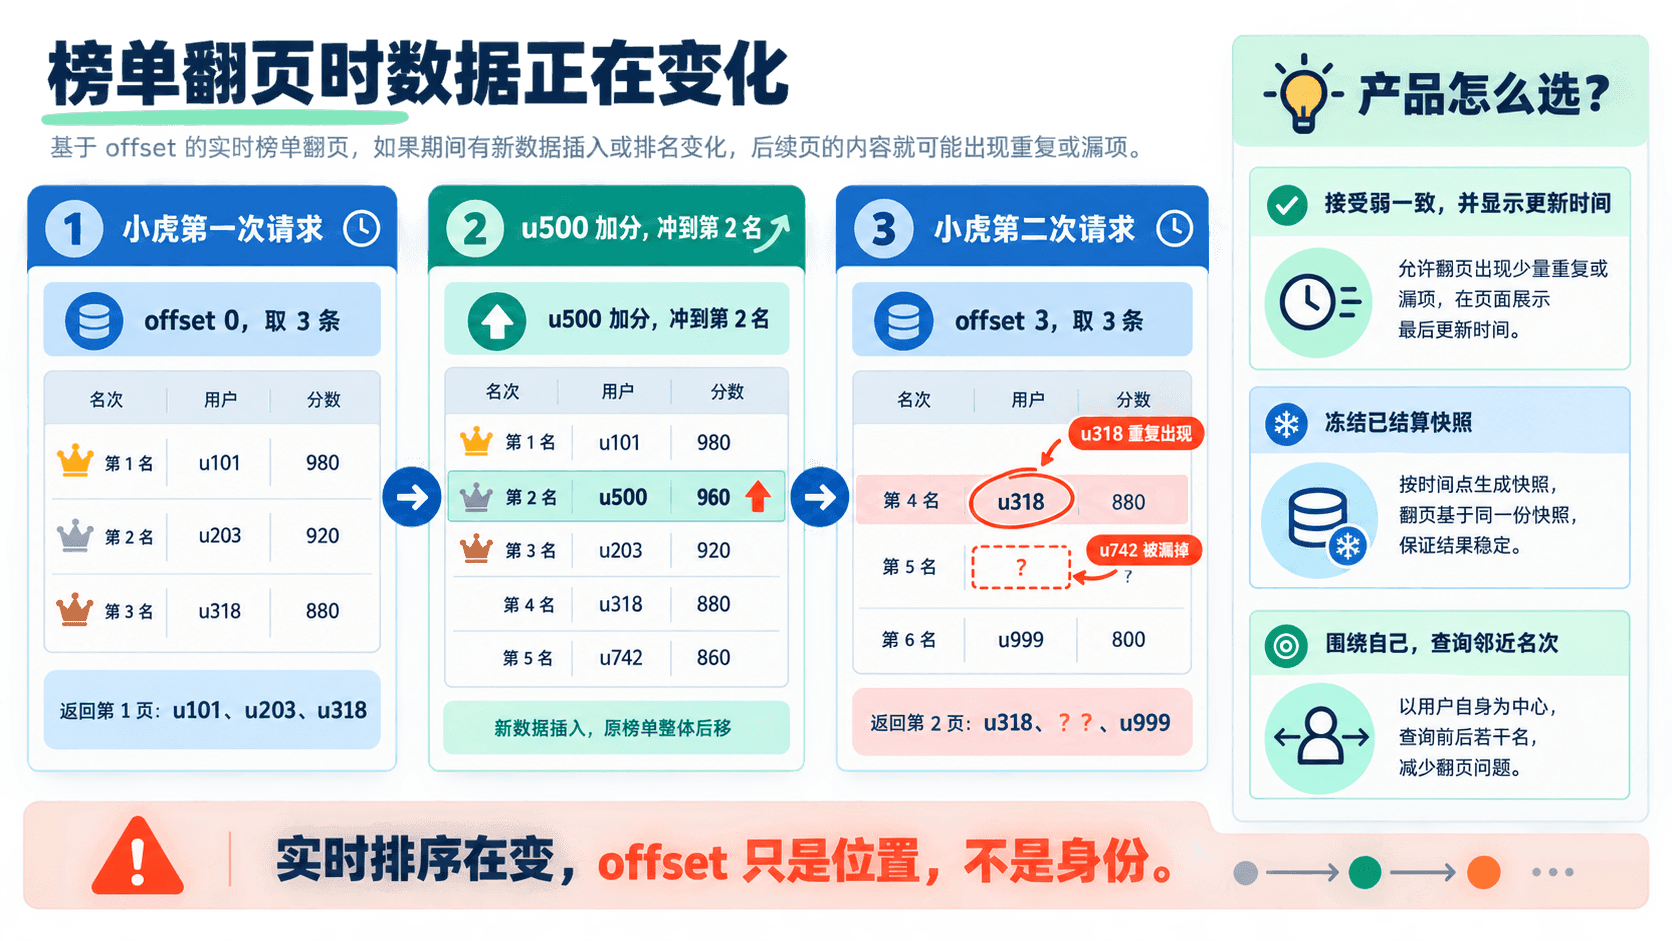
产品要先选择语义,而不是先选择分页参数:
- 实时浏览:每一页都读当前榜,允许轻微重复、漏读和名次跳动。活动大屏通常更在意新鲜度。
- 短期快照:打开页面时生成或引用一个版本,后续页都读同一快照。结算预览、运营审核更适合这种方式。
- 只看头部和“我附近”:不提供无限翻页,分别查询 Top N 与当前用户邻域。大多数学习活动的真实需求到这里已经满足。
用 score 当游标只能解决一部分问题。同分成员还需要把 member 一起放进游标,形成 (score, member),否则一整个同分组无法确定从哪里继续。更深的 LIMIT offset count 也不是免费的:offset 很大时,Redis 仍要越过前面的成员。排行榜有百万成员却开放“跳到第十万页”,通常是产品设计先制造了昂贵查询。
“我附近”可以这样实现:
js
async function getAroundMe(redis, key, userId, radius = 2) {
  const rank = await redis.zrevrank(key, userId);
  if (rank === null) return { rank: null, rows: []
这两次读取之间仍可能有人变分,导致名次与区间短暂不一致。需要同一瞬间视图时,把“查 rank + 查区间”放进 Lua 在同一 key 上连续完成;普通展示页往往可以接受这种短暂变化。
下面的模拟器专门演示分页漂移。先读取第一页,再让中间用户加分,最后读取第二页;切换到快照或“我附近”,可以直观看到不同读取语义的代价。
换榜、结算、归档和撤销要连成一条链
周一零点不能只做一句 DEL weekly_rank:2026-W34。删除会同时抹掉获奖依据,也挡不住迟到事件重新创建这个 key。更可靠的生命周期是“写入中 → 冻结 → 结算 → 归档 → 到期清理”。
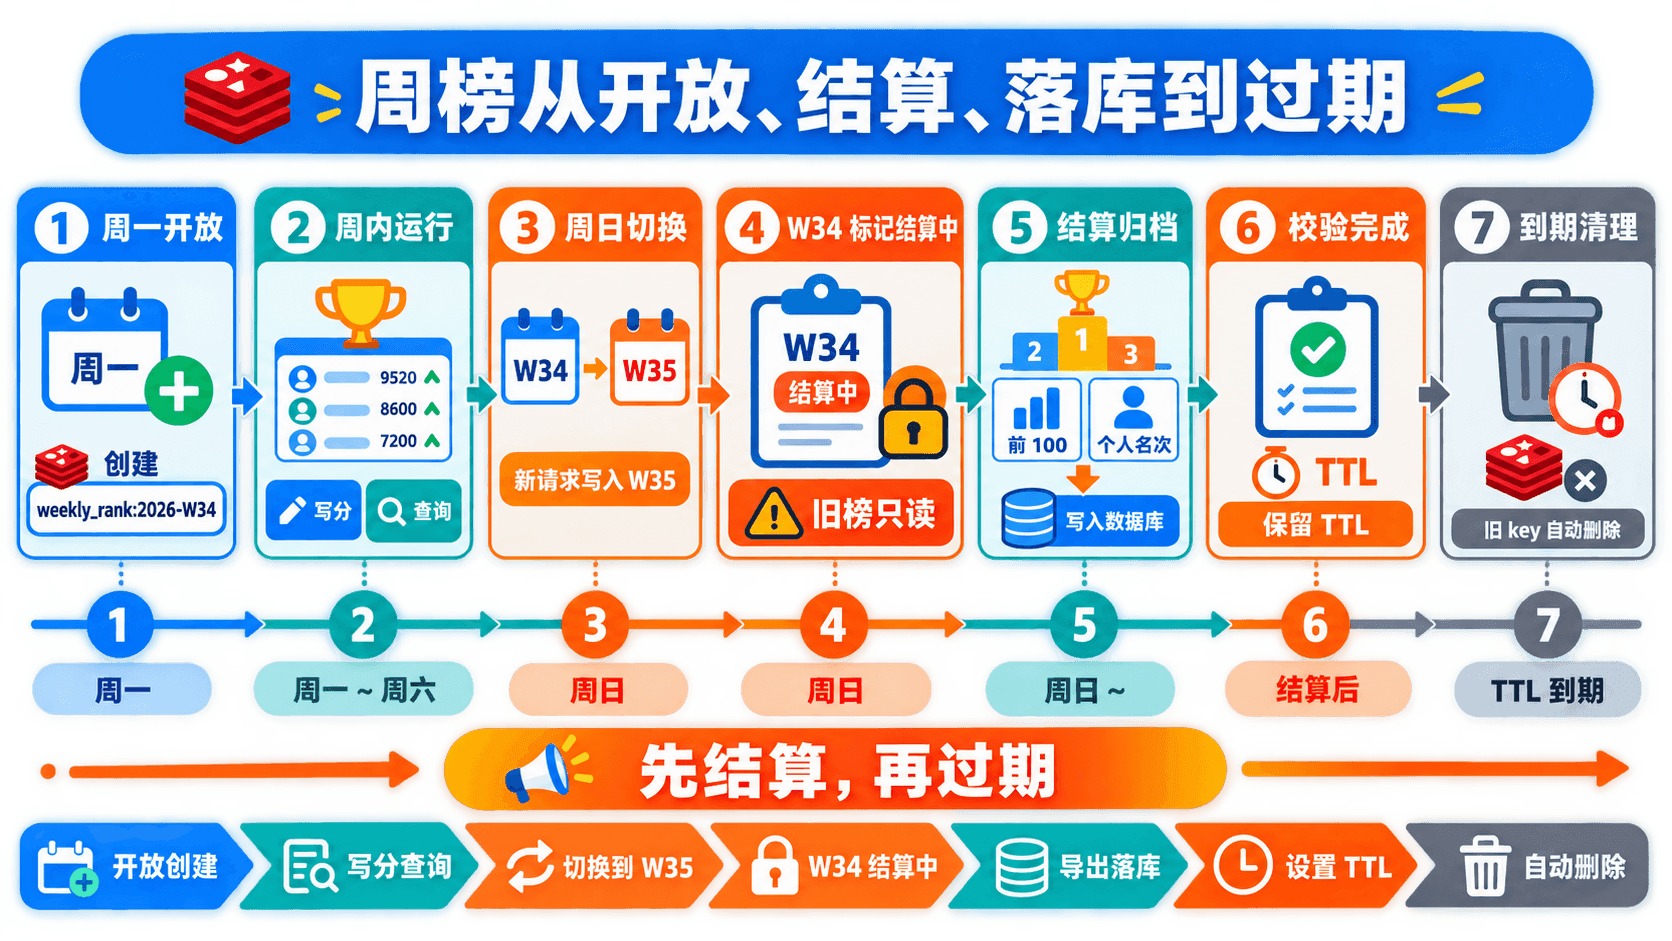
写入中,服务端根据活动时区和事件发生时间计算周标识。每条积分事件带唯一 eventId,先完成幂等判断,再更新本周原始积分与 ZSet 投影。
到达截止时间后,先把该周状态改成“冻结”。普通积分消费者看到冻结状态就不再写入;迟到事件进入待审核队列,而不是偷偷修改已公布名次。
结算任务读取冻结榜,保存获奖用户、最终原始分、tie-break 元数据和规则版本。结算写数据库时使用唯一的 settlementId,任务重跑也不会发两次奖励。
归档完成后给 Redis 榜单设置保留期,例如 45 天。长期审计读取数据库快照;Redis 只承担近期榜单展示,不承担永久凭证。
新周最好直接写新 key:weekly_rank:2026-W35。这样读写不会因为清空同一个 key 互相干扰,也能让旧榜继续展示。周标识必须由统一时区、统一周起点的服务端函数生成,并针对跨年周做测试,不能由浏览器字符串拼接。
撤销也要从事件出发。若 event-8842 曾给 u1001 加 20 分,审核后确认无效,就记录一条关联原事件的撤销流水,再对当前投影减 20。若撤销请求重试,唯一约束保证它只生效一次。简单原始分模型可以用 ZINCRBY key -20 u1001;复合分数模型则要重算原始分、达成序号和最终 score,不能直接在编码后的值上减 20。
人工修正尤其不能只在 Redis 控制台里改。控制台改完确实立刻见效,但数据库流水不知道发生过什么,下一次重建会把修正覆盖。正确顺序是先写带操作人、原因和关联用户的修正事件,再让同一条投影链更新榜单。
结算前复制一个正在变化的 ZSet,并不自动得到业务快照。复制开始和结束之间仍可能有新积分,而且“奖励已发放”也不在 ZSet 里。真正的结算点必须由业务状态门控,结算结果还要落入能审计、能幂等重试的持久记录。
多维榜单、Cluster 和热点榜各有边界
一个全国总榜、30 个省榜、数百个班级榜,看起来都可以复制同一套 key。这里要先区分“维度”和“分片”。weekly_rank:2026-W34:province:zhejiang 是浙江榜的业务维度;把全国榜成员按用户 ID 分到 16 个 ZSet,则是技术分片。前者每张榜都有完整含义,后者查询全国 Top N 时还要从 16 份局部 Top N 中归并,单次 ZREVRANK 也无法直接得到全局名次。
Redis Cluster 分的是 key,不会把一个巨大的 ZSet 自动拆到多个主节点。某张全国榜只有一个 key,它的所有更新和读取仍落在同一分片。只有不同周、地区、活动或课程形成不同 key 时,Cluster 才能把它们分散。不要为了“用了 Cluster”就以为热点榜已经横向扩展。
若一次 Lua、事务或 ZUNIONSTORE 要同时操作几张相关榜,这些 key 在 Cluster 中必须位于同一 hash slot。可以按业务范围使用 hash tag,例如:
text
weekly_rank:{course-redis}:2026-W34
weekly_rank:{course-redis}:2026-W34:bonus
weekly_rank:{course-redis}:2026-W34:final
花括号里的部分相同,它们会落到同一 slot,可以做多 key 原子操作;代价是这些 key 的负载也集中到同一分片。hash tag 是为了需要共同运算的数据,不是越统一越好。全国所有榜都写 {rank},等于亲手把整个 Cluster 压回一台主节点。
热点榜常见的优化顺序是:先缩小返回范围,给 Top 10 做很短的应用层缓存,再按榜单维度拆 key,最后才评估技术分片。排行榜更新频繁时,Top 10 缓存不必追求每次加 1 都立刻失效;明确允许 1~2 秒延迟,通常能显著减少重复范围查询。
读副本也要带着语义使用。Redis 的复制通常是异步的,写入主节点后立刻读副本,可能看到旧分数、旧名次,甚至暂时查不到新成员。ioredis 的 Cluster 读取默认发往主节点;若把 scaleReads 改成副本读取,就等于明确接受过期读。公共大屏可以接受几秒旧数据,“我刚完成任务后的积分结果页”则应读主节点,或者直接使用写入返回的新分数,并提示榜单稍后刷新。
上线前用故障问题验收
写完接口后,不要只测“加分后能排第一”。至少把下面这些场景跑一遍:
测试数据要固定,不要每次都用随机用户和当前时间。固定周次、固定事件 ID、固定达成序号,失败时才能直接比较期望顺序。测试结束后删除专用前缀,不要执行面向整个实例的 FLUSHDB。线上演练则应额外观察命令延迟、单 key 内存、读写吞吐和主从复制延迟;功能正确只说明规则实现对了,并不代表一张超大热点榜不会把所在分片压满。
每次修改排序规则后,都要用同一组回归数据重新跑一遍,避免旧榜与新榜采用不同口径。
- 同一个积分事件投递两次,最终只增加一次;撤销事件投递两次,也只减少一次。
- 两名用户同分,正序、倒序和分页后的顺序都符合已经写入产品规则的 tie-break。
- 复合分数分别测试 0、最大积分、最大序号以及
2^53附近,越界直接拒绝。 - 第一页读完后让第 15 名升到第 3 名,确认产品接受实时页漂移,或确实使用了快照。
- 周榜冻结后再送入迟到事件,历史榜不变化,事件能进入审核路径。
- 结算任务在保存结果后、发奖励前崩溃,重跑不会重复发奖。
- Redis 榜单被清空后,能从积分流水重建;数据库归档仍能解释某用户为何获奖。
- Cluster 环境中的多 key 脚本使用相同 hash tag;热点总榜的单分片 CPU、内存和延迟有单独监控。
- 开启副本读后,明确哪些页面能接受旧排名,哪些写后读链路必须回主节点。
做到这里,ZSet 才真正变成排行榜的一部分:它快速维护顺序,却不替你定义竞赛规则,也不替你保存积分证据。下一讲讨论分布式锁时,我们还会遇到同一个原则——Redis 能把一段操作做得很快、很原子,但业务正确性仍要靠完整的状态、期限和失败路径共同保证。