Python Traceback 怎么看?零基础逐行排错指南
看懂 Python Traceback:从最后一行异常到第一处用户代码,结合三层调用示例、四步排错流程、最小复现错误卡与修复验证清单。
自在学约 6 分钟阅读
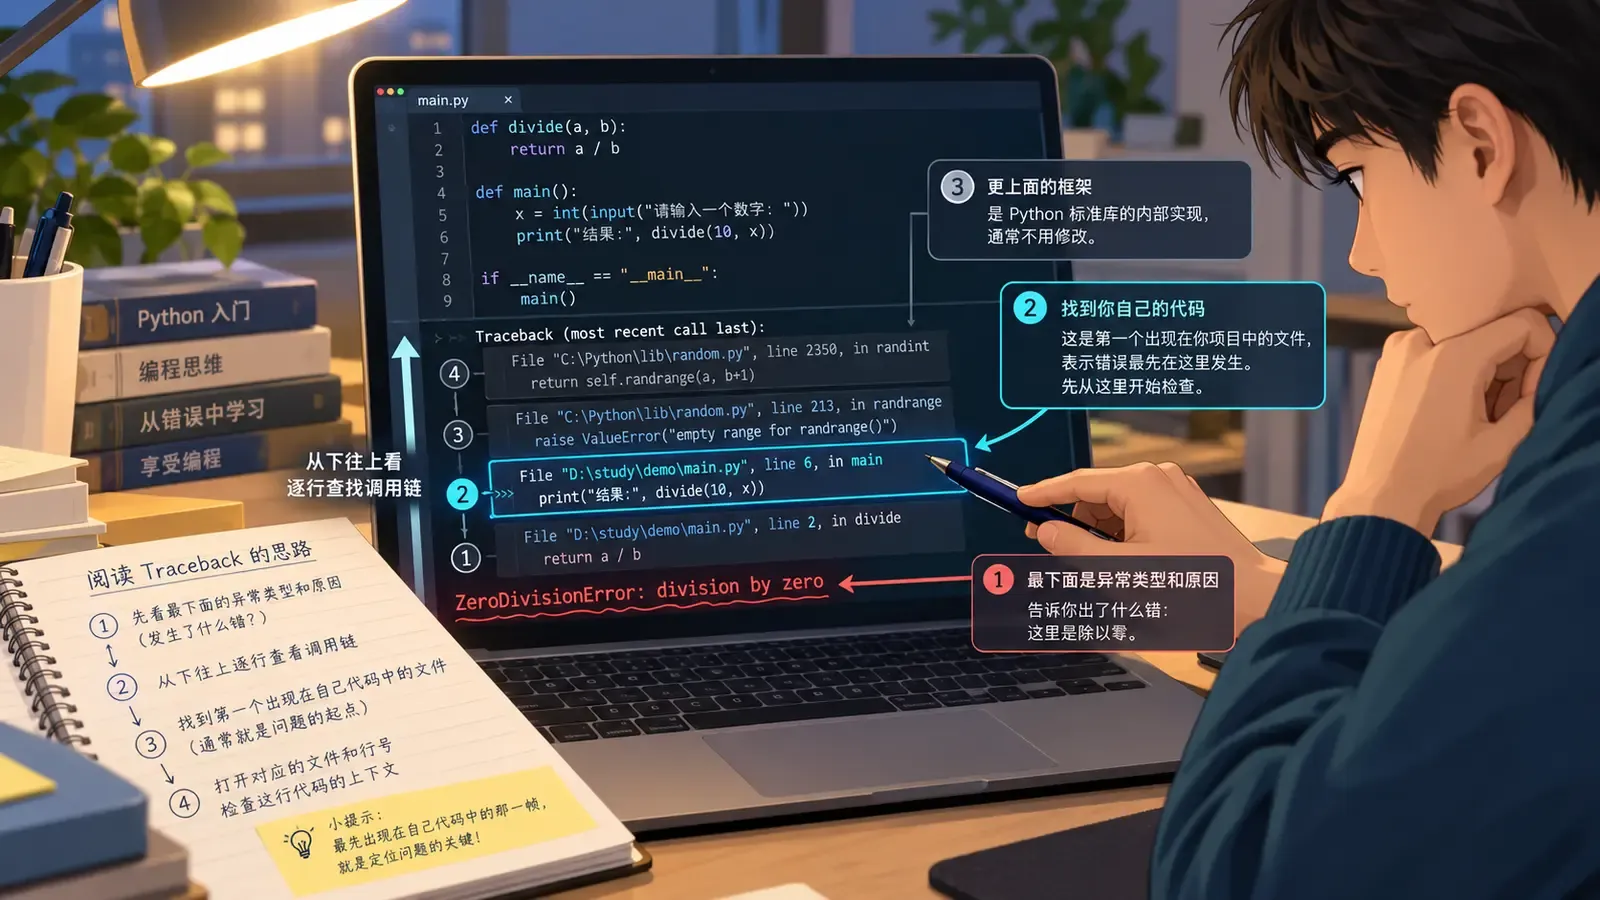
Python Traceback 怎么看?从最后一行到第一处自己代码的排错方法
第一次看到十几行红字,很容易从第一行硬读到最后,或者整段复制给 AI。更有效的顺序恰好相反:先读最后一行,确认异常类型和消息;再沿调用栈寻找属于自己项目的代码。 Traceback 不是一串互不相关的错误,而是程序到达出错位置的路线图。

Traceback 是什么,什么时候会出现
Python 在运行中遇到异常,如果异常一直没有被处理,通常会停止程序并打印 Traceback。根据 Python 官方“错误和异常”教程,回溯会展示异常发生时的调用上下文;traceback 模块文档则说明,该模块可提取、格式化和打印栈回溯信息。
先区分三类问题:
所以,“没有 Traceback”不代表没有 bug;“出现 Traceback”也不代表每一帧都是一个错误。内置异常的含义可查 Python 官方内置异常列表。
用一个三层调用示例读懂完整 Traceback
把下面代码保存为 scores.py 并运行 python scores.py:
python
def parse_score(text):
    return int(text)


def add_score(total, raw_score):
    return total + parse_score(raw_score)


def build_report():
    total = 0
    for raw_score in ["88", "缺考", "76"]:
        total = add_score(total, raw_score)
    return total


print(build_report())
输出如下:
text
Traceback (most recent call last):
  File "scores.py", line 16, in <module>
    print(build_report())
          ^^^^^^^^^^^^^^
  File "scores.py", line 12, in build_report
    total = add_score(total, raw_score)
            ^^^^^^^^^^^^^^^^^^^^^^^^^^^
  File "scores.py", line 6, in add_score
    return total + parse_score(raw_score)
                   ^^^^^^^^^^^^^^^^^^^^^^
  File "scores.py", line 2, in parse_score
    return int(text)
           ^^^^^^^^^
ValueError: invalid literal for int() with base 10: '缺考'
不同 Python 版本可能不显示波浪线或插入符,但文件、行号、函数名与最后的异常信息仍是阅读重点。
先看最后一行:异常类型与消息
ValueError 是异常类型;后面的消息说明 int() 无法把 '缺考' 按十进制整数解析。此时先形成一个可验证的假设:输入里混入了非数字文本。不要一上来改四个函数。
再看头部与每个 frame
Traceback (most recent call last): 是回溯头部;most recent call last 表示下方越来越接近异常实际抛出的位置。
每组 File ... 加下一行源码就是一个 frame,也就是调用发生时的一层执行现场:
line 16, in <module>:脚本顶层调用build_report(),调用链从这里开始。line 12, in build_report:循环把当前的raw_score传给add_score()。line 6, in add_score:函数继续调用parse_score(raw_score)。line 2, in parse_score:int(text)真正抛出ValueError。
缩进的源码行告诉你该 frame 当时执行了什么;插入符尽量指出表达式中的相关位置。frame 顺序描述的是“谁调用谁”,最后一行描述“最终发生了什么”。

第一处自己代码,不一定是最底下那一帧
本例所有 frame 都在 scores.py,最接近异常的用户代码是第 2 行。真实项目里,最底部常常位于 site-packages、框架或标准库。例如依赖库内部因你传入错误类型而抛出异常,依赖库最后一帧是异常发生点,却不一定是根因。
实用定位法是:
- 先读最后一行,理解异常类型和消息。
- 从靠近底部的位置向上看,找到第一处属于自己项目的文件。
- 检查该行传给下一层的参数、变量类型、边界值和前置条件。
“第一处自己代码”是优先调查点,不是自动判决。若这里的输入正确,再继续看依赖版本、API 约定或更上游的数据来源。
四步排错流程:从红字到可验证修复
第一步:复现并保留完整报错
记录运行命令、Python 与依赖版本、输入和完整 Traceback。不要只截最后一句,也不要在尚未复现时凭印象改代码。重复运行一次,确认是稳定失败还是偶发问题。
第二步:读异常并定位用户 frame
先解释最后一行,再在栈中圈出自己项目的文件与行号。回到该行查看实际变量,而不是只看变量名。本例可临时加:
python
print(repr(raw_score), type(raw_score))
total = add_score(total, raw_score)
repr() 能让空字符串、换行符等不易察觉的内容更明显。输出确认是 '缺考' 后,再决定它应被跳过、转为缺失值,还是在输入端拒绝。
第三步:缩小输入,做最小复现
把几十个输入缩成仍能失败的最小集合:
python
print(parse_score("缺考"))若这行仍得到同类 ValueError,问题已经从三层业务流程缩小到“非数字文本如何处理”。最小复现的价值不是让代码看起来短,而是排除无关因素。
第四步:一次只改一处,再做三类验证
假设规则是“缺考不计入总分”,可先让解析函数明确处理它:
python
def parse_score(text):
    if text == "缺考":
        return 0
    return int(text)
一次只改一处,随后运行:原失败用例 "缺考"、正常用例 "88",以及边界用例,如空字符串、"0"、"100"。注意:把缺考算作 0 是否符合真实规则,需要由需求决定;示例只展示验证方法。

最小可复现错误卡:复制后直接填写
这张卡能防止“只有一句报错、没有上下文”,也便于你自己回看排错过程。
markdown
## 最小可复现错误卡
- Python 版本:
- 依赖及版本:
- 操作系统/运行环境:
- 运行命令:
- 最小代码:
- 最小输入:
- 完整 Traceback:
- 预期结果:
- 实际结果:
- 已尝试的方法及结果:
- 本次只修改了什么:
- 验证结果:
  - 原失败用例:
  - 正常用例:
  - 边界用例: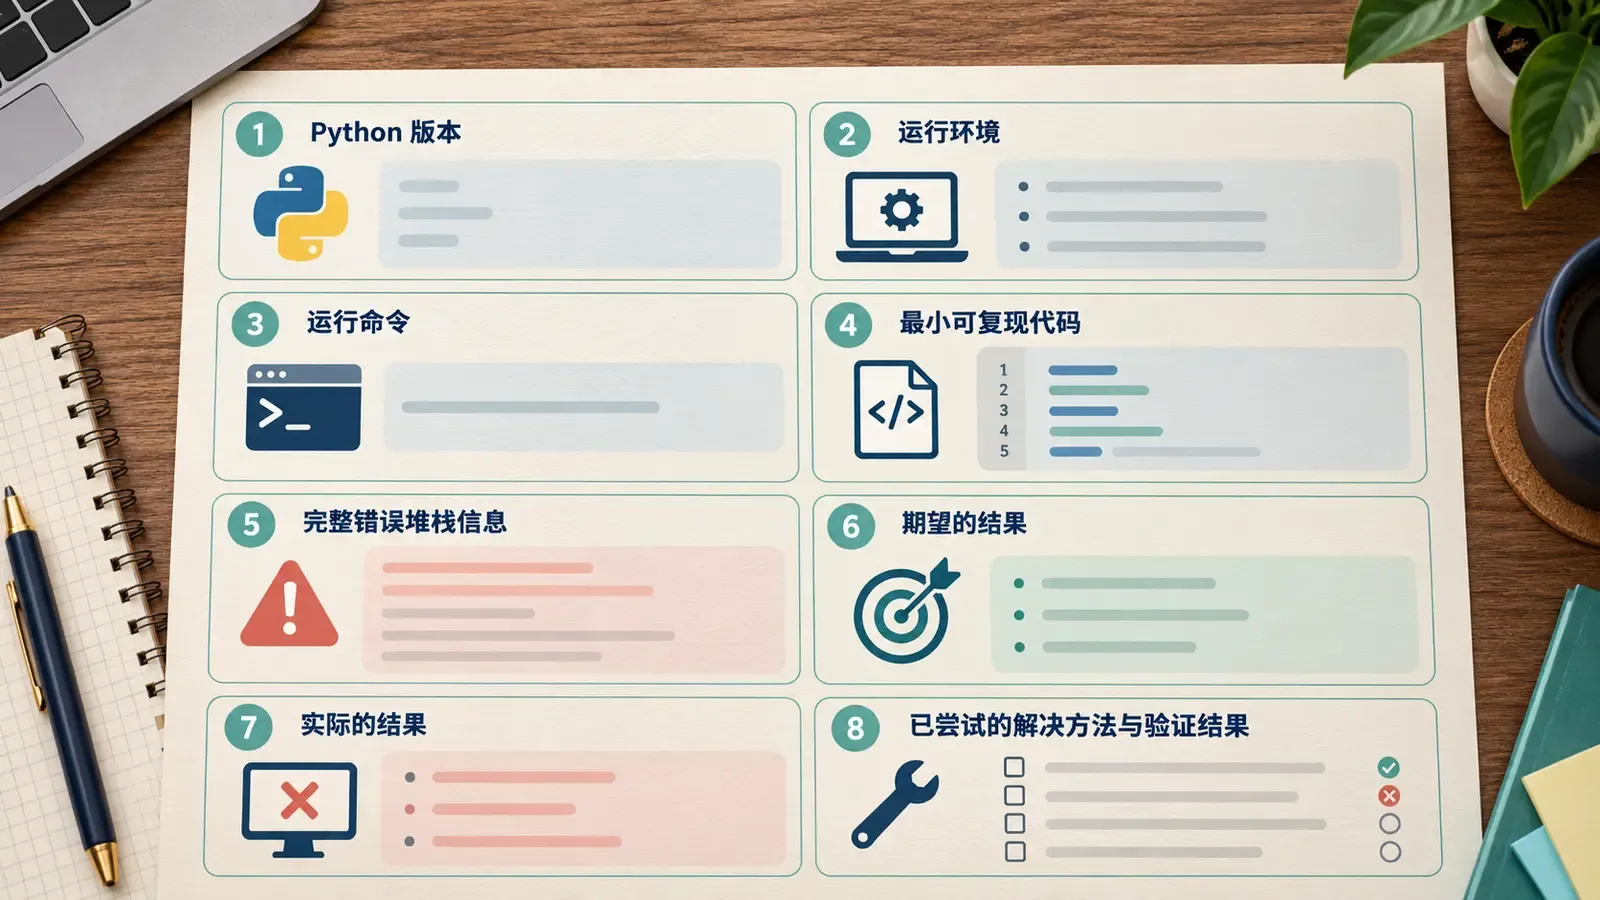
若想把错误卡积累成可复习材料,可参考错题本整理方法;重点是记录“错误假设—证据—修复—验证”,而不是只收藏答案。
什么时候用 print,什么时候用 breakpoint 或 pdb
零基础排错,print(repr(variable), type(variable)) 往往够用。适合检查少量关键变量、确认分支是否执行、验证输入在哪一步变形。记得修复后删除临时输出,避免日志混乱。
当问题依赖循环中的某一次迭代、多层状态变化,或你需要暂停后连续检查多个变量时,可在可疑行前加入:
python
breakpoint()程序会进入交互式调试器。常用命令包括 p variable 查看变量、n 执行下一行、s 进入函数、c 继续运行、q 退出。根据 Python 官方 pdb 文档,pdb 支持断点、单步执行、查看栈帧和在帧上下文中求值。
pdb 不是每次报错的必需步骤。若最后一行已经明确指出文件、行号和错误输入,先用阅读 Traceback 与最小复现解决;只有静态文本不足以解释“变量如何走到这里”时,再暂停执行观察状态。
向 AI 求助,但不要把调试外包
提交前先删除 API 密钥、密码、Token、真实姓名、绝对路径、客户数据等敏感信息,并用假值保留数据结构。然后提供最小代码、完整 Traceback、环境版本、预期与实际结果。
可以这样问:
请先解释最后一行异常,再按优先级列出 3 个排查步骤。指出我应检查的第一个用户代码 frame、每一步要观察的变量,以及修复后该运行哪些失败/正常/边界用例。不要直接重写整个文件。
AI 给出的原因只是候选假设。你仍要在自己的环境中运行、观察并核验;若建议同时改了多处,应拆开测试。想进一步建立“提问—验证—复盘”的学习闭环,可阅读 AI 编程学习工具指南 和 AI 自主学习方法。

修复完成前的验证清单
- 原来的命令和输入不再失败,结果符合明确规则。
- 至少一个正常用例仍通过,没有因修复旧问题破坏常规路径。
- 空值、零、最大值或错误类型等边界输入有明确行为。
- 临时
print()、断点和测试密钥已经移除。 - 没有用宽泛的
except Exception: pass把问题静默吞掉。 - 错误卡记录了修改点与验证结果,之后能复现结论。
常见问题
通常先读最后一行的异常类型和消息,再从栈底附近向上寻找第一处属于自己项目的代码;最后结合上方 frame 理解调用路径。不是机械地只按一个方向读。
最后一行说明异常类型与直接消息,但不保证揭示上游根因。例如依赖库最后抛出 TypeError,真正原因可能是你的代码传错了参数。把异常消息和第一个用户代码 frame 一起检查。
结语
读 Traceback 的核心动作很短:最后一行定方向,用户 frame 找入口,最小复现去干扰,单点修改后用三类用例验证。 练几次后,多行红字会从“看不懂的错误墙”变成一条可追踪的路线。如果仍卡住,可以让 AI 学习助手帮助解释异常和设计验证步骤,但定位证据、运行代码与确认结果应始终由你完成。