老师如何匿名分析班级错题?从脱敏表到教学动作的完整流程
删除可识别信息,生成班级错误矩阵,经教师抽样复核后,把结果转成全班重教、临时小组补救和个别支持动作。
自在学约 6 分钟阅读
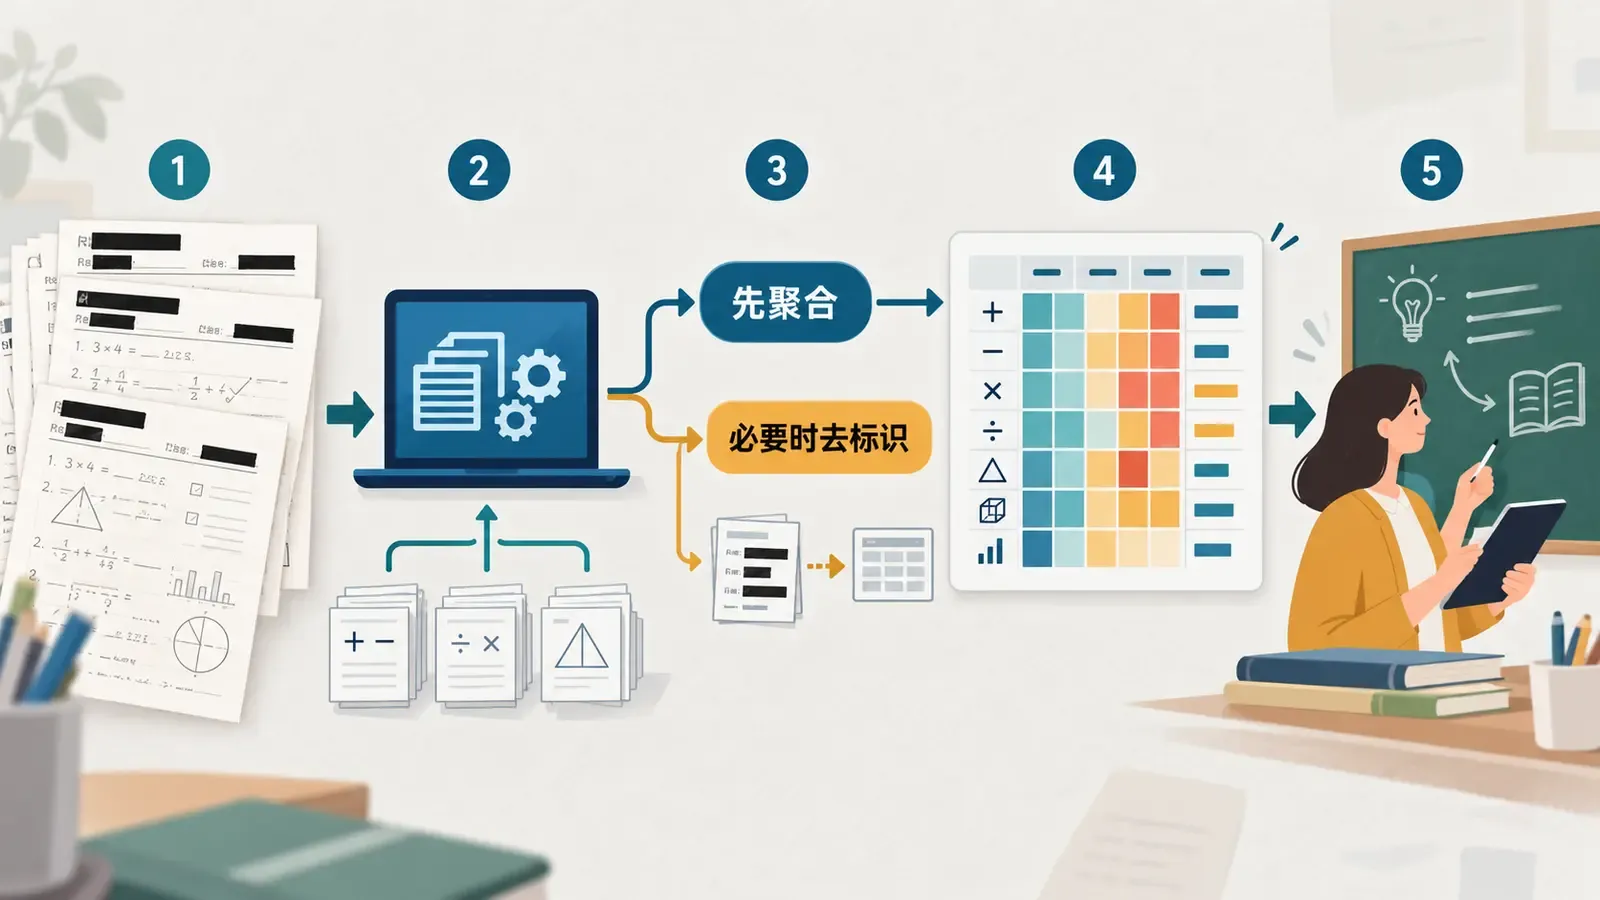
先说结论:匿名分析的关键不是把姓名换成编号后整表上传,而是只用完成教学决策的最少数据。多数情况只给 AI“题目 × 错误类型”的班级汇总表;确需观察跨题错误时,才用随机临时 ID,映射表留在本地。这里的“匿名分析”是便于检索的通俗说法:只要映射表仍存在,随机临时 ID 只是去标识化,不等同于法律意义上的匿名化。AI 提出假设,教师抽样核验,再按“错误人数、严重度、是否阻塞后续学习”决定整班重教、临时小组或个别支持,并用下一次退出条或小测复验。
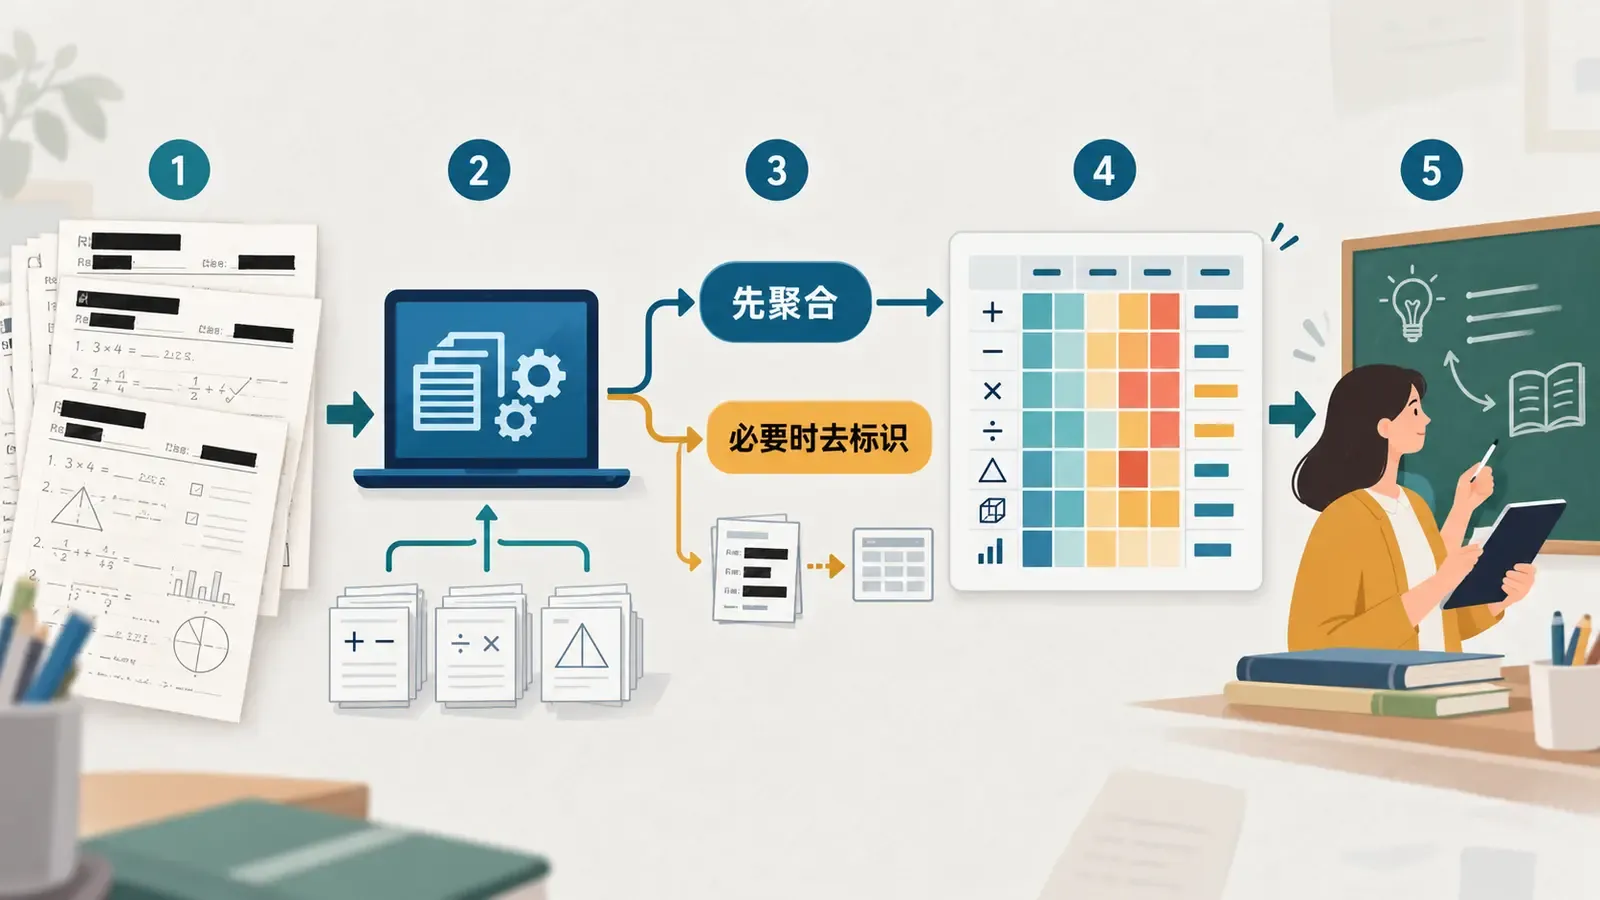
这套流程与官方方向一致:《教师生成式人工智能应用指引(第一版)》允许用脱敏班级作业、测验数据辅助诊断,并要求删除姓名、家庭信息、审查工具隐私政策、教师核查生成内容。教育部等五部门《“人工智能+教育”行动计划》支持学情分析,也强调安全、可信、可控并防范隐私泄露。本文不构成法律意见;实际操作应遵守学校制度、工具条款和适用法律。
第一步:先决定是否需要“学生级行”
先写下本次问题,例如:“下一课要重教哪两个概念?”如果只需找全班共性,直接在本地统计每题各类错误人数,不保留任何学生 ID。只有以下情况才可能需要去标识学生行:判断多个错误是否总在同一批作答中出现、组建短期补救小组、跟踪一次干预后的变化。
能聚合就不上传明细,能用错误类别就不上传原答案。尤其不要上传姓名、学号、座位号、家长联系方式、家庭情况、评语、头像、原卷扫描件或带手写特征的照片。《个人信息保护法》要求处理个人信息具有明确、合理目的并限于最小范围;不满 14 周岁未成年人的个人信息属于敏感个人信息,应采取严格保护措施。
班级错题最小数据表
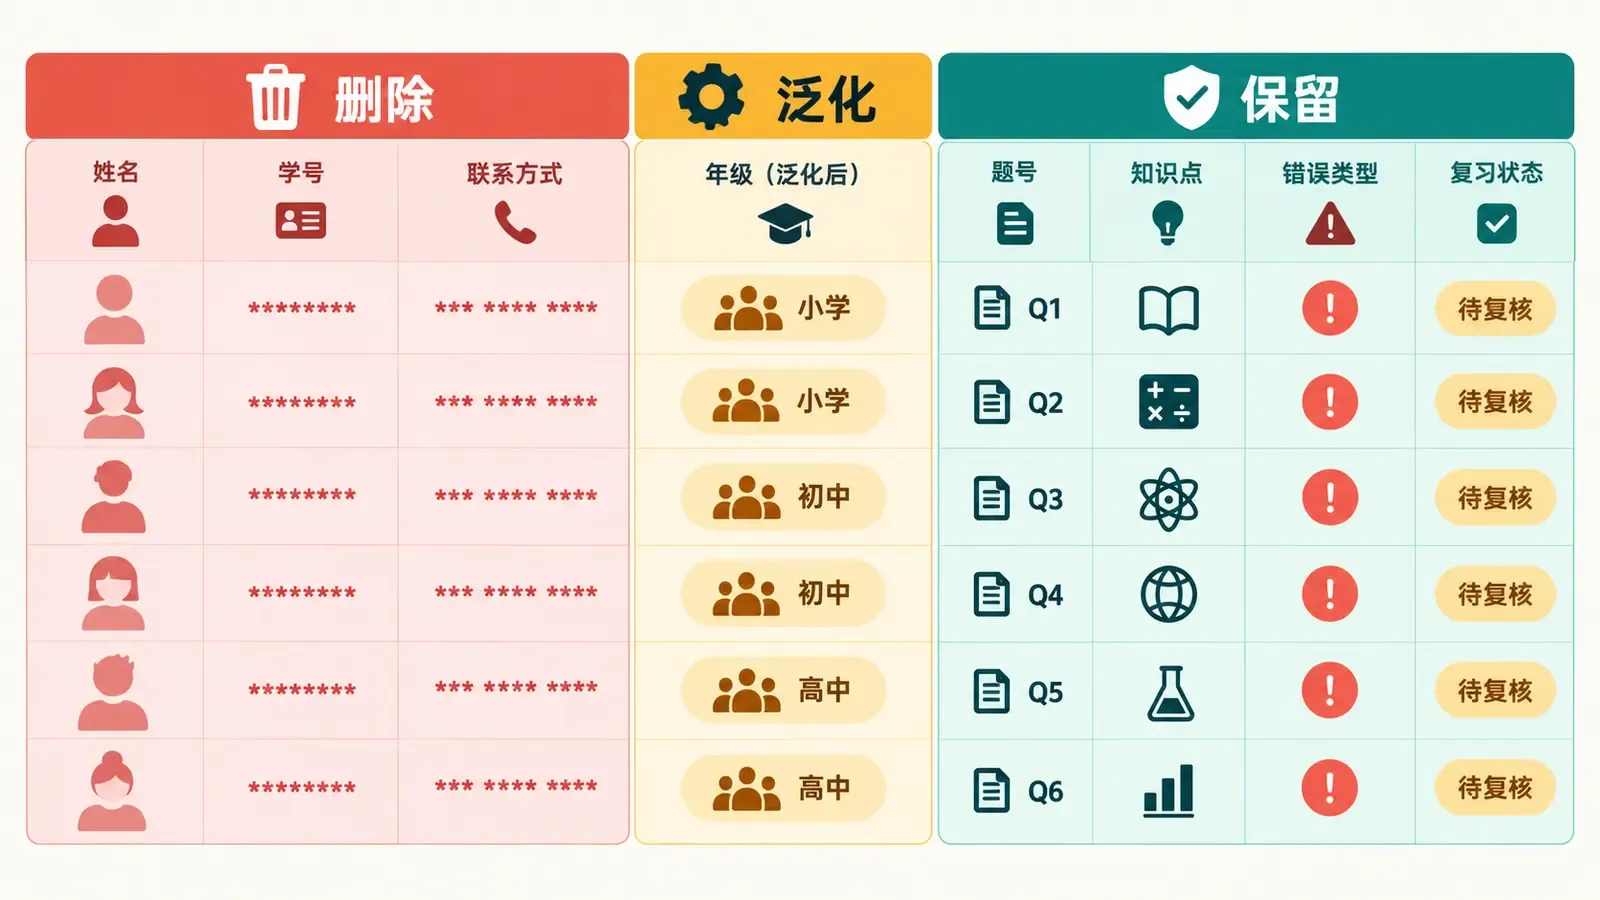
随机临时 ID 应在本地生成。映射表单独存放在学校批准的受控位置,不与分析表同文件、不上传 AI;复验后按校规删除。不要用座位号、学号或姓名首字母。
第二步:在本地生成错误矩阵
先由教师定义少量、可观察的错误标签,并保留“未知/待复核”,不要强迫每份答案归类。以下为一个虚构的 32 人数学测验示例,仅演示流程,不代表效果数据。
这里的“教师核验错误标签”来自评分标准和教师看卷;AI 后续提出的“可能是概念混淆”等必须另列为“AI 假设”,不能改写成事实。
第三步:让 AI 只做模式归纳
把上面的聚合表和教学目标提供给已获学校允许、隐私条款经过审查的工具。可直接复制下面的提示词:
text
你是教学分析助手。以下仅为聚合数据,或在确有必要时使用的去标识数据。
任务:
1. 按错误人数、影响严重度、是否阻塞后续学习三轴排序;
2. 区分“表中已有的教师核验标签”与“你的假设”;
3. 不推断学生身份、能力、动机、家庭背景或长期画像;
4. 对证据不足处标为“未知/待复核”,列出需教师查看的证据;
5. 给出下一课可执行的整班、临时小组、个别支持建议;
6. 不做最终评分、排名、处分或学生定性。
请用表格输出:优先级|已知证据|AI假设|需复核样本|建议动作|复验题。

[粘贴聚合错误矩阵,或确有必要时使用去标识错误矩阵]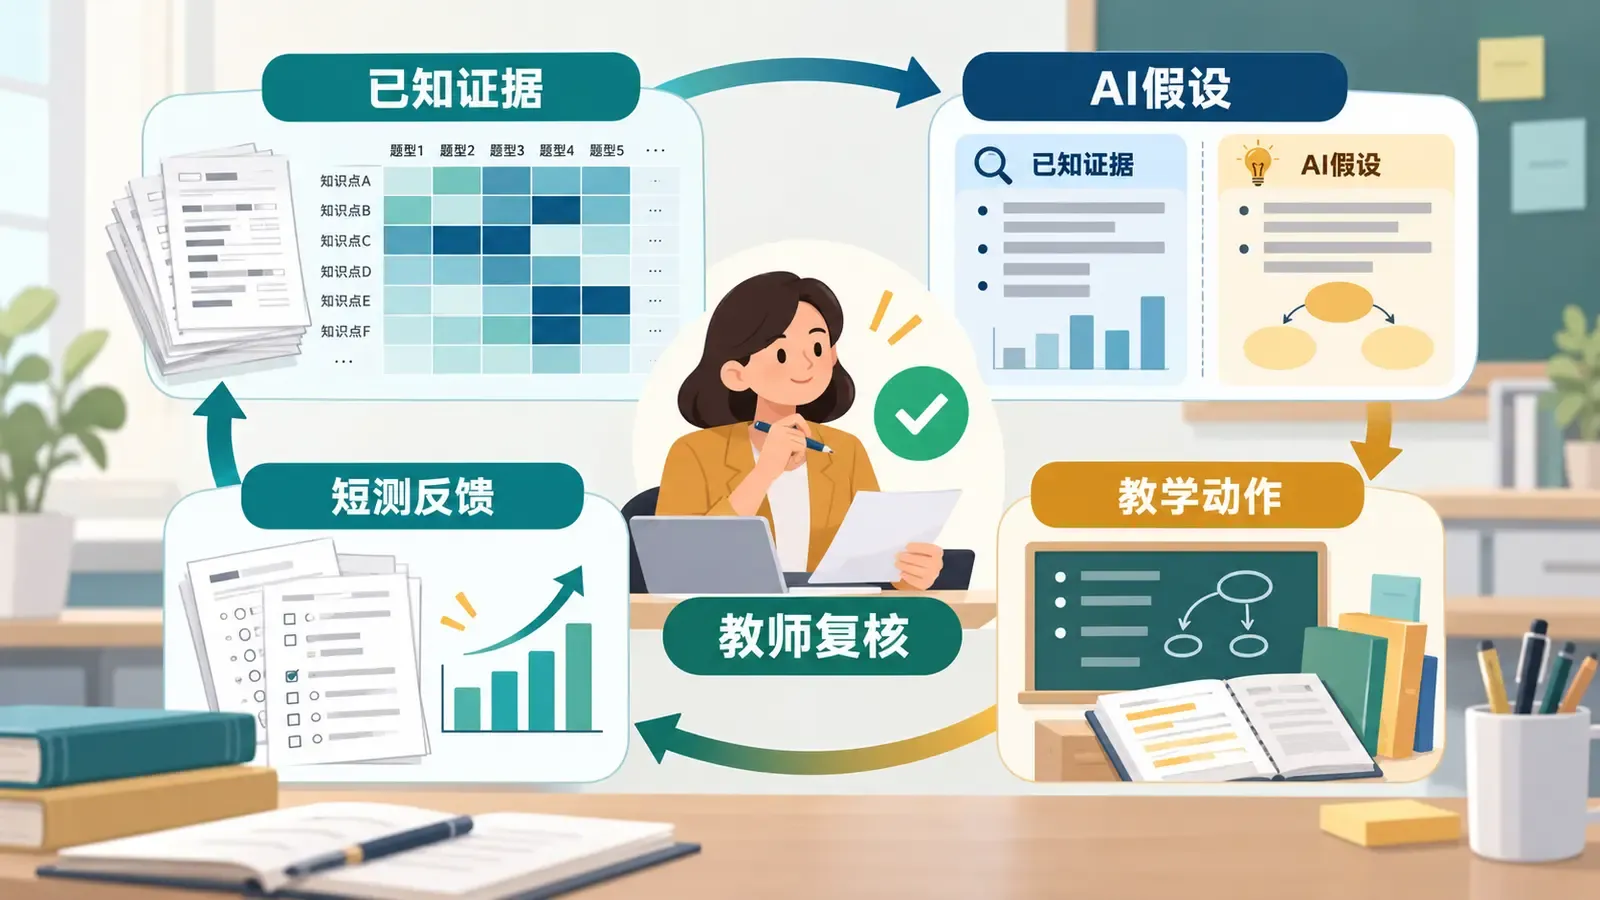
第四步:抽样复核,开放题重点回查
每个高优先错误可在本地抽查 3—5 份,包含典型错例、边界例和正确答案;样本差异大或结论将影响个别支持时再扩大抽查。AI 只看到“样本 A、B、C”的去标识摘录,教师在本地用映射表找原卷,身份不交给 AI。
开放题更容易被误判。先用教师量规核对“观点、证据、推理、表达”,允许多种正确路径;AI 与教师不一致时,以教师对课程目标和原作语境的判断为准,并把类别改为“待复核”。不得把 AI 输出直接作为最终分数、处分依据、排名或个体画像。
何时不用 AI:样本很小;数据无法可靠脱敏;工具未经学校批准或隐私条款不清;任务涉及心理、健康、家庭困境、处分或高利害评价;错误标签尚未定义。此时用电子表格或人工计数。
第五步:把证据路由成教学动作
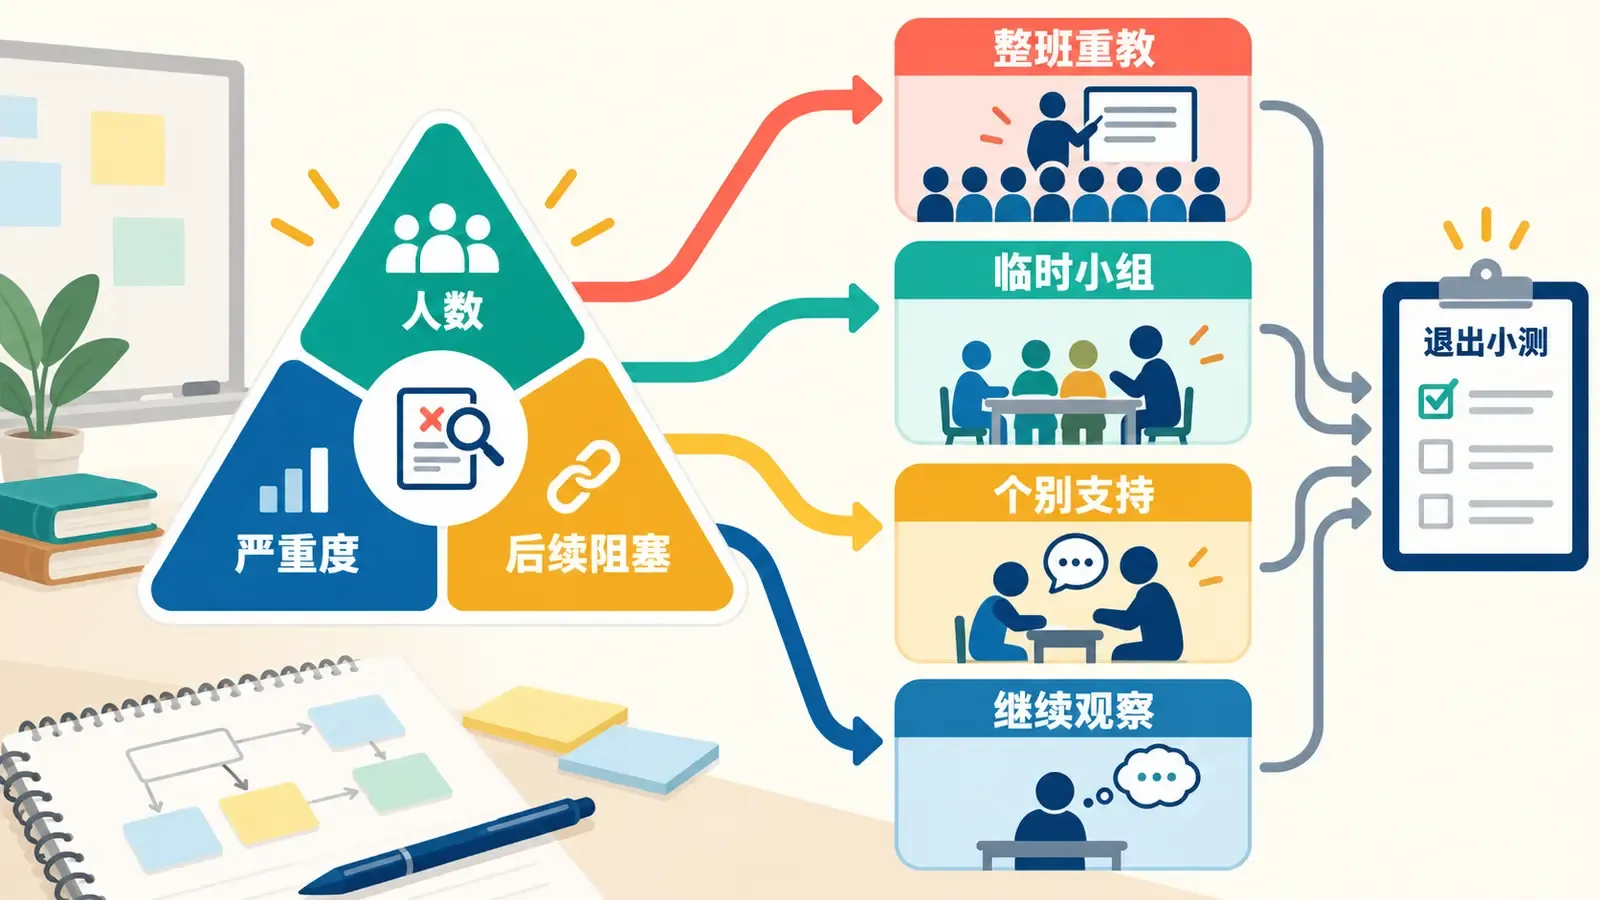
三轴判断:人数多且阻塞后续学习,整班重教;人数较少但模式一致,建临时小组;极少数独特或持续错误,教师本地识别后个别支持。严重度高但人数少,也不能忽略。
在示例中,Q2 和 Q3 应先进入整班重教候选;Q4 可按回查结果组成临时小组;Q1 只需常规提醒;Q5 因待复核较多,先人工检查量规一致性,不宜立即归因。若要进一步把匿名错误转成分层练习,可衔接差异化作业设计流程;若要把“证据—差距—动作—复核”写进学生反馈,可参考有效课堂反馈指南。
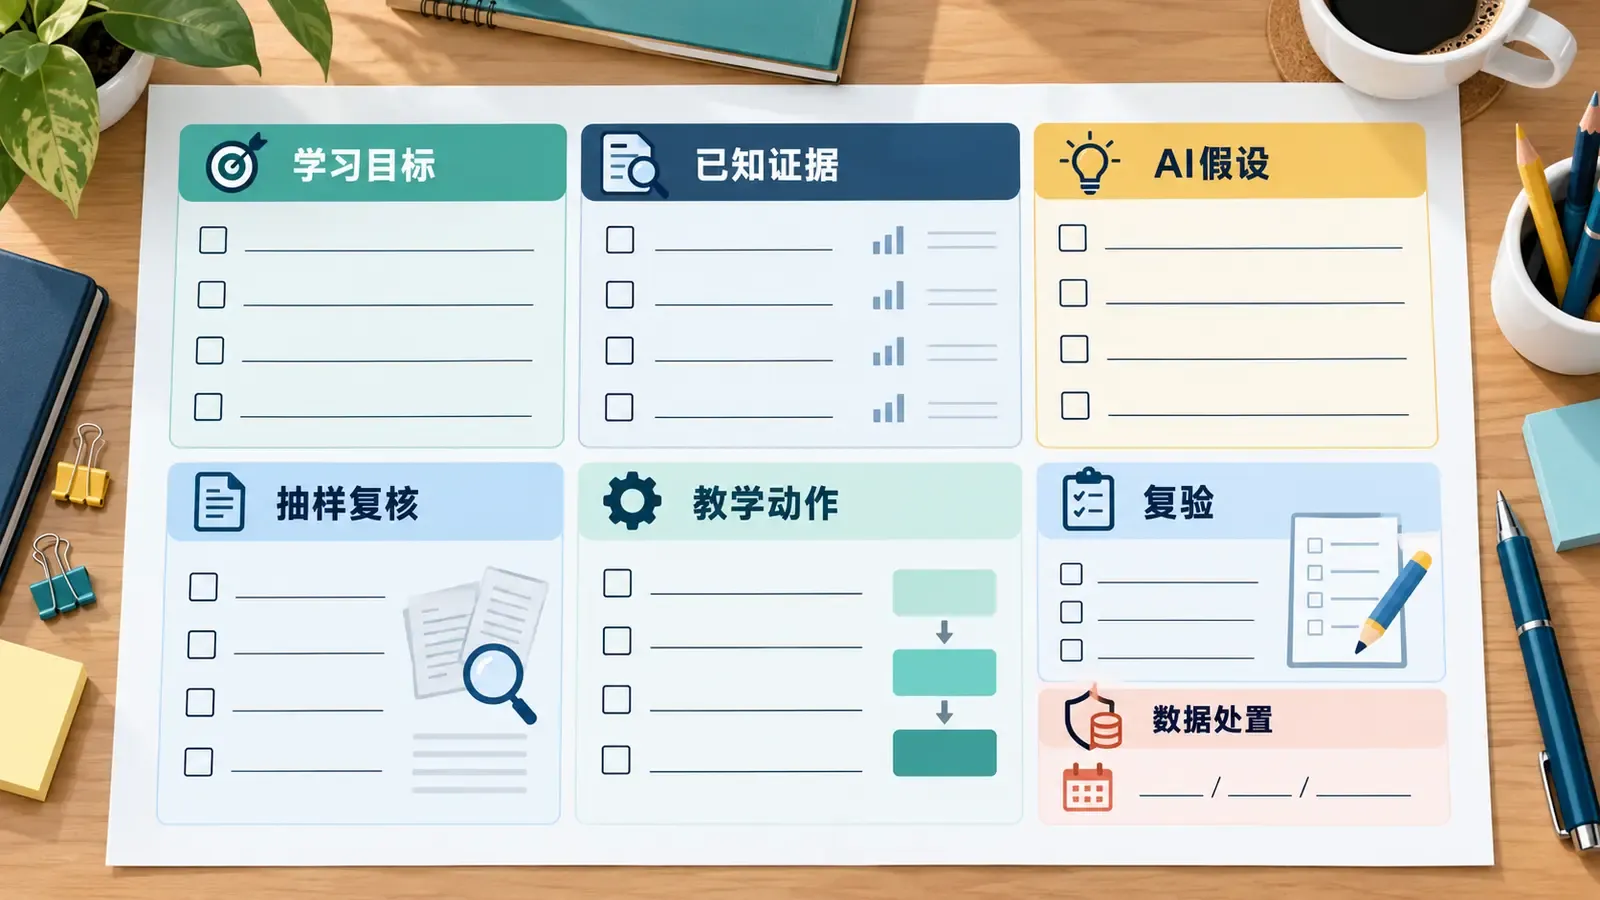
可复制教学动作卡
text
学习目标:
已知证据(只写教师核验数据):
AI 假设(可为空):
抽样复核:典型错例__份/边界例__份/正确例__份
优先级:错误人数__;严重度__;阻塞后续:是/否
教学路由:整班重教/临时小组/个别支持/暂不干预
下一课动作(时长、材料、教师提问):
成功标准:
复验:退出条/小测;日期__;题目__
复验结果:达标__人;仍需支持__人;下一步__
数据处置:映射表与临时文件删除日期__
课末用 1—3 道退出条复验同一目标,但更换数字或情境。比较班级错误类型是否下降,而不是让 AI 给学生贴标签。可参考课堂退出条设计指南。课堂音视频属于另一类风险与权限问题,应转看AI 课堂观察工具指南。
常见问题
通常不算。学号、座位号仍可能指向个人。优先聚合;确需跨题关联时才用随机临时 ID,映射表留在本地。
默认不要。扫描件可能含姓名、笔迹和批注。先在本地提取题号、错误标签和人数。
真正有价值的输出不是一份看似精确的 AI 报告,而是一张经过教师核验、能在下一课实施并可复验的教学动作卡。先从最近一次小测选一个学习目标,用聚合矩阵跑完这一闭环,再决定是否需要更细的数据。